Chỉnh sửa âm thanh
ThinkSound AI
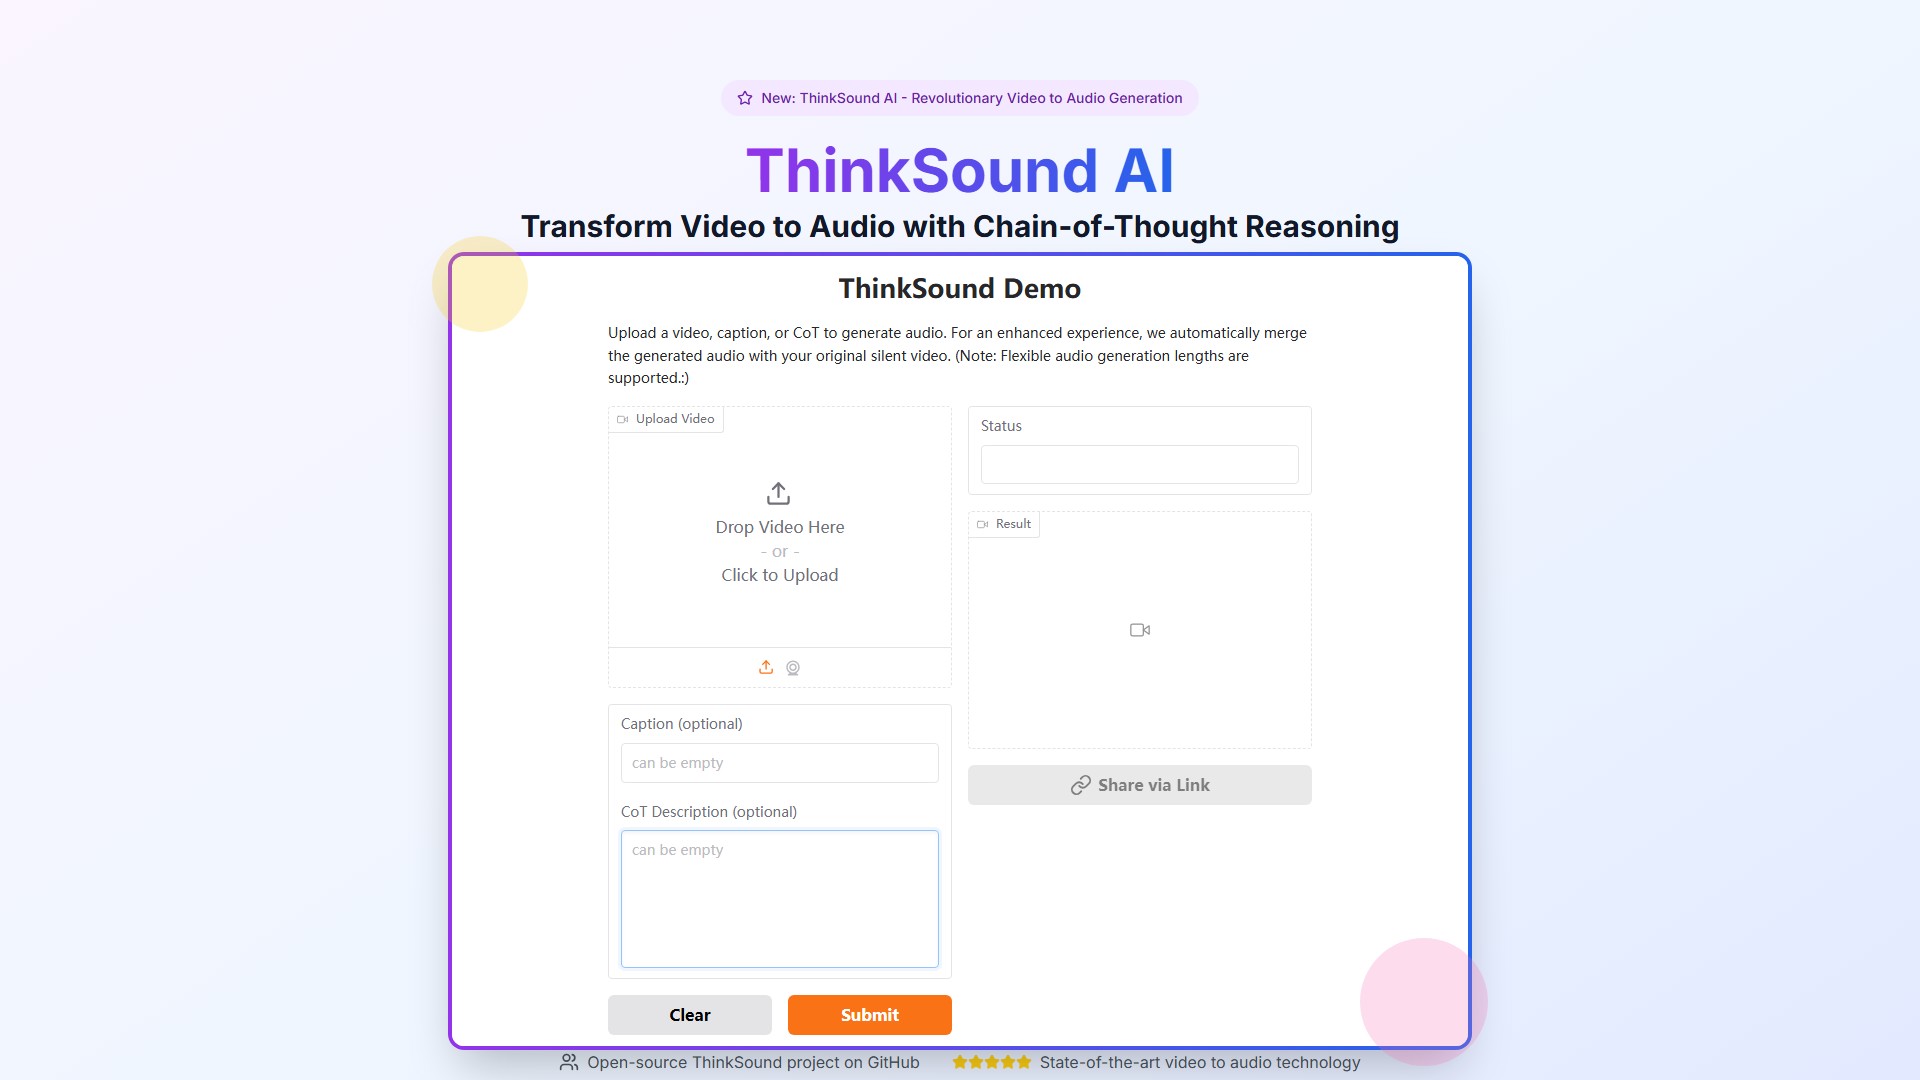
ThinkSound AI là nền tảng tạo âm thanh từ video, biến mọi video thành không gian âm thanh phong phú, phù hợp với ngữ cảnh bằng công nghệ suy luận Chain-of-Thought.
Lượt xem
-
Lượt truy cập hàng tháng
--
Xếp hạng toàn cầu
--
Lượt bình chọn
0
Giới thiệu về công cụ này
Tính năng chính
- Tạo âm thanh từ video bằng AI Chain-of-Thought
- Quy trình ba giai đoạn: tạo foley nền tảng, tinh chỉnh đối tượng và chỉnh sửa bằng ngôn ngữ tự nhiên
- Công nghệ AudioCoT với chú thích suy luận có cấu trúc, giúp chuyển đổi video sang âm thanh nhất quán về ngữ nghĩa
- Tinh chỉnh tương tác bằng các chỉ dẫn ngôn ngữ tự nhiên đơn giản
- Nền tảng mã nguồn mở với mô hình và bộ dữ liệu trên Hugging Face và GitHub
Cách hoạt động
- Phân tích nội dung hình ảnh bằng khả năng hiểu đa phương thức.
- Phân rã video thành các thành phần âm thanh, xác định vật thể, hành động và âm thanh môi trường.
- Tạo âm thanh qua ba giai đoạn: foley nền tảng, tinh chỉnh theo đối tượng và chỉnh sửa bằng ngôn ngữ tự nhiên.
- Cho phép kiểm soát chính xác từng thành phần âm thanh bằng chỉ dẫn ngôn ngữ tự nhiên.
Đối tượng sử dụng
Phù hợp với nhà nghiên cứu, nhà phát triển, nhà sáng tạo và tổ chức cần triển khai giải pháp video sang âm thanh tùy chỉnh.
Ưu điểm
- Framework video sang âm thanh đầu tiên sử dụng suy luận Chain-of-Thought.
- Hiểu ngữ cảnh hình ảnh và tạo không gian âm thanh nhất quán về ngữ nghĩa.
- Hỗ trợ hơn 20 ngôn ngữ và chất lượng âm thanh 44,1 kHz.
Các gói giá
- Quyền truy cập nghiên cứu (miễn phí): quyền truy cập nghiên cứu, ví dụ tạo âm thanh, bộ dữ liệu AudioCoT, kho GitHub và hỗ trợ cộng đồng, chỉ dành cho mục đích nghiên cứu.
- Quyền truy cập nhà phát triển (sắp ra mắt): API, tính năng Chain-of-Thought nâng cao, tạo tùy chỉnh, xử lý ưu tiên, hỗ trợ nhà phát triển, giấy phép thương mại, tinh chỉnh mô hình và hướng dẫn tích hợp.
- Doanh nghiệp (liên hệ để biết giá): triển khai tùy chỉnh, tùy biến nâng cao, giải pháp white-label, phiên bản chuyên dụng, hỗ trợ 24/7, phân tích, cộng tác nhóm và SLA doanh nghiệp.
FAQ
Dự án hiện đang ở giai đoạn nghiên cứu. Mô hình, bộ dữ liệu AudioCoT và các ví dụ có trên Hugging Face và GitHub. API thương mại sẽ sớm ra mắt.
Phân tích lưu lượng truy cập
Các chỉ số về lưu lượng truy cập, thứ hạng và mức độ tương tác của công cụ này.
Chưa có dữ liệu phân tích
Bản xem trước giao diện