オーディオ編集
ThinkSound AI
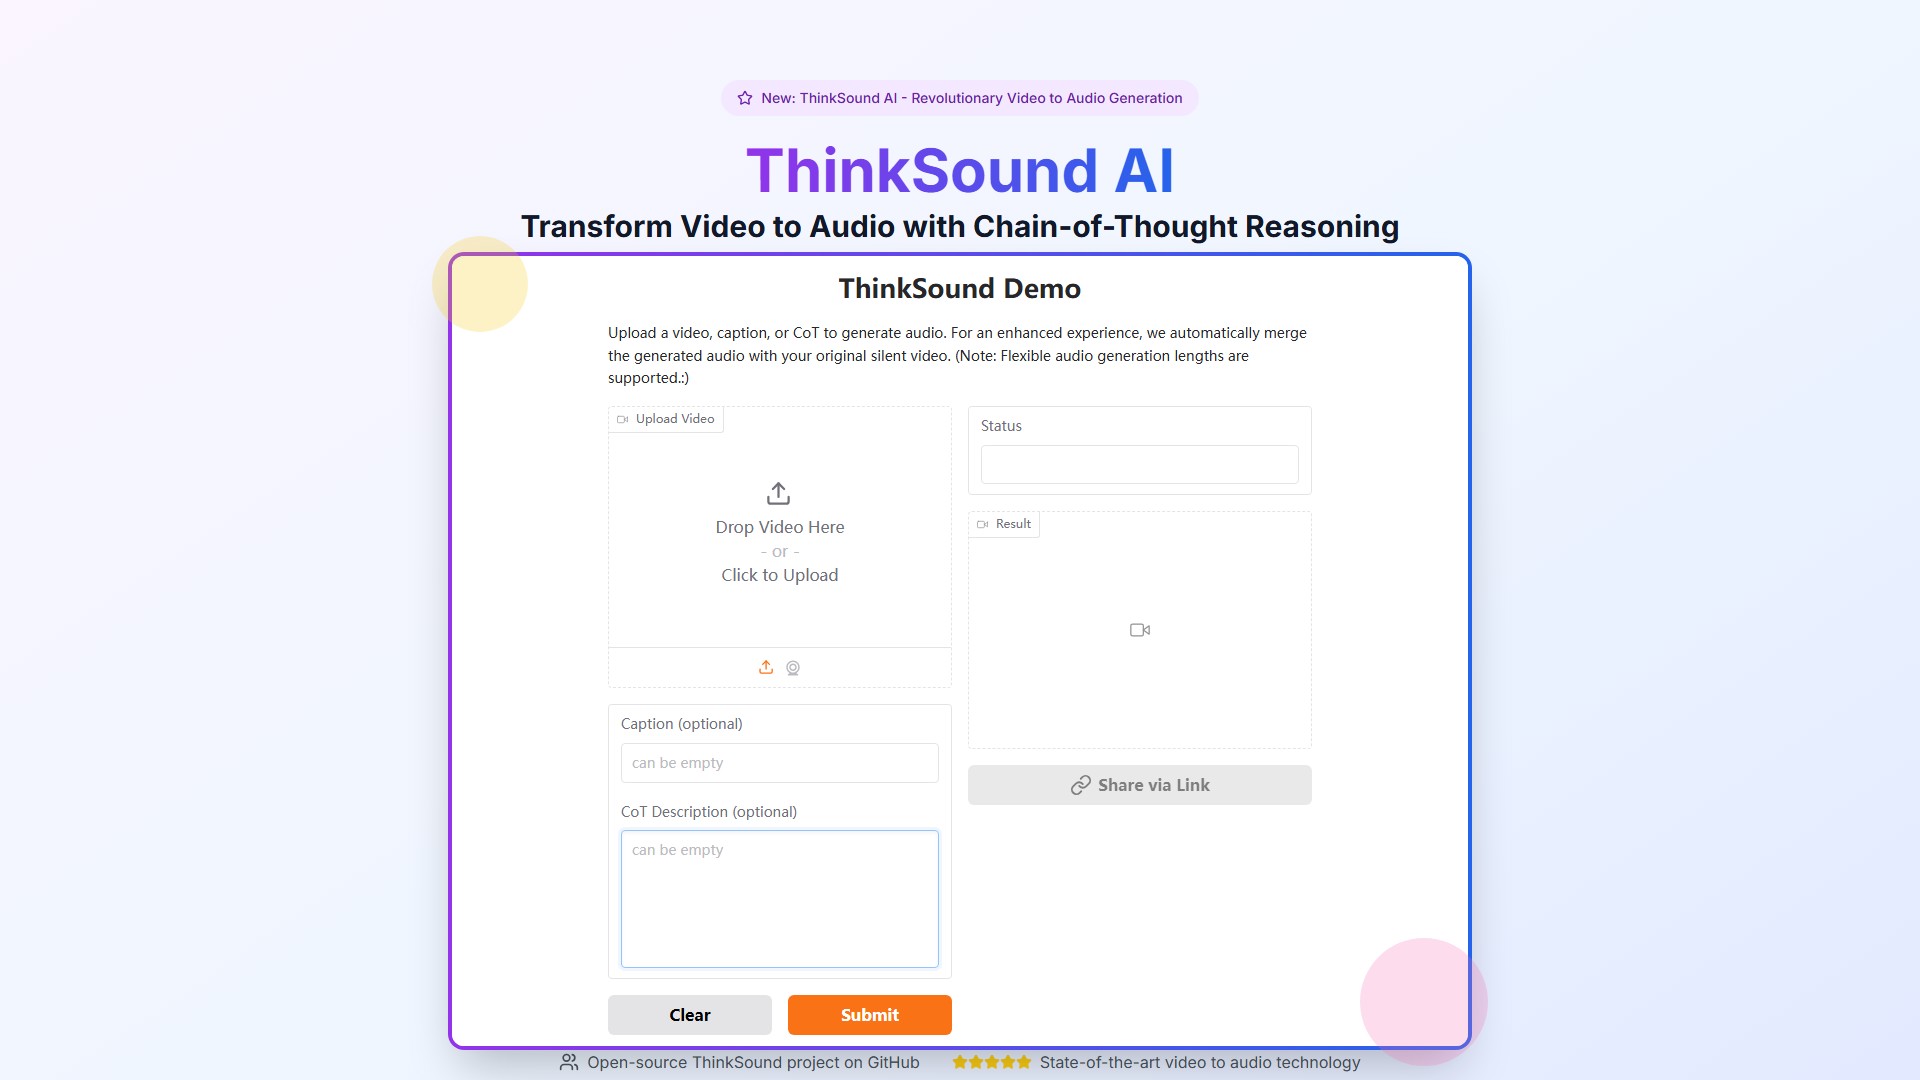
ThinkSound AIは、Chain-of-Thought推論技術を使って動画を豊かで文脈に合ったサウンドスケープへ変換する、動画から音声を生成するプラットフォームです。
閲覧数
-
月間訪問数
--
世界ランキング
--
票数
0
このツールについて
主な機能
- Chain-of-Thought AIによる動画から音声への変換
- 基礎的なフォーリー音生成、オブジェクトの精緻化、自然言語編集による3段階処理
- 意味的に一貫した変換を実現する構造化推論アノテーションを備えたAudioCoT技術
- 自然言語の指示によるインタラクティブな編集と調整
- Hugging FaceとGitHubでモデルとデータセットにアクセスできるオープンソースプラットフォーム
仕組み
- マルチモーダル理解により動画の映像内容を分析します。
- 動画を音声要素に分解し、物体、動作、環境音を特定します。
- 基礎フォーリー音、オブジェクト中心の精緻化、自然言語編集の3段階で音声を生成します。
- 自然言語の指示で各音声要素を細かく調整できます。
対象ユーザー
動画から音声への技術を研究する研究者、APIや高度な機能を求める開発者・クリエイター、カスタム導入を必要とする組織に適しています。
主なメリット
- Chain-of-Thought推論を利用する初の動画音声変換フレームワーク。
- 映像の文脈を理解し、意味的に一貫したサウンドスケープを生成。
- 20以上の言語と44.1kHzの音声品質に対応。
料金プラン
- 研究アクセス(無料):研究利用、生成例、AudioCoTデータセット、GitHubリポジトリ、コミュニティサポート。研究用途のみ。
- 開発者アクセス(近日提供予定):API、高度なChain-of-Thought機能、カスタム生成、優先処理、開発者サポート、商用ライセンス、モデルのファインチューニング、統合ガイド。
- エンタープライズ(料金は要問い合わせ):カスタム導入、高度なカスタマイズ、ホワイトラベル、専用インスタンス、24時間365日サポート、分析、チーム共同作業、エンタープライズSLA。
FAQ
現在は研究段階です。モデル、AudioCoTデータセット、サンプルはHugging FaceとGitHubで公開されています。商用APIは近日提供予定です。
トラフィック分析
このツールのトラフィック、ランキング、エンゲージメントの指標。
まだ分析データはありません
インターフェースプレビュー