Audiobewerking
ThinkSound AI
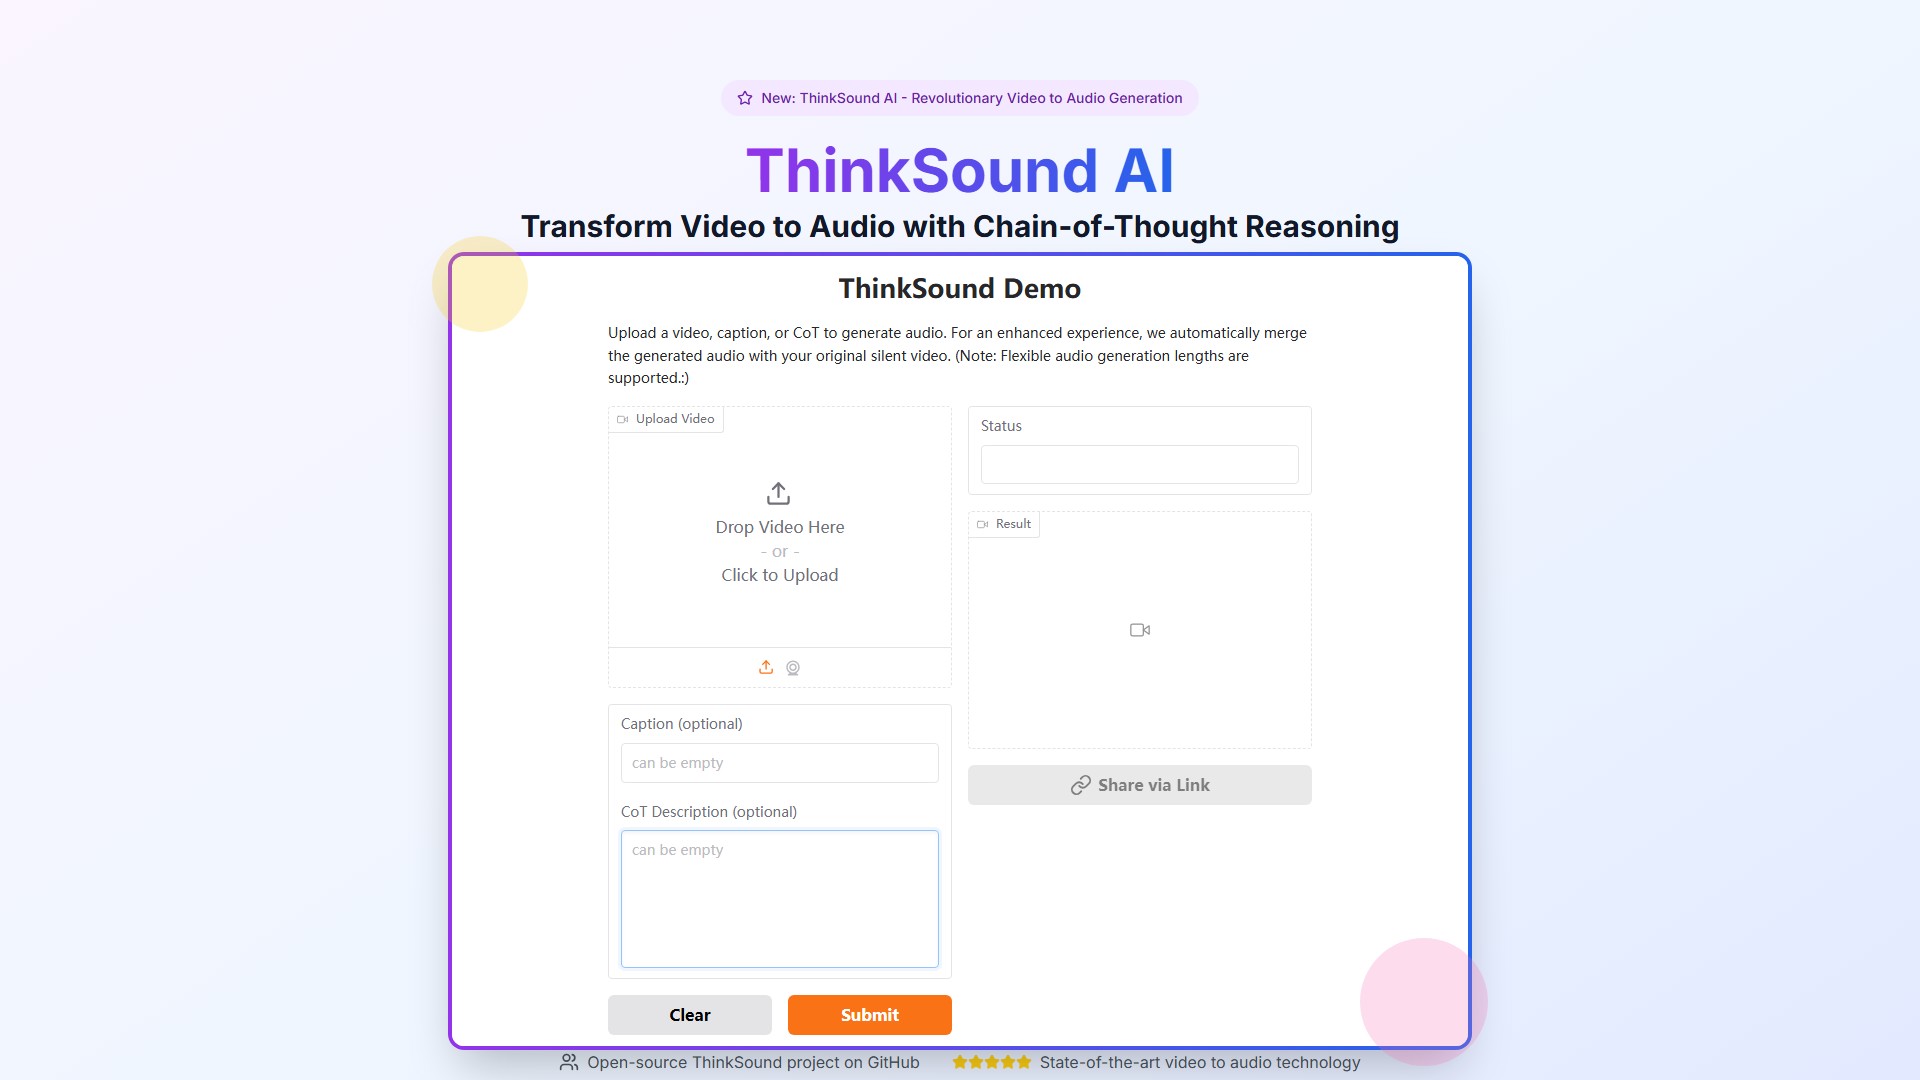
ThinkSound AI is een toonaangevend platform voor audio uit video dat elke video omzet in rijke, contextuele soundscapes met revolutionaire Chain-of-Thought-redeneringstechnologie.
Weergaven
-
Maandelijkse bezoeken
--
Wereldwijde rang
--
Stemmen
0
Over deze tool
Belangrijkste functies
- Audio uit video genereren: Zet elke video om in professionele soundscapes met Chain-of-Thought AI.
- Proces in drie fasen: Generatie van basis-foleygeluiden, verfijning van objecten en bewerking in natuurlijke taal.
- AudioCoT-technologie: Gestructureerde redeneerannotaties voor semantisch coherente omzetting van video naar audio.
- Interactieve verfijning: Bewerk en verfijn video-naar-audioresultaten met eenvoudige instructies in natuurlijke taal.
- Open-sourceplatform: Volledige video-naar-audiomodellen en datasets zijn beschikbaar op Hugging Face en GitHub.
Hoe het werkt
- Video uploaden: ThinkSound AI analyseert visuele inhoud met multimodaal begrip.
- Chain-of-Thought-analyse: Splitst de video op in audio-elementen en identificeert objecten, acties en omgevingsgeluiden.
- Audio genereren in drie fasen: Basis-foleygeluiden, objectgerichte verfijning en bewerking in natuurlijke taal.
- Interactieve verfijning: Nauwkeurige controle over elk audio-element met instructies in natuurlijke taal.
Doelgroepen
- Onderzoekers: Onderzoeks toegang voor het verkennen van video-naar-audiotechnologie.
- Ontwikkelaars en makers: Ontwikkelaarstoegang met API en geavanceerde functies.
- Organisaties: Enterprise-oplossingen voor aangepaste video-naar-audiodeployments.
Belangrijkste voordelen
- Het eerste video-naar-audioframework dat Chain-of-Thought-redenering gebruikt.
- Begrijpt visuele context en genereert semantisch coherente soundscapes.
- Interactieve verfijningsmogelijkheden voor nauwkeurige audiocontrole.
- Open-sourceproject met toegang tot volledige modellen en datasets.
- Ondersteuning voor 20+ talen en audiokwaliteit van 44.1kHz.
Prijsplannen
- Research Access (gratis): Onderzoekstoegang, generatievoorbeelden, AudioCoT-dataset, GitHub-repository en communityondersteuning; uitsluitend voor onderzoeksgebruik.
- Developer Access (binnenkort beschikbaar): API-toegang, geavanceerde Chain-of-Thought-functies, aangepaste generatie, prioriteitsverwerking, ontwikkelaarsondersteuning, commerciële licentie, model-finetuning en integratiehandleidingen.
- Enterprise (neem contact op voor de prijs): Aangepaste deployment, geavanceerde aanpassing, white-labeloplossingen, dedicated instance, 24/7-ondersteuning, analyses, teamsamenwerking en enterprise-SLA.
Veelgestelde vragen
- Hoe het werkt: Chain-of-Thought-redenering zet video in drie fasen om naar audio: basis-foleygeneratie, objectgerichte verfijning en bewerking in natuurlijke taal.
- Toegang tot modellen: Modellen, de AudioCoT-dataset en voorbeelden van het open-sourceproject zijn beschikbaar op Hugging Face en GitHub.
- Uniek karakter: Het is het eerste video-naar-audioframework met Chain-of-Thought-redenering, dat visuele context begrijpt en semantisch coherente soundscapes genereert.
- Beschikbaarheid van de API: Het project bevindt zich momenteel in de onderzoeksfase; een commerciële API komt binnenkort beschikbaar.
Verkeersanalyse
Verkeers-, ranking- en betrokkenheidssignalen voor deze tool.
Nog geen analyticsgegevens
Voorvertoning van de interface