Pengeditan audio
ThinkSound AI
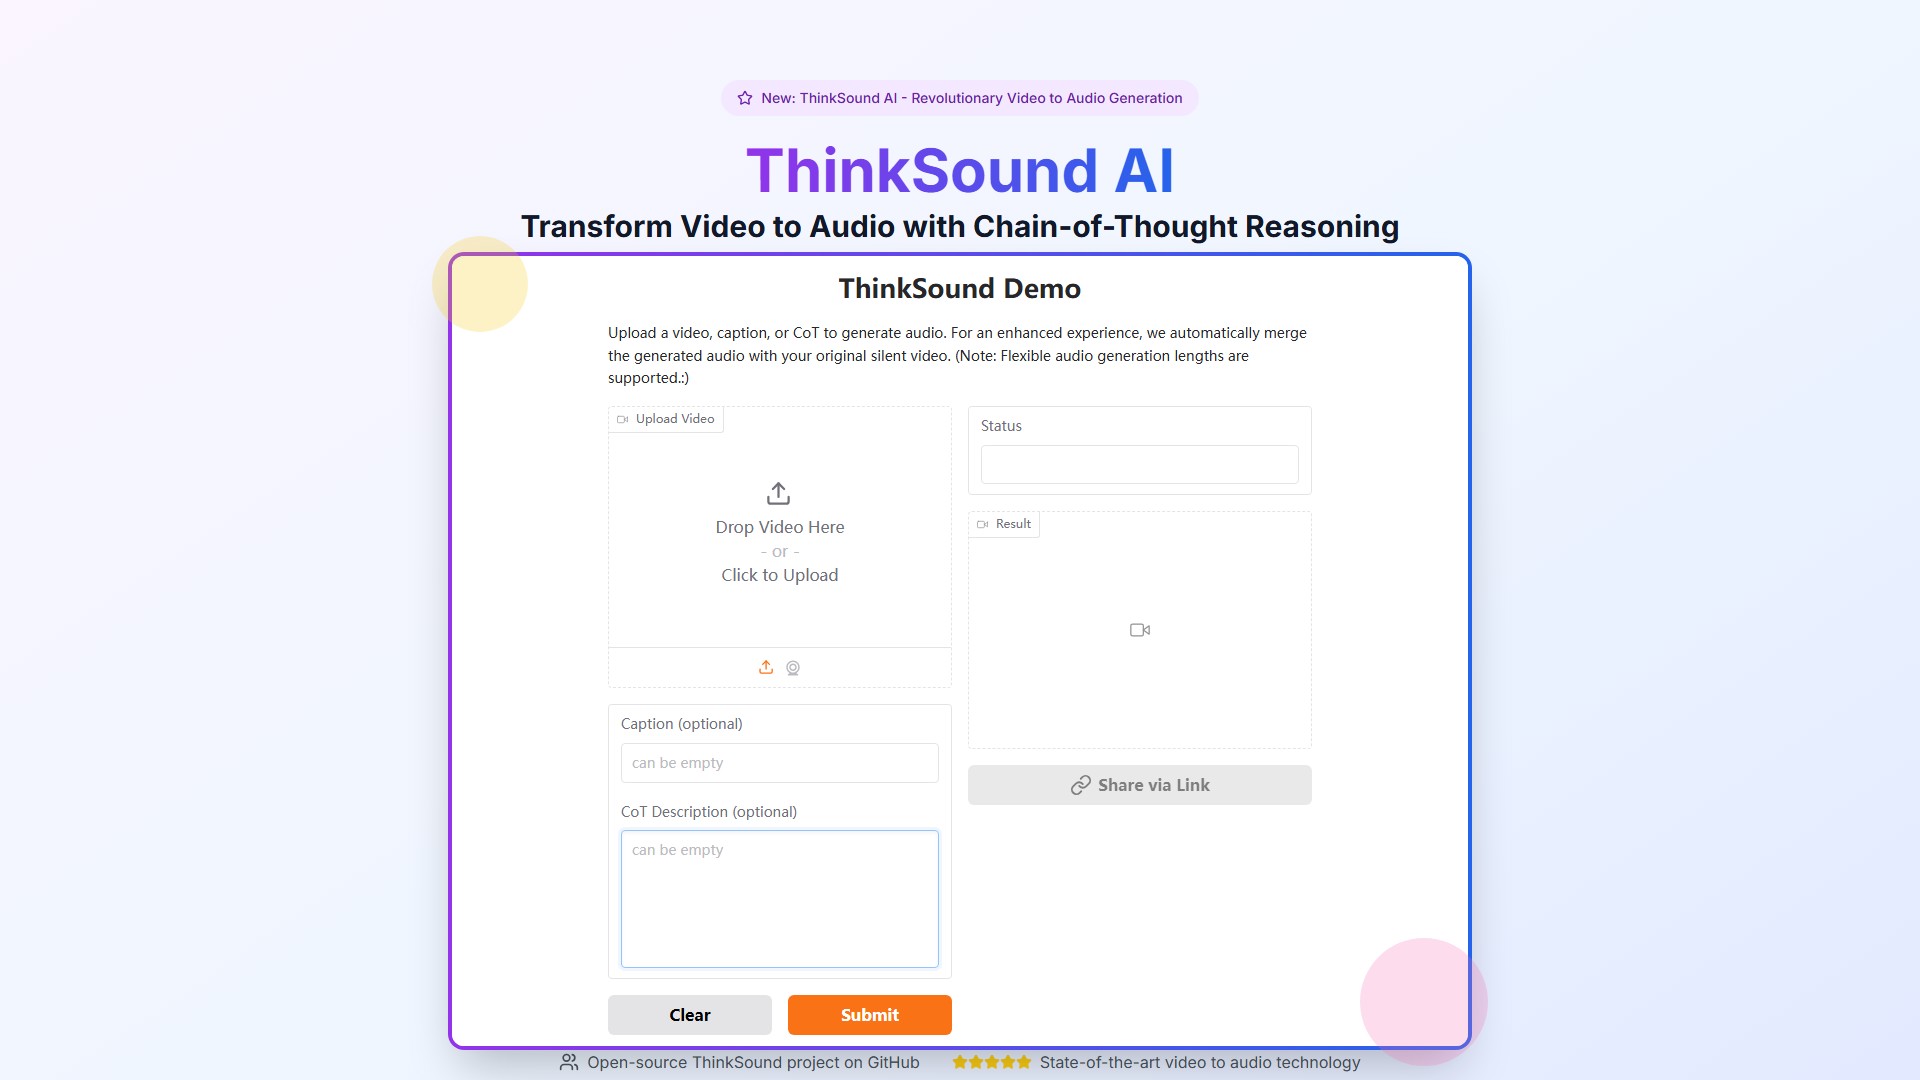
ThinkSound AI adalah platform pembuatan audio dari video yang mengubah video apa pun menjadi lanskap suara yang kaya dan sesuai konteks menggunakan teknologi penalaran Chain-of-Thought.
Tayangan
-
Kunjungan bulanan
--
Peringkat global
--
Suara
0
Tentang alat ini
Fitur utama
- Pembuatan audio dari video dengan AI Chain-of-Thought
- Proses tiga tahap: pembuatan foley dasar, penyempurnaan objek, dan pengeditan dengan bahasa alami
- Teknologi AudioCoT dengan anotasi penalaran terstruktur untuk konversi video ke audio yang koheren secara semantik
- Penyempurnaan interaktif menggunakan instruksi bahasa alami sederhana
- Platform sumber terbuka dengan model dan set data di Hugging Face dan GitHub
Cara kerja
- Menganalisis konten visual menggunakan pemahaman multimodal.
- Menguraikan video menjadi elemen audio serta mengidentifikasi objek, tindakan, dan suara sekitar.
- Membuat audio dalam tiga tahap: foley dasar, penyempurnaan berpusat pada objek, dan pengeditan bahasa alami.
- Memberikan kontrol presisi atas setiap elemen audio melalui instruksi bahasa alami.
Pengguna sasaran
Cocok untuk peneliti, pengembang, kreator, dan organisasi yang memerlukan penerapan video-ke-audio khusus.
Keunggulan
- Framework video-ke-audio pertama yang menggunakan penalaran Chain-of-Thought.
- Memahami konteks visual dan menghasilkan lanskap suara yang koheren secara semantik.
- Mendukung lebih dari 20 bahasa dan kualitas audio 44,1 kHz.
Paket harga
- Akses penelitian (gratis): akses penelitian, contoh generasi, set data AudioCoT, repositori GitHub, dan dukungan komunitas, hanya untuk penggunaan penelitian.
- Akses pengembang (segera hadir): akses API, fitur Chain-of-Thought lanjutan, pembuatan khusus, pemrosesan prioritas, dukungan pengembang, lisensi komersial, fine-tuning model, dan panduan integrasi.
- Perusahaan (hubungi untuk harga): penerapan khusus, kustomisasi lanjutan, solusi white-label, instans khusus, dukungan 24/7, analitik, kolaborasi tim, dan SLA perusahaan.
FAQ
Proyek ini saat ini berada dalam tahap penelitian. Model, set data AudioCoT, dan contoh tersedia di Hugging Face dan GitHub. API komersial akan segera hadir.
Analisis traffic
Sinyal lalu lintas, peringkat, dan interaksi untuk alat ini.
Belum ada data analitik
Pratinjau antarmuka