Редактирование аудио
ThinkSound AI
ThinkSound AI — ведущая платформа генерации аудио из видео, превращающая любое видео в насыщенные контекстные звуковые ландшафты с помощью революционной технологии рассуждений Chain-of-Thought.
Просмотры
-
Ежемесячные посещения
--
Глобальный рейтинг
--
Голоса
0
Об этом инструменте
Ключевые функции
- Генерация аудио из видео: Превращайте любое видео в профессиональные звуковые ландшафты с помощью Chain-of-Thought AI.
- Трёхэтапный процесс: Генерация базовых фоли-звуков, уточнение объектов и редактирование на естественном языке.
- Технология AudioCoT: Структурированные аннотации рассуждений для семантически согласованного преобразования видео в аудио.
- Интерактивное уточнение: Редактируйте и улучшайте результат преобразования видео в аудио с помощью простых инструкций на естественном языке.
- Платформа с открытым исходным кодом: Полные модели и наборы данных для преобразования видео в аудио доступны на Hugging Face и GitHub.
Как это работает
- Загрузите видео: ThinkSound AI анализирует визуальное содержимое с помощью мультимодального понимания.
- Анализ Chain-of-Thought: Разделяет видео на аудиоэлементы, определяя объекты, действия и окружающие звуки.
- Трёхэтапная генерация аудио: Базовые фоли-звуки, объектно-ориентированное уточнение и редактирование на естественном языке.
- Интерактивное уточнение: Точный контроль над каждым аудиоэлементом с помощью инструкций на естественном языке.
Целевая аудитория
- Исследователи: Доступ для изучения технологии преобразования видео в аудио.
- Разработчики и создатели: Доступ разработчика к API и расширенным функциям.
- Организации: Корпоративные решения для индивидуального развертывания преобразования видео в аудио.
Основные преимущества
- Первый фреймворк преобразования видео в аудио, использующий рассуждения Chain-of-Thought.
- Понимает визуальный контекст и создаёт семантически согласованные звуковые ландшафты.
- Интерактивное уточнение для точного управления аудио.
- Проект с открытым исходным кодом и доступом к полным моделям и наборам данных.
- Поддержка 20+ языков и качества аудио 44.1kHz.
Тарифные планы
- Research Access (бесплатно): Доступ для исследований, примеры генерации, набор данных AudioCoT, репозиторий GitHub и поддержка сообщества; только для исследовательского использования.
- Developer Access (скоро): Доступ к API, расширенные функции Chain-of-Thought, индивидуальная генерация, приоритетная обработка, поддержка разработчиков, коммерческая лицензия, дообучение моделей и руководства по интеграции.
- Enterprise (уточняйте стоимость): Индивидуальное развёртывание, расширенная настройка, white-label-решения, выделенный экземпляр, поддержка 24/7, аналитика, совместная работа команды и корпоративное SLA.
Часто задаваемые вопросы
- Как это работает: С помощью рассуждений Chain-of-Thought преобразует видео в аудио в три этапа: генерация базовых фоли-звуков, объектно-ориентированное уточнение и редактирование на естественном языке.
- Доступ к моделям: Модели, набор данных AudioCoT и примеры открытого проекта доступны на Hugging Face и GitHub.
- Уникальность: Это первый фреймворк преобразования видео в аудио с рассуждениями Chain-of-Thought, который понимает визуальный контекст и создаёт семантически согласованные звуковые ландшафты.
- Доступность API: Сейчас проект находится на исследовательской стадии; коммерческий API появится в ближайшее время.
Анализ трафика
Данные о трафике, рейтинге и вовлечённости этого инструмента.
Данных аналитики пока нет
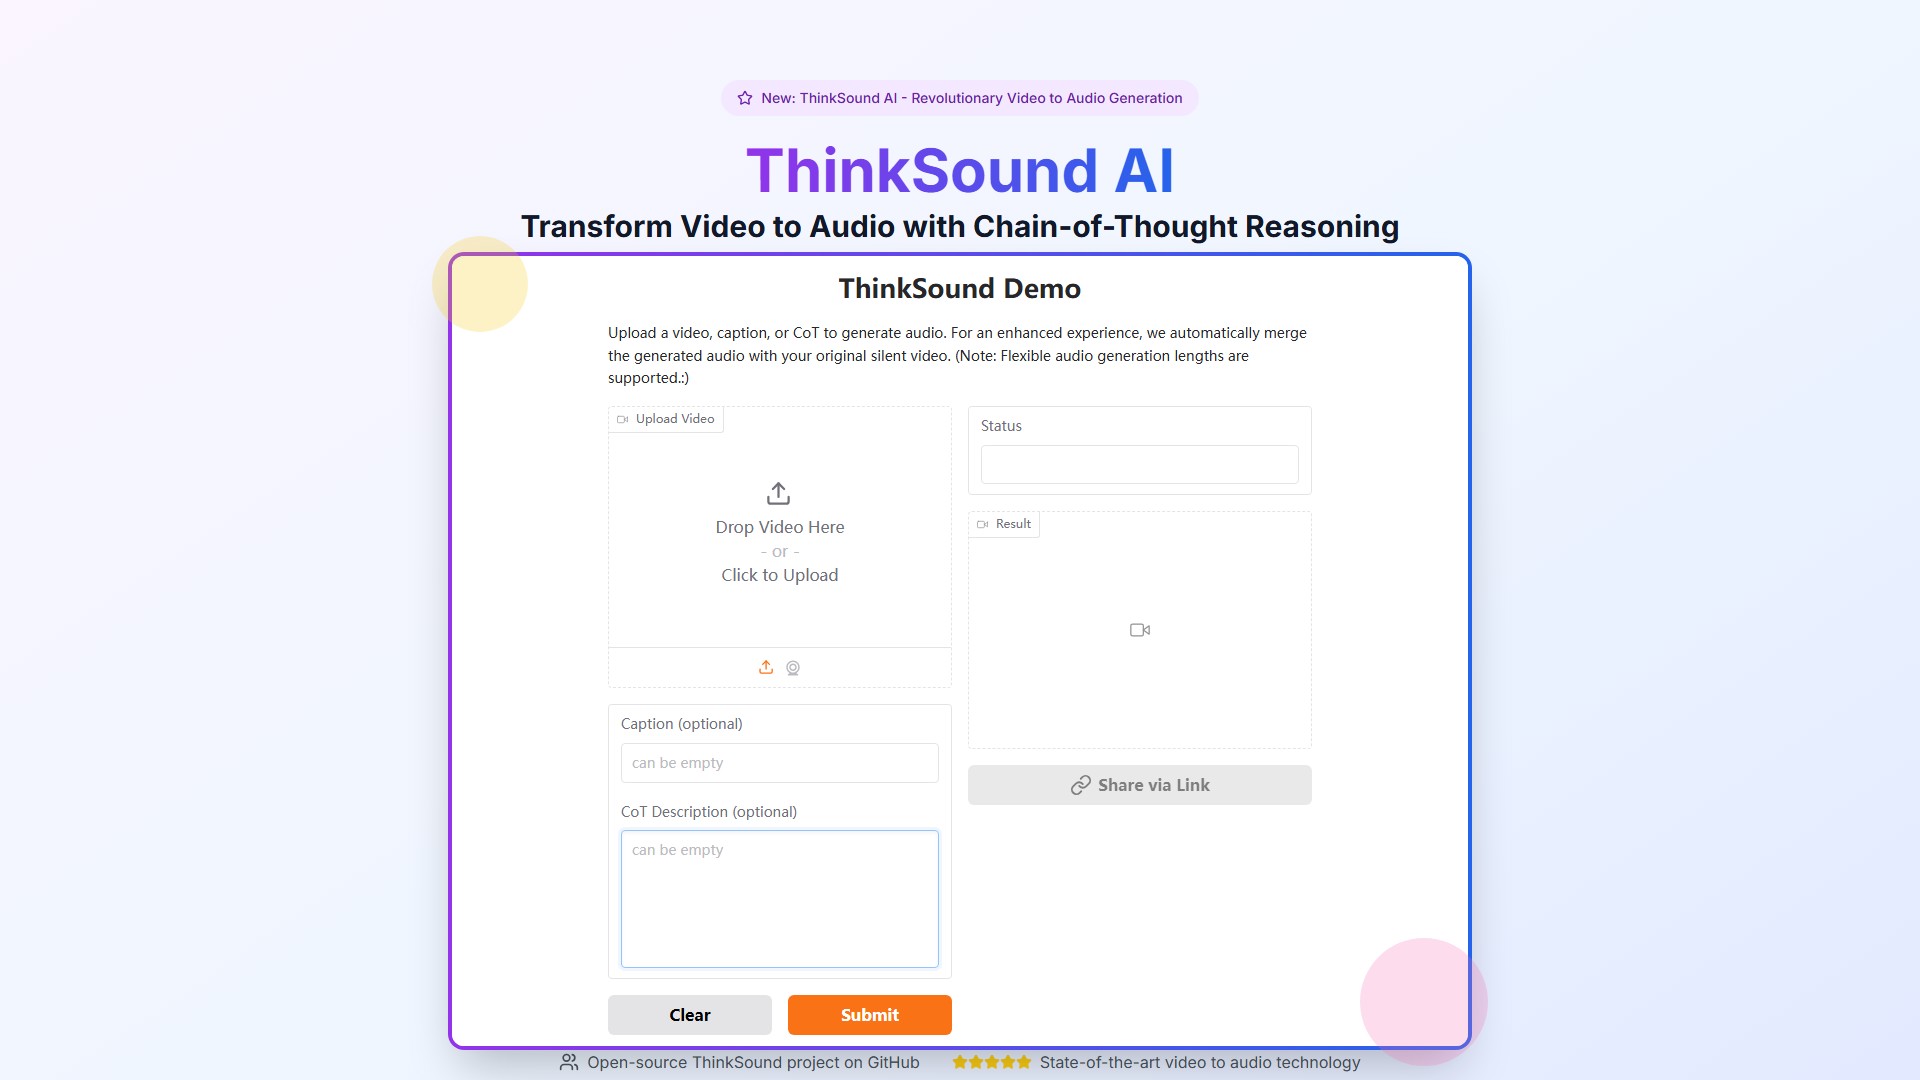
Предпросмотр интерфейса