오디오 편집
ThinkSound AI
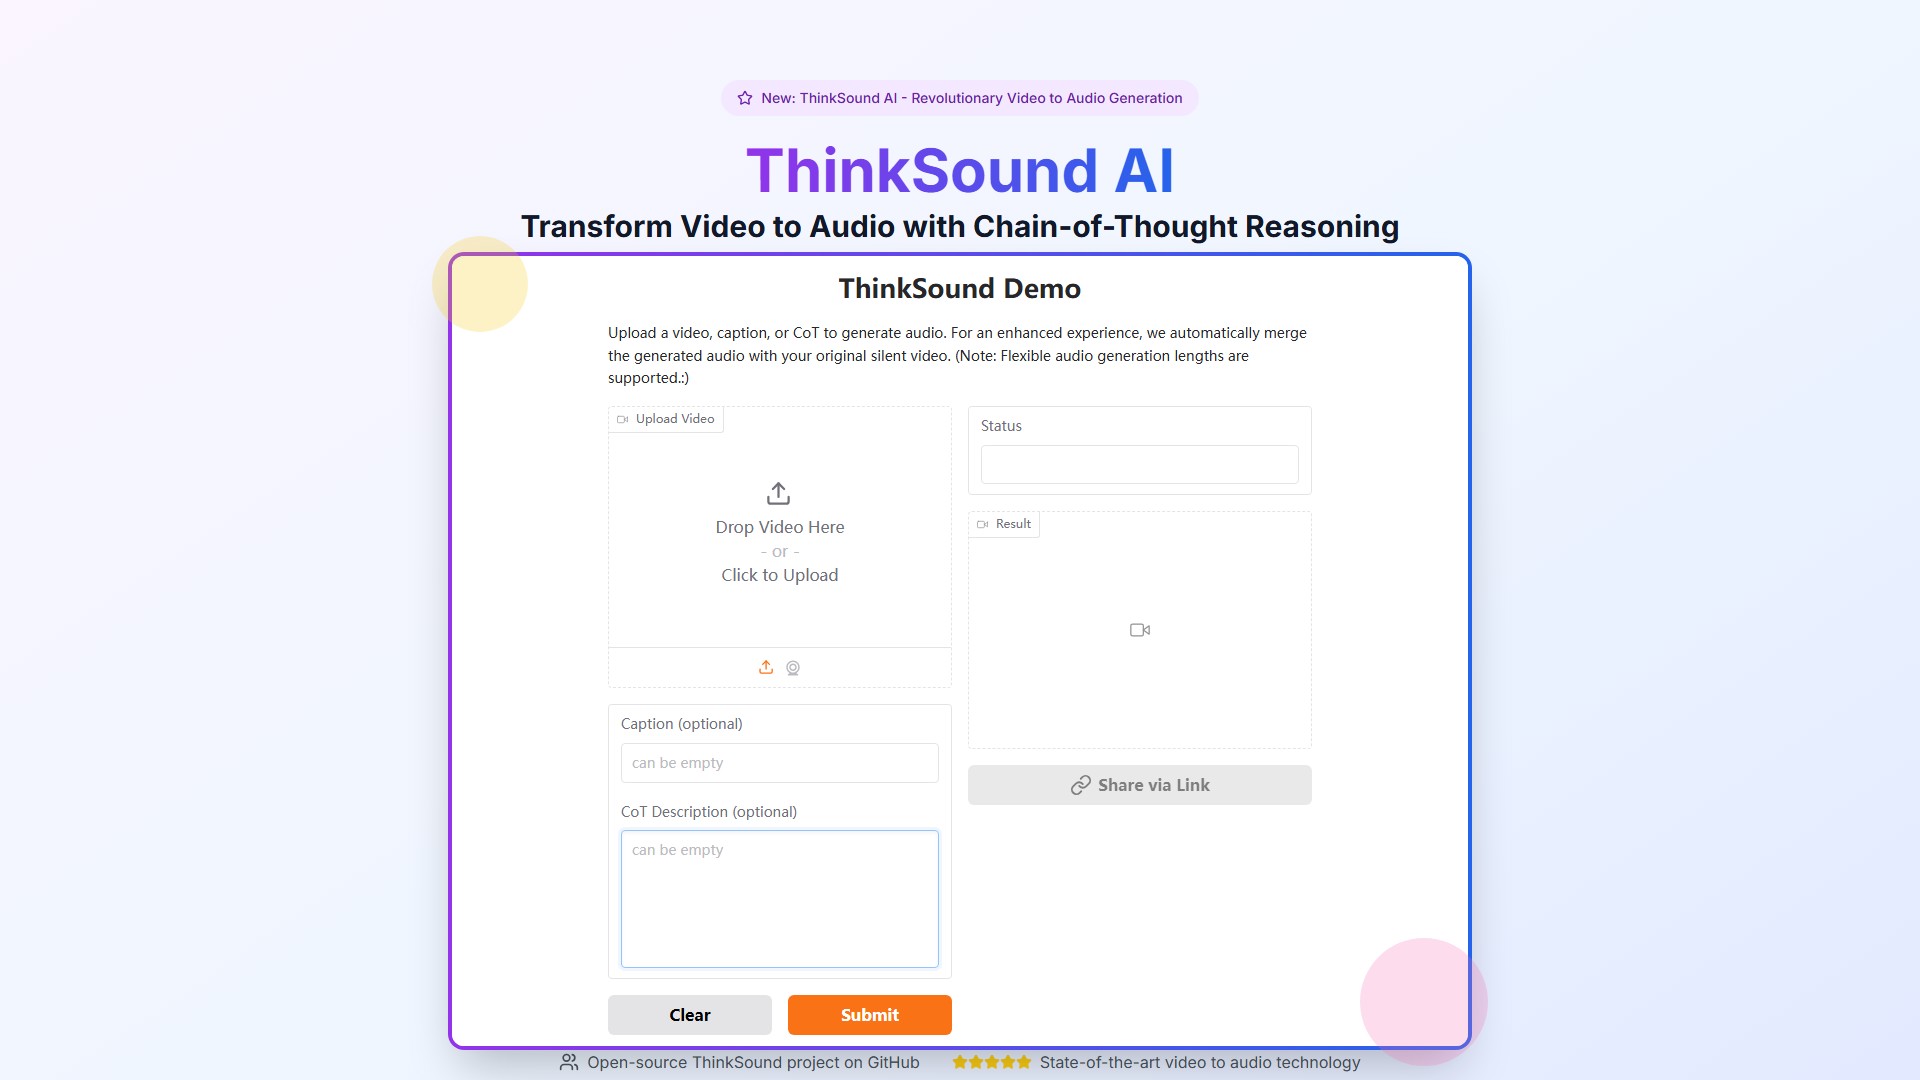
ThinkSound AI는 Chain-of-Thought 추론 기술을 활용해 모든 동영상을 풍부하고 맥락에 맞는 사운드스케이프로 변환하는 동영상-오디오 생성 플랫폼입니다.
조회수
-
월간 방문 수
--
글로벌 순위
--
투표 수
0
이 도구 정보
주요 기능
- Chain-of-Thought AI를 활용한 동영상-오디오 생성
- 기초 폴리 생성, 객체 정교화, 자연어 편집으로 구성된 3단계 프로세스
- 의미적으로 일관된 변환을 위한 구조화된 추론 주석 기술인 AudioCoT
- 자연어 지시로 결과를 편집하고 정교화하는 인터랙티브 기능
- Hugging Face와 GitHub에서 모델과 데이터 세트에 접근할 수 있는 오픈 소스 플랫폼
작동 방식
- 멀티모달 이해를 통해 동영상의 시각적 콘텐츠를 분석합니다.
- 동영상을 오디오 요소로 분해해 객체, 동작, 주변 소리를 식별합니다.
- 기초 폴리, 객체 중심 정교화, 자연어 편집의 3단계로 오디오를 생성합니다.
- 자연어 지시를 사용해 각 오디오 요소를 정밀하게 제어할 수 있습니다.
대상 사용자
동영상-오디오 기술을 연구하는 연구자, API와 고급 기능을 원하는 개발자 및 크리에이터, 맞춤형 배포가 필요한 조직을 위한 도구입니다.
핵심 장점
- Chain-of-Thought 추론을 사용하는 최초의 동영상-오디오 프레임워크.
- 시각적 맥락을 이해하고 의미적으로 일관된 사운드스케이프를 생성합니다.
- 20개 이상의 언어와 44.1kHz 오디오 품질을 지원합니다.
요금제
- 연구용 액세스(무료): 연구 액세스, 생성 예시, AudioCoT 데이터 세트, GitHub 저장소, 커뮤니티 지원. 연구용으로만 제공됩니다.
- 개발자 액세스(출시 예정): API, 고급 Chain-of-Thought 기능, 맞춤 생성, 우선 처리, 개발자 지원, 상업용 라이선스, 모델 파인튜닝, 통합 가이드.
- 엔터프라이즈(가격 문의): 맞춤 배포, 고급 커스터마이징, 화이트 라벨 솔루션, 전용 인스턴스, 24시간 연중무휴 지원, 분석, 팀 협업, 엔터프라이즈 SLA.
FAQ
현재 연구 단계이며 모델, AudioCoT 데이터 세트와 예시는 Hugging Face 및 GitHub에서 이용할 수 있습니다. 상업용 API는 곧 제공될 예정입니다.
트래픽 분석
이 도구의 트래픽, 순위 및 참여도 지표입니다.
아직 분석 데이터가 없습니다
인터페이스 미리보기