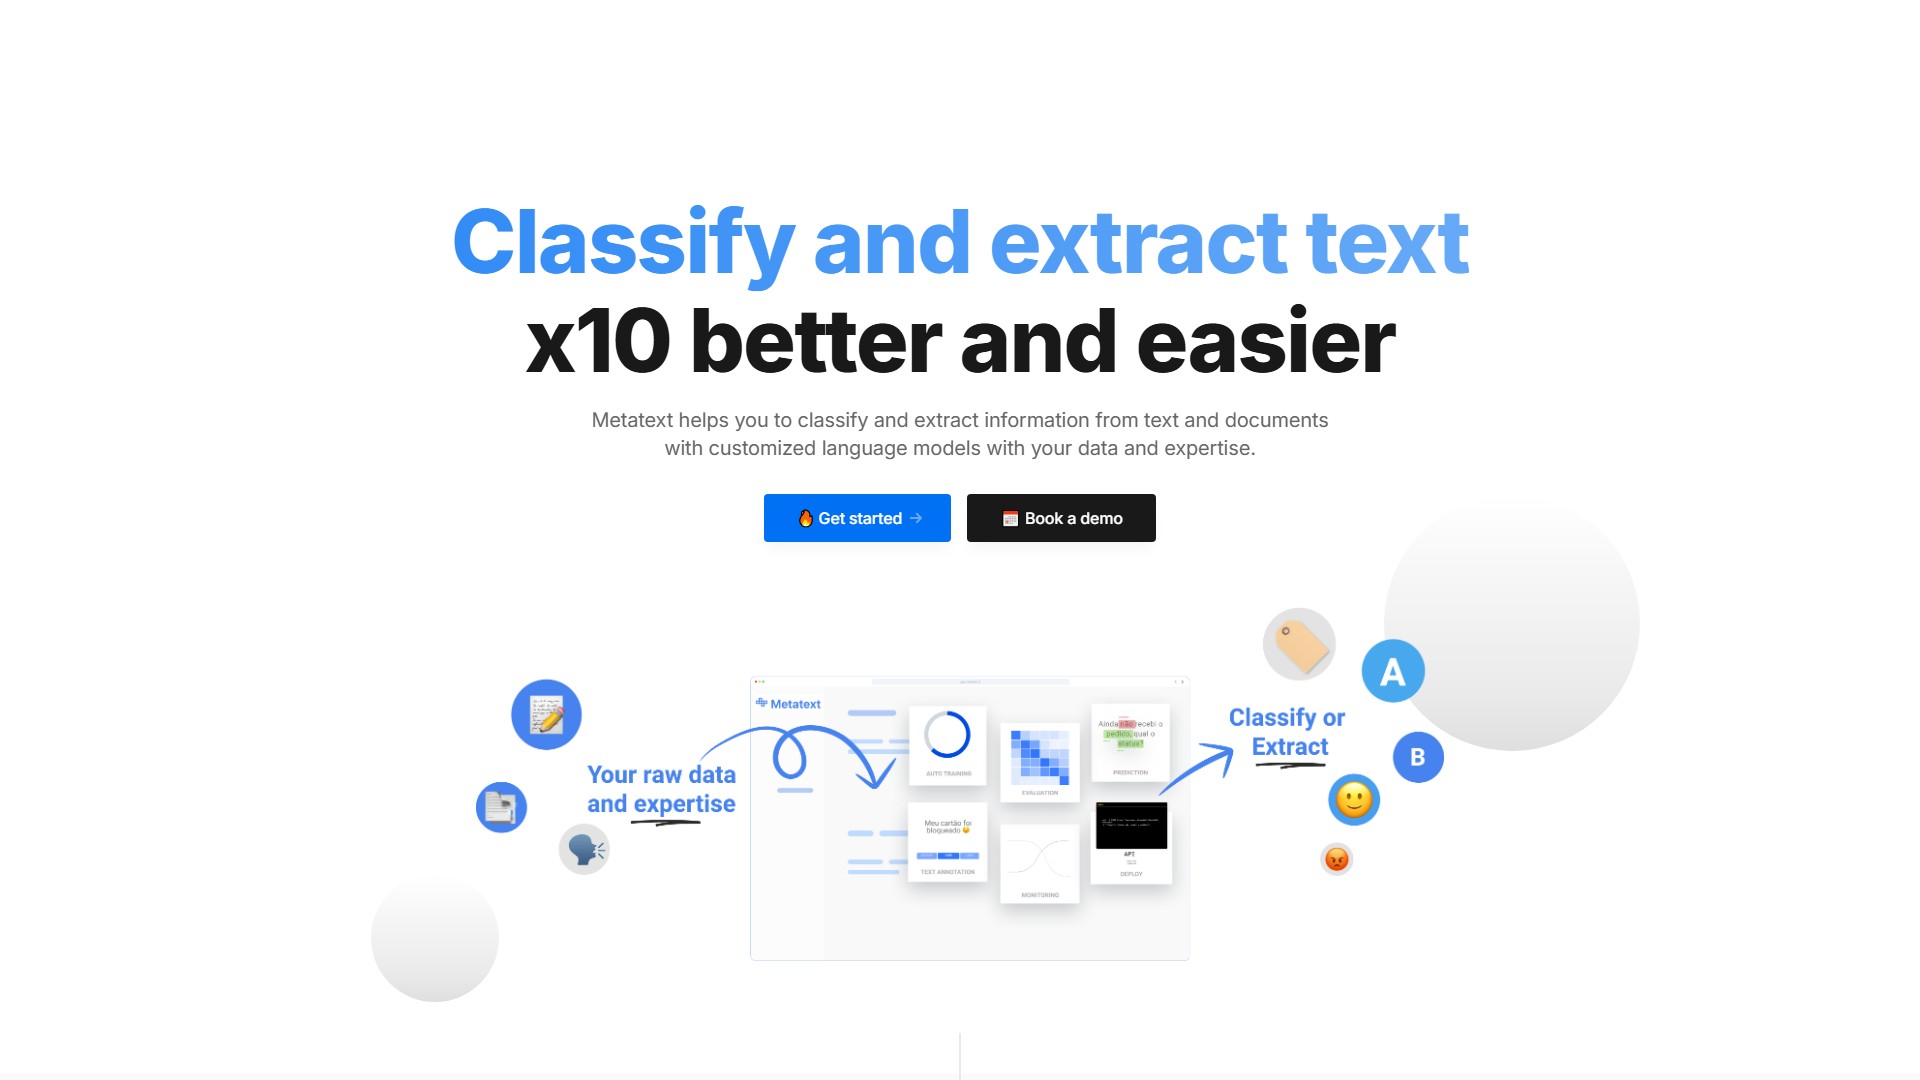
इस टूल के बारे में
मुख्य सुविधाएं
- टेक्स्ट वर्गीकरण: बाइनरी, मल्टी-क्लास, मल्टी-लेबल, भावना, विषय और इंटेंट वर्गीकरण के माध्यम से किसी भी टेक्स्ट या दस्तावेज़ को श्रेणीबद्ध करें।
- टेक्स्ट निष्कर्षण: किसी भी टेक्स्ट या दस्तावेज़ से मुख्य जानकारी, इकाइयां और कीवर्ड निकालें, उन्हें सामान्यीकृत और संरचित करें।
- टेक्स्ट जनरेशन: जनरेटिव AI ऐप्लिकेशन, RAG, सारांश, LLM फाइन-ट्यूनिंग, प्रश्नोत्तर और चैटबॉट के लिए शुरू से टेक्स्ट बनाएं या LLM को अपने डोमेन के अनुसार फाइन-ट्यून करें।
मुख्य विशेषताएं और लाभ
- नो-कोड प्लेटफ़ॉर्म: कोडिंग या ML/NLP विशेषज्ञता की आवश्यकता नहीं। मॉडल को अपनी जरूरत बताएं और उसे अपने डेटा व विशेषज्ञता से सीखने दें।
- AutoNLP इंजन: अपना डेटा और विशेषज्ञता प्लेटफ़ॉर्म में डालें; AutoNLP इंजन आपके उपयोग के मामले के लिए सर्वोत्तम मॉडल को प्रशिक्षित और फाइन-ट्यून करेगा।
- LLM Distillation पद्धति: LLM की शक्ति को एक पुनरावृत्त प्रक्रिया में मिलाकर अपने डेटा को निजी और स्केलेबल कस्टम मॉडल में बदलें। इससे छोटे मॉडल कम डेटा और समय में 10 गुना बेहतर ढंग से प्रशिक्षित किए जा सकते हैं।
- Trustful Evaluation: मॉडल के प्रदर्शन और उसमें सुधार के तरीकों को समझने में सहायता करता है। भरोसेमंद मॉडल सफलता के लिए महत्वपूर्ण हैं।
- तेज़ डिप्लॉयमेंट और एकीकरण: कुछ क्लिक में मॉडल डिप्लॉय करें और API, Zapier, Google Sheets, Docker, AWS, Hugging Face आदि के माध्यम से सिस्टम से जोड़ें।
- न ब्लैक बॉक्स, न विक्रेता-निर्भरता: ब्लैक-बॉक्स, vendor lock-in या डेटा गोपनीयता संबंधी समस्याओं के बिना कस्टम NLP मॉडल बनाएं और प्रबंधित करें।
सामान्य उपयोग
- ग्राहक सहायता: ग्राहक टिकटों को जल्दी वर्गीकृत करें और जवाब दें, ताकि जटिल समस्याओं के लिए अधिक समय मिले।
- ग्राहक अंतर्दृष्टि: समीक्षाओं को विषय, समस्या, भावना और सहभागिता के आधार पर स्वचालित रूप से वर्गीकृत करें।
- कंटेंट मॉडरेशन: अनुचित, आपत्तिजनक या हानिकारक सामग्री को स्वचालित रूप से पहचानकर हटाएं।
- स्वास्थ्य सेवा: मेडिकल रिकॉर्ड, लैब रिपोर्ट और मरीजों की प्रतिक्रिया से महत्वपूर्ण डेटा निकालें।
- वित्त: बाजार की भावना, रिपोर्ट और ग्राहक प्रतिक्रिया का विश्लेषण करें।
- मानव संसाधन (HR): कौशल, अनुभव और योग्यताओं का नौकरी की आवश्यकताओं से मिलान करके सबसे उपयुक्त उम्मीदवार पहचानें।
लक्षित उपयोगकर्ता
डेवलपर, बिजनेस विश्लेषक, डेटा वैज्ञानिक और वे सभी लोग जो टेक्स्ट वर्गीकरण के लिए NLP मॉडल को तेज़ी और कुशलता से प्रशिक्षित व डिप्लॉय करना चाहते हैं।
कीमत और योजनाएं
मॉडल को प्रशिक्षित करने या API अथवा inference preview के माध्यम से predictions (inferences) करने के लिए Credits प्रणाली का उपयोग होता है। तीन स्तर उपलब्ध हैं:
- Starter (मुफ्त): 500 credits/माह, अधिकतम 5 प्रोजेक्ट, प्रति प्रोजेक्ट 1,000 रिकॉर्ड, प्रति प्रोजेक्ट 10 model versions, असीमित labels, सार्वजनिक दृश्यता, कम GPU क्षमता और मानक सहायता।
- Pro ($185/माह): Starter की सभी सुविधाओं के साथ 80,000 credits/माह, असीमित प्रोजेक्ट, प्रति प्रोजेक्ट 10k रिकॉर्ड तक, असीमित model versions, visibility control, बेहतर GPU क्षमता और प्राथमिकता सहायता।
- Enterprise (कस्टम): PRO की सभी सुविधाओं के साथ कस्टम कीमत और संसाधन, on-premise विकल्प और समर्पित AI इंजीनियर। शैक्षणिक शोध के लिए छूट उपलब्ध है।
अक्सर पूछे जाने वाले प्रश्न
Metatext कई भाषाओं का समर्थन करता है। इसमें कस्टम डेटासेट (CSV, TXT, PDF, DOCX आदि) अपलोड किए जा सकते हैं और API के माध्यम से आयात किया जा सकता है। टेक्स्ट वर्गीकरण के लिए labels असीमित हैं। प्रशिक्षित मॉडल सीधे डाउनलोड नहीं किए जा सकते, लेकिन APIs के माध्यम से एकीकृत किए जा सकते हैं। Metatext कस्टम NLP मॉडल बनाने और डिप्लॉय करने के लिए है; ChatGPT और GPT सामान्य-उद्देश्य वाले भाषा मॉडल हैं, जो मानव-जैसा टेक्स्ट और संवादात्मक AI बनाने पर केंद्रित हैं।
ट्रैफ़िक विश्लेषण
इस टूल के ट्रैफ़िक, रैंकिंग और सहभागिता के संकेतक।
विज़िट का रुझान
रुझान का कोई डेटा नहीं
सहभागिता
- बाउंस दर--
- प्रति विज़िट पृष्ठ--
- औसत अवधि--
ट्रैफ़िक स्रोत
स्रोत का कोई डेटा नहीं
शीर्ष देश
देशों का कोई डेटा नहीं
इंटरफ़ेस पूर्वावलोकन