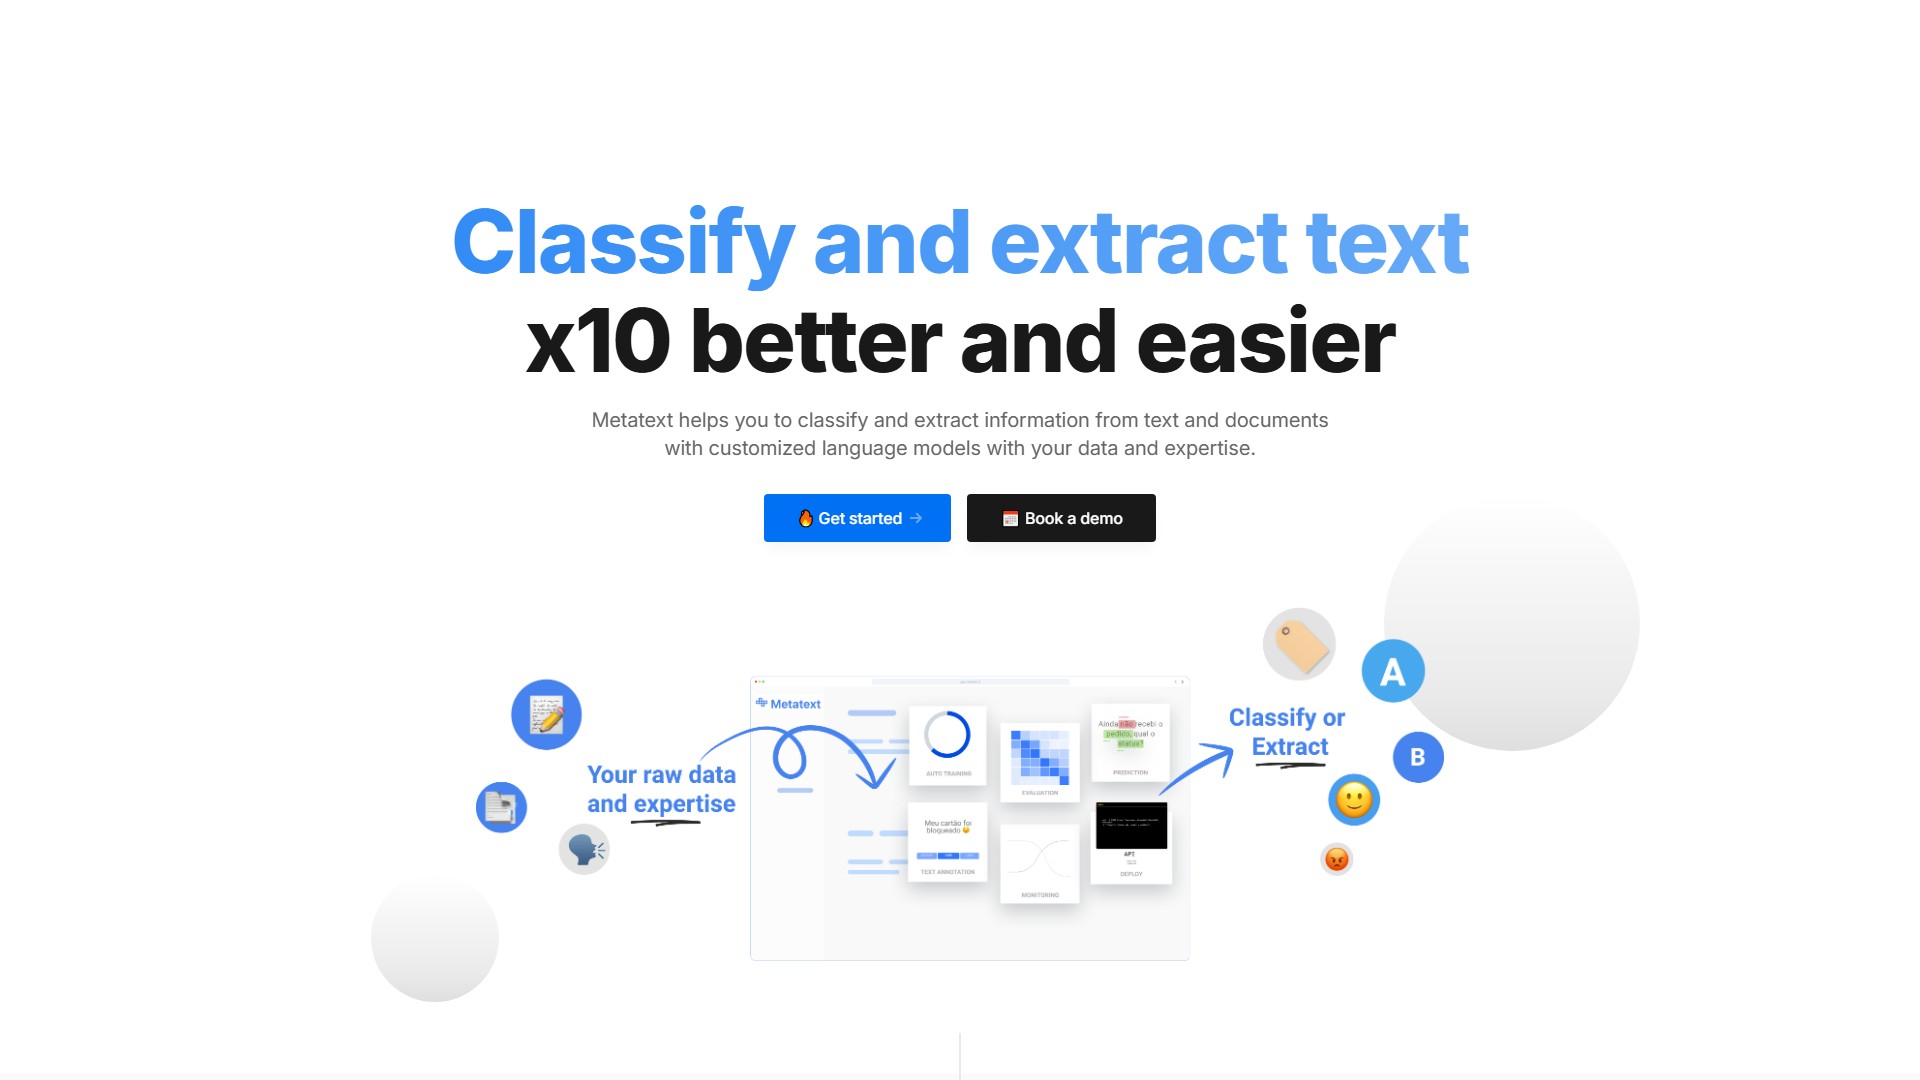
এই টুল সম্পর্কে
প্রধান ফিচার
- টেক্সট শ্রেণিবিন্যাস: বাইনারি, মাল্টি-ক্লাস, মাল্টি-লেবেল, সেন্টিমেন্ট, বিষয় এবং ইন্টেন্ট শ্রেণিবিন্যাসে যেকোনও টেক্সট বা ডকুমেন্টকে শ্রেণিভুক্ত করুন।
- টেক্সট এক্সট্রাকশন: যেকোনও টেক্সট বা ডকুমেন্ট থেকে গুরুত্বপূর্ণ তথ্য, সত্তা ও কীওয়ার্ড বের করে সেগুলোকে স্বাভাবিকীকরণ ও কাঠামোবদ্ধ করুন।
- টেক্সট জেনারেশন: জেনারেটিভ AI অ্যাপ্লিকেশন, RAG, সারসংক্ষেপ, LLM ফাইন-টিউনিং, প্রশ্নোত্তর এবং চ্যাটবট তৈরি করুন; শূন্য থেকে টেক্সট তৈরি করুন বা নিজের ডোমেন অনুযায়ী LLM ফাইন-টিউন করুন।
মূল ফিচার ও সুবিধা
- নো-কোড প্ল্যাটফর্ম: কোডিং বা ML/NLP বিশেষজ্ঞতার প্রয়োজন নেই। মডেলকে আপনার প্রয়োজন ব্যাখ্যা করুন এবং নিজের ডেটা ও অভিজ্ঞতা থেকে শিখতে দিন।
- AutoNLP ইঞ্জিন: প্ল্যাটফর্মে নিজের ডেটা ও অভিজ্ঞতা দিন; AutoNLP ইঞ্জিন আপনার ব্যবহারের ক্ষেত্রে সেরা মডেলটি প্রশিক্ষণ ও ফাইন-টিউন করবে।
- LLM Distillation পদ্ধতি: LLM-এর শক্তিকে একটি পুনরাবৃত্তিমূলক প্রক্রিয়ায় কাজে লাগিয়ে ডেটাকে ব্যক্তিগত ও স্কেলযোগ্য কাস্টম মডেলে রূপান্তর করুন। কম ডেটা ও সময়ে ছোট মডেলকে x10 বেশি কার্যকরভাবে প্রশিক্ষণ দেওয়া যায়।
- Trustful Evaluation: মডেলের কর্মক্ষমতা বোঝা এবং কীভাবে উন্নত করা যায় তা নির্ধারণে সাহায্য করে। সফলতার জন্য নির্ভরযোগ্য মডেল গুরুত্বপূর্ণ।
- দ্রুত ডিপ্লয়মেন্ট ও ইন্টিগ্রেশন: কয়েকটি ক্লিকেই মডেল ডিপ্লয় করুন এবং API, Zapier, Google Sheets, Docker, AWS, Hugging Face ও আরও অনেক কিছুর মাধ্যমে সিস্টেমের সঙ্গে যুক্ত করুন।
- ব্ল্যাক বক্স ও vendor lock-in নেই: ব্ল্যাক বক্স, ভেন্ডর-নির্ভরতা বা ডেটা গোপনীয়তার সমস্যা ছাড়াই কাস্টম NLP মডেল তৈরি ও পরিচালনা করুন।
সাধারণ ব্যবহার
- কাস্টমার সাপোর্ট: কাস্টমার টিকিট দ্রুত শ্রেণিবদ্ধ ও উত্তর দিন, যাতে জটিল সমস্যায় বেশি সময় দেওয়া যায়।
- কাস্টমার ইনসাইট: রিভিউকে বিষয়, সমস্যা, সেন্টিমেন্ট ও এনগেজমেন্ট অনুযায়ী স্বয়ংক্রিয়ভাবে শ্রেণিবদ্ধ করুন।
- কনটেন্ট মডারেশন: অনুপযুক্ত, আপত্তিকর বা ক্ষতিকর কনটেন্ট স্বয়ংক্রিয়ভাবে শনাক্ত ও সরিয়ে দিন।
- স্বাস্থ্যসেবা: মেডিকেল রেকর্ড, ল্যাব রিপোর্ট ও রোগীর মতামত থেকে গুরুত্বপূর্ণ ডেটা বের করুন।
- অর্থনীতি: বাজারের সেন্টিমেন্ট, রিপোর্ট ও কাস্টমার ফিডব্যাক বিশ্লেষণ করুন।
- হিউম্যান রিসোর্সেস (HR): দক্ষতা, অভিজ্ঞতা ও যোগ্যতাকে চাকরির প্রয়োজনীয়তার সঙ্গে মিলিয়ে উপযুক্ত প্রার্থী শনাক্ত করুন।
লক্ষ্য ব্যবহারকারী
ডেভেলপার, ব্যবসায়িক বিশ্লেষক, ডেটা সায়েন্টিস্ট এবং টেক্সট শ্রেণিবিন্যাসের জন্য দ্রুত ও দক্ষভাবে NLP মডেল প্রশিক্ষণ ও ডিপ্লয় করতে চান এমন যেকেউ।
মূল্য ও প্ল্যান
মডেল প্রশিক্ষণ বা API কিংবা inference preview-এর মাধ্যমে predictions (inferences) করার জন্য Credits সিস্টেম ব্যবহার করা হয়। তিনটি স্তর রয়েছে:
- Starter (ফ্রি): প্রতি মাসে 500 credits, সর্বোচ্চ 5টি প্রজেক্ট, প্রতি প্রজেক্টে সর্বোচ্চ 1,000টি রেকর্ড, প্রতি প্রজেক্টে সর্বোচ্চ 10টি model versions, আনলিমিটেড labels, পাবলিক ভিজিবিলিটি, কম GPU ক্ষমতা এবং স্ট্যান্ডার্ড সাপোর্ট।
- Pro ($185/মাস): Starter-এর সবকিছুর সঙ্গে প্রতি মাসে 80,000 credits, আনলিমিটেড প্রজেক্ট, প্রতি প্রজেক্টে সর্বোচ্চ 10k রেকর্ড, আনলিমিটেড model versions, visibility control, উন্নত GPU ক্ষমতা এবং অগ্রাধিকার সাপোর্ট।
- Enterprise (কাস্টম): PRO-এর সবকিছুর সঙ্গে কাস্টম মূল্য ও রিসোর্স, on-premise এবং dedicated AI engineer। একাডেমিক গবেষণার জন্য ছাড় রয়েছে।
প্রায়শই জিজ্ঞাসিত প্রশ্ন
Metatext একাধিক ভাষা সমর্থন করে; কাস্টম ডেটাসেট (CSV, TXT, PDF, DOCX ইত্যাদি) আপলোড করা এবং API-এর মাধ্যমে ইমপোর্ট করা যায়। টেক্সট শ্রেণিবিন্যাসে labels আনলিমিটেড। প্রশিক্ষিত মডেল সরাসরি ডাউনলোড করা যায় না, তবে APIs-এর মাধ্যমে ইন্টিগ্রেট করা যায়। Metatext কাস্টম NLP মডেল তৈরি ও ডিপ্লয়ের জন্য, আর ChatGPT ও GPT সাধারণ উদ্দেশ্যের ভাষা মডেল—যেগুলো মানবসদৃশ টেক্সট তৈরি ও কথোপকথনমূলক AI-তে কেন্দ্রীভূত।
ট্রাফিক বিশ্লেষণ
এই টুলের ট্রাফিক, র্যাঙ্কিং ও এনগেজমেন্টের সংকেত।
ভিজিটের প্রবণতা
প্রবণতার কোনো ডেটা নেই
এনগেজমেন্ট
- বাউন্স রেট--
- প্রতি ভিজিটে পৃষ্ঠা--
- গড় সময়কাল--
ট্রাফিকের উৎস
উৎসের কোনো ডেটা নেই
শীর্ষ দেশসমূহ
দেশের কোনো ডেটা নেই
ইন্টারফেসের প্রিভিউ