Об этом инструменте
Основные возможности
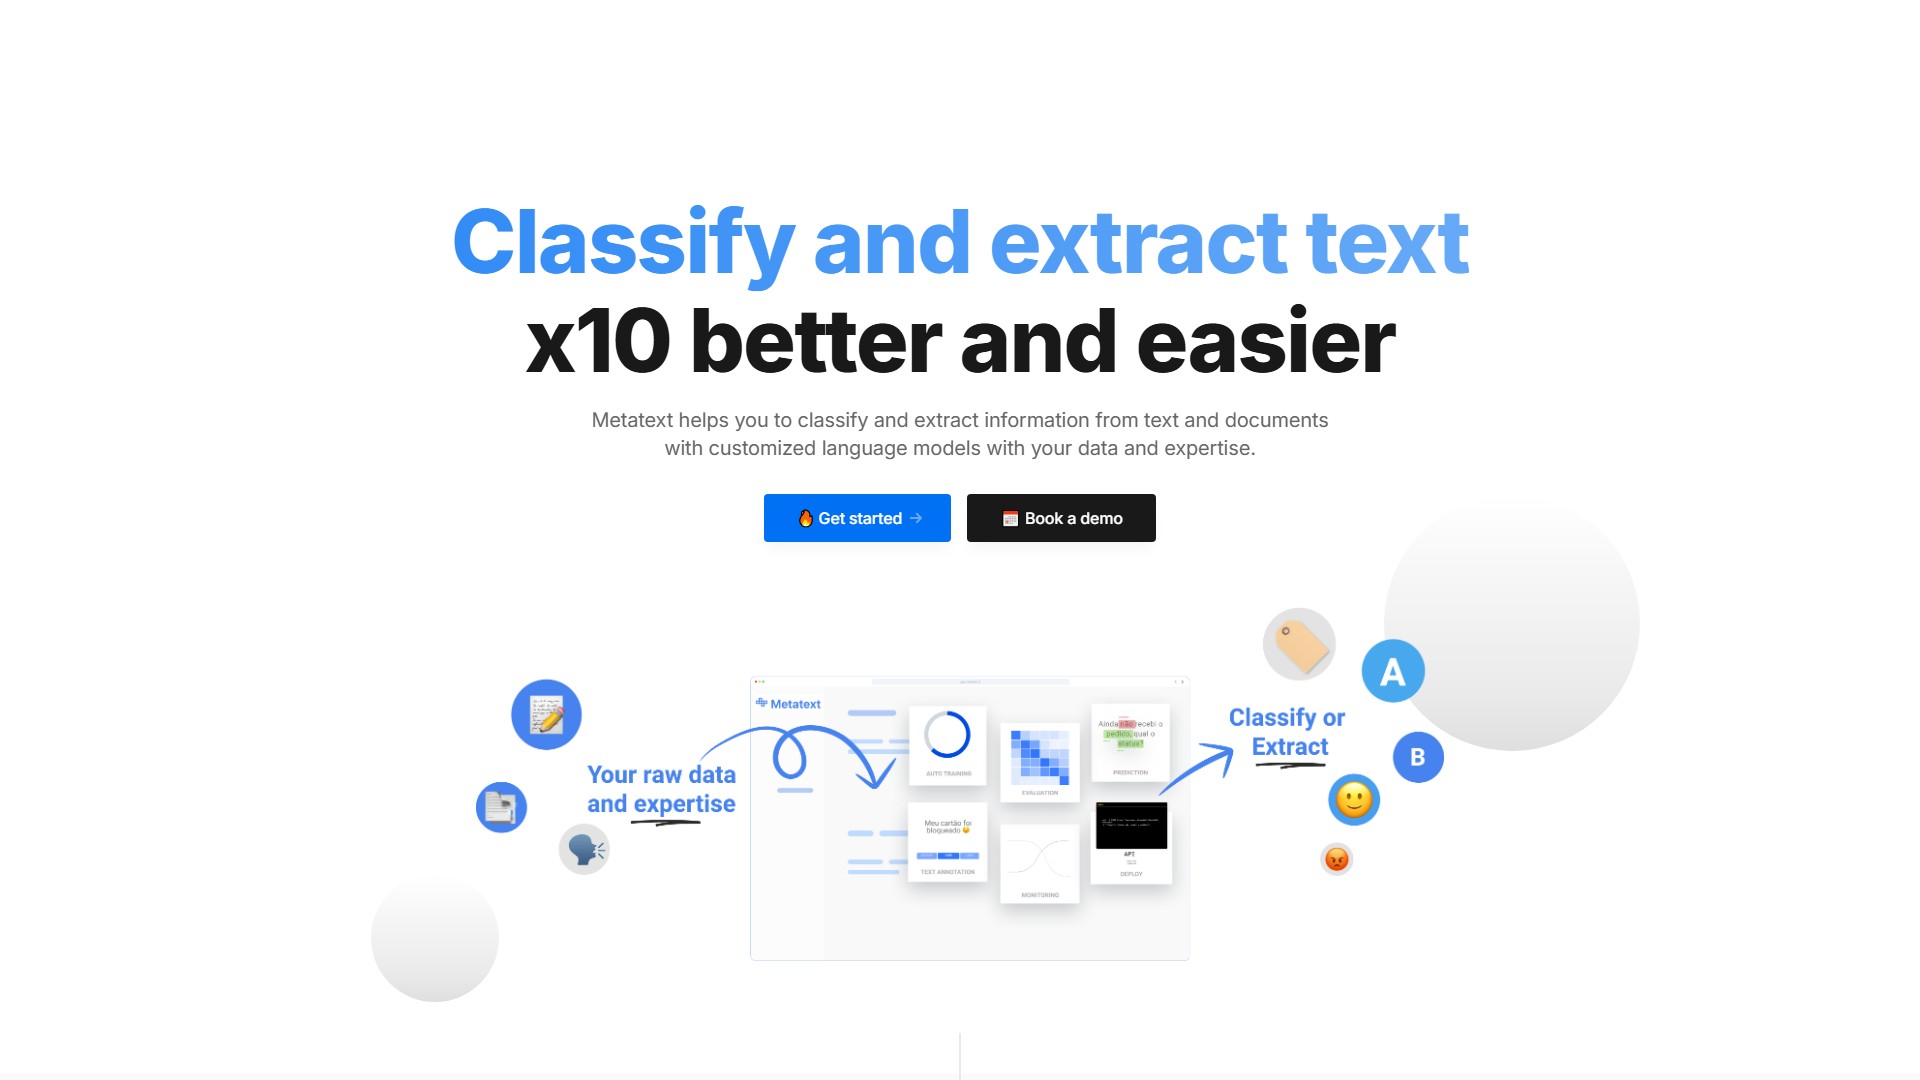
- Классификация текста: бинарная, многоклассовая, многолейбловая классификация, анализ тональности, тем и намерений для категоризации любого текста или документа.
- Извлечение текста: извлекайте, нормализуйте и структурируйте ключевую информацию, сущности и ключевые слова из любого текста или документа.
- Генерация текста: создавайте приложения на основе генеративного AI, RAG, суммаризацию, дообучение LLM, вопросы и ответы и чат-ботов; генерируйте текст с нуля или адаптируйте LLM под свой домен.
Ключевые особенности и преимущества
- No-code-платформа: не требуются навыки программирования или экспертиза в ML/NLP. Объясните модели, что вам нужно, и позвольте ей учиться на ваших данных и опыте.
- Механизм AutoNLP: загрузите данные и экспертизу на платформу, а AutoNLP обучит и дообучит лучшую модель для вашего сценария.
- Методология LLM Distillation: превращайте данные в частные и масштабируемые пользовательские модели, объединяя возможности LLM в итеративном процессе. Это позволяет эффективнее обучать небольшие модели — в 10 раз лучше, используя меньше данных и времени.
- Trustful Evaluation: помогает понять, как работает модель и как ее улучшить. Надежные модели важны для успеха.
- Быстрое развертывание и интеграция: разверните модель за несколько кликов и подключите ее к системам через API, Zapier, Google Sheets, Docker, AWS, Hugging Face и другие сервисы.
- Без черных ящиков и зависимости от поставщика: создавайте и управляйте пользовательскими NLP-моделями без black box, vendor lock-in и проблем с конфиденциальностью данных.
Типичные сценарии использования
- Поддержка клиентов: быстро классифицируйте обращения клиентов и отвечайте на них, оставляя больше времени для сложных вопросов.
- Аналитика клиентов: автоматически классифицируйте отзывы по теме, проблеме, тональности и вовлеченности.
- Модерация контента: автоматически обнаруживайте и удаляйте неприемлемый, оскорбительный или вредоносный контент.
- Здравоохранение: извлекайте критически важные данные из медицинских карт, лабораторных отчетов и отзывов пациентов.
- Финансы: анализируйте рыночные настроения, отчеты и отзывы клиентов.
- HR: находите наиболее подходящих кандидатов, сопоставляя навыки, опыт и квалификацию с требованиями вакансии.
Целевые пользователи
Разработчики, бизнес-аналитики, специалисты по данным и все, кому нужно быстро и эффективно обучать и развертывать NLP-модели для классификации текста.
Цены и планы
Для обучения моделей и выполнения predictions (inferences) через API или inference preview используется система Credits. Доступны три уровня:
- Starter (бесплатно): 500 credits в месяц, до 5 проектов, до 1 000 записей на проект, до 10 версий модели на проект, неограниченное количество labels, публичная видимость, низкая GPU-мощность и стандартная поддержка.
- Pro ($185/месяц): все возможности Starter, а также 80 000 credits в месяц, неограниченное число проектов, до 10k записей на проект, неограниченное число версий модели, управление видимостью, повышенная GPU-мощность и приоритетная поддержка.
- Enterprise (индивидуальные условия): все возможности PRO, индивидуальные цены и ресурсы, on-premise-развертывание и выделенный AI-инженер. Для академических исследований доступны скидки.
Частые вопросы
Поддерживаются разные языки; можно загружать пользовательские наборы данных (CSV, TXT, PDF, DOCX и другие форматы) и импортировать их через API. Для классификации текста labels не ограничены. Обученные модели нельзя скачать напрямую, но их можно интегрировать через APIs. Metatext предназначен для создания и развертывания пользовательских NLP-моделей, в отличие от ChatGPT и GPT — универсальных языковых моделей, ориентированных на генерацию текста, похожего на человеческий, и разговорный AI.
Анализ трафика
Данные о трафике, рейтинге и вовлечённости этого инструмента.
Динамика посещений
Нет данных о динамике
Вовлечённость
- Показатель отказов--
- Страниц за посещение--
- Средняя длительность--
Источники трафика
Нет данных об источниках
Основные страны
Нет данных по странам
Предпросмотр интерфейса