Arte
ControlNet Pose
Crie imagens com a mesma pose da imagem de entrada.
Sobre esta ferramenta
Principais recursos
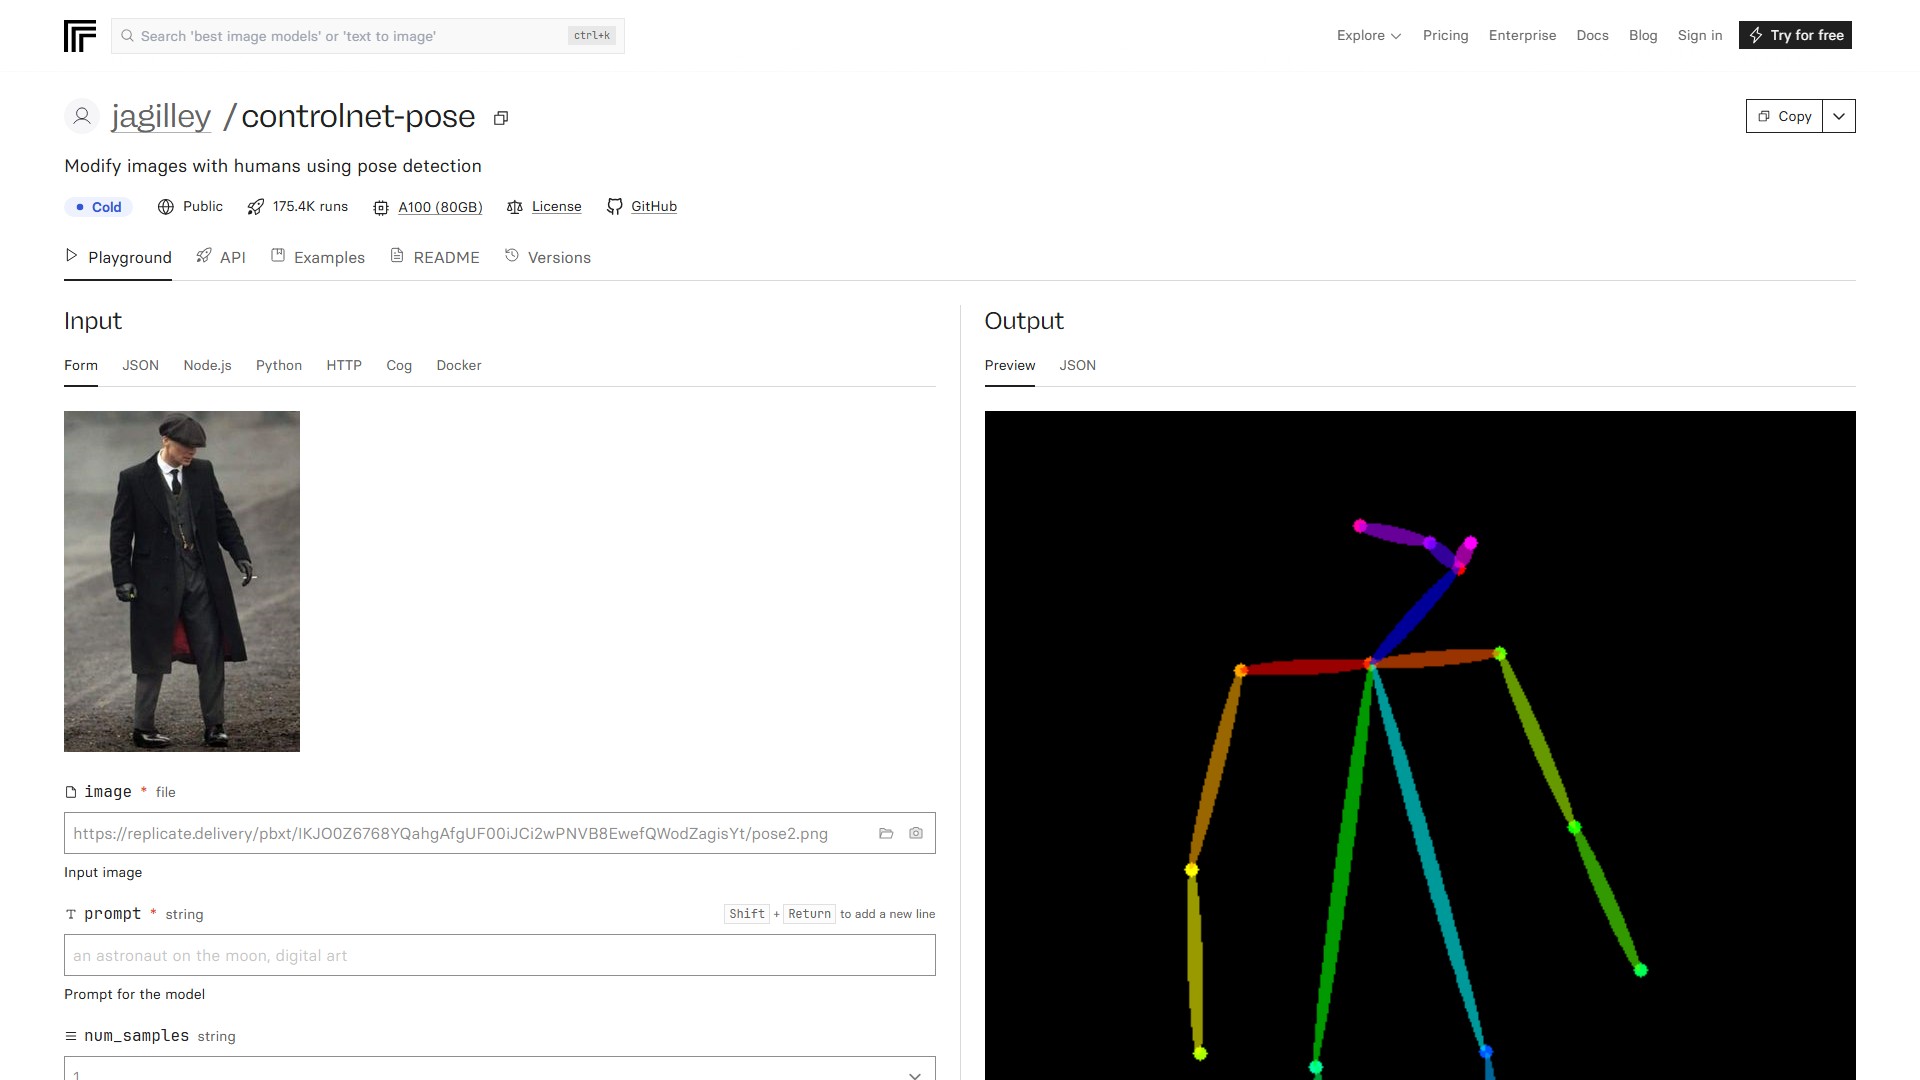
Usa o modelo jagilley/controlnet-pose para modificar imagens com pessoas por meio da detecção de poses. Insira uma imagem e um prompt para gerar uma imagem como no Stable Diffusion; o Openpose detectará a pose automaticamente.
Descrição do modelo
ControlNet é uma estrutura de rede neural que permite controlar grandes modelos de difusão pré-treinados e aceitar condições de entrada adicionais além dos prompts. O ControlNet aprende condições específicas da tarefa de ponta a ponta, com aprendizado robusto mesmo quando o conjunto de treinamento é pequeno (< 50k amostras). Grandes modelos de difusão, como o Stable Diffusion, podem ser ampliados com ControlNets para aceitar entradas condicionais como mapas de bordas, mapas de segmentação e pontos-chave.
Parâmetros de entrada
image: imagem de entrada (obrigatória).prompt: prompt para o modelo (obrigatório; padrão: “an astronaut on the moon, digital art”).num_samples: número de amostras; valores altos podem causar OOM (padrão: “1”).image_resolution: resolução da imagem gerada (padrão: “512”).low_threshold/high_threshold: limites baixo e alto para detecção de linhas Canny (padrão: 100/200).ddim_steps: etapas (padrão: 20).scale: escala para orientação sem classificador (padrão: 9).seed: semente.eta: controla a quantidade de ruído adicionada durante o processo de difusão e remoção de ruído; valores maiores geram mais ruído (padrão: 0).a_prompt: texto adicional anexado ao prompt (padrão: “best quality, extremely detailed”).n_prompt: prompt negativo (padrão: “longbody, lowres, bad anatomy...”)detect_resolution: resolução na qual o método de detecção será aplicado (padrão: 512).
Uso e custo
Pode ser executado no Replicate via Node.js, Python e API HTTP, ou localmente usando Cog e Docker. Destina-se a desenvolvedores de IA e entusiastas de geração de imagens. Sua principal vantagem é gerar imagens de alta qualidade a partir de prompts de texto preservando rigorosamente a pose humana da imagem de entrada.
O modelo custa aproximadamente $0.15 por execução no Replicate, ou 6 execuções por $1, dependendo das entradas. Ele usa uma GPU Nvidia A100 (80GB). As previsões normalmente são concluídas em 108 segundos. A primeira chamada à API inicializa o modelo frio e pode demorar mais.
Análise de tráfego
Sinais de tráfego, classificação e engajamento desta ferramenta.
Tendência de visitas
Não há dados de tendência
Engajamento
- Taxa de rejeição--
- Páginas por visita--
- Duração média--
Fontes de tráfego
Não há dados de origem
Principais países
Não há dados por país
Prévia da interface