芸術
ControlNet Pose
入力画像と同じポーズの画像を生成するツールです。
このツールについて
主な機能
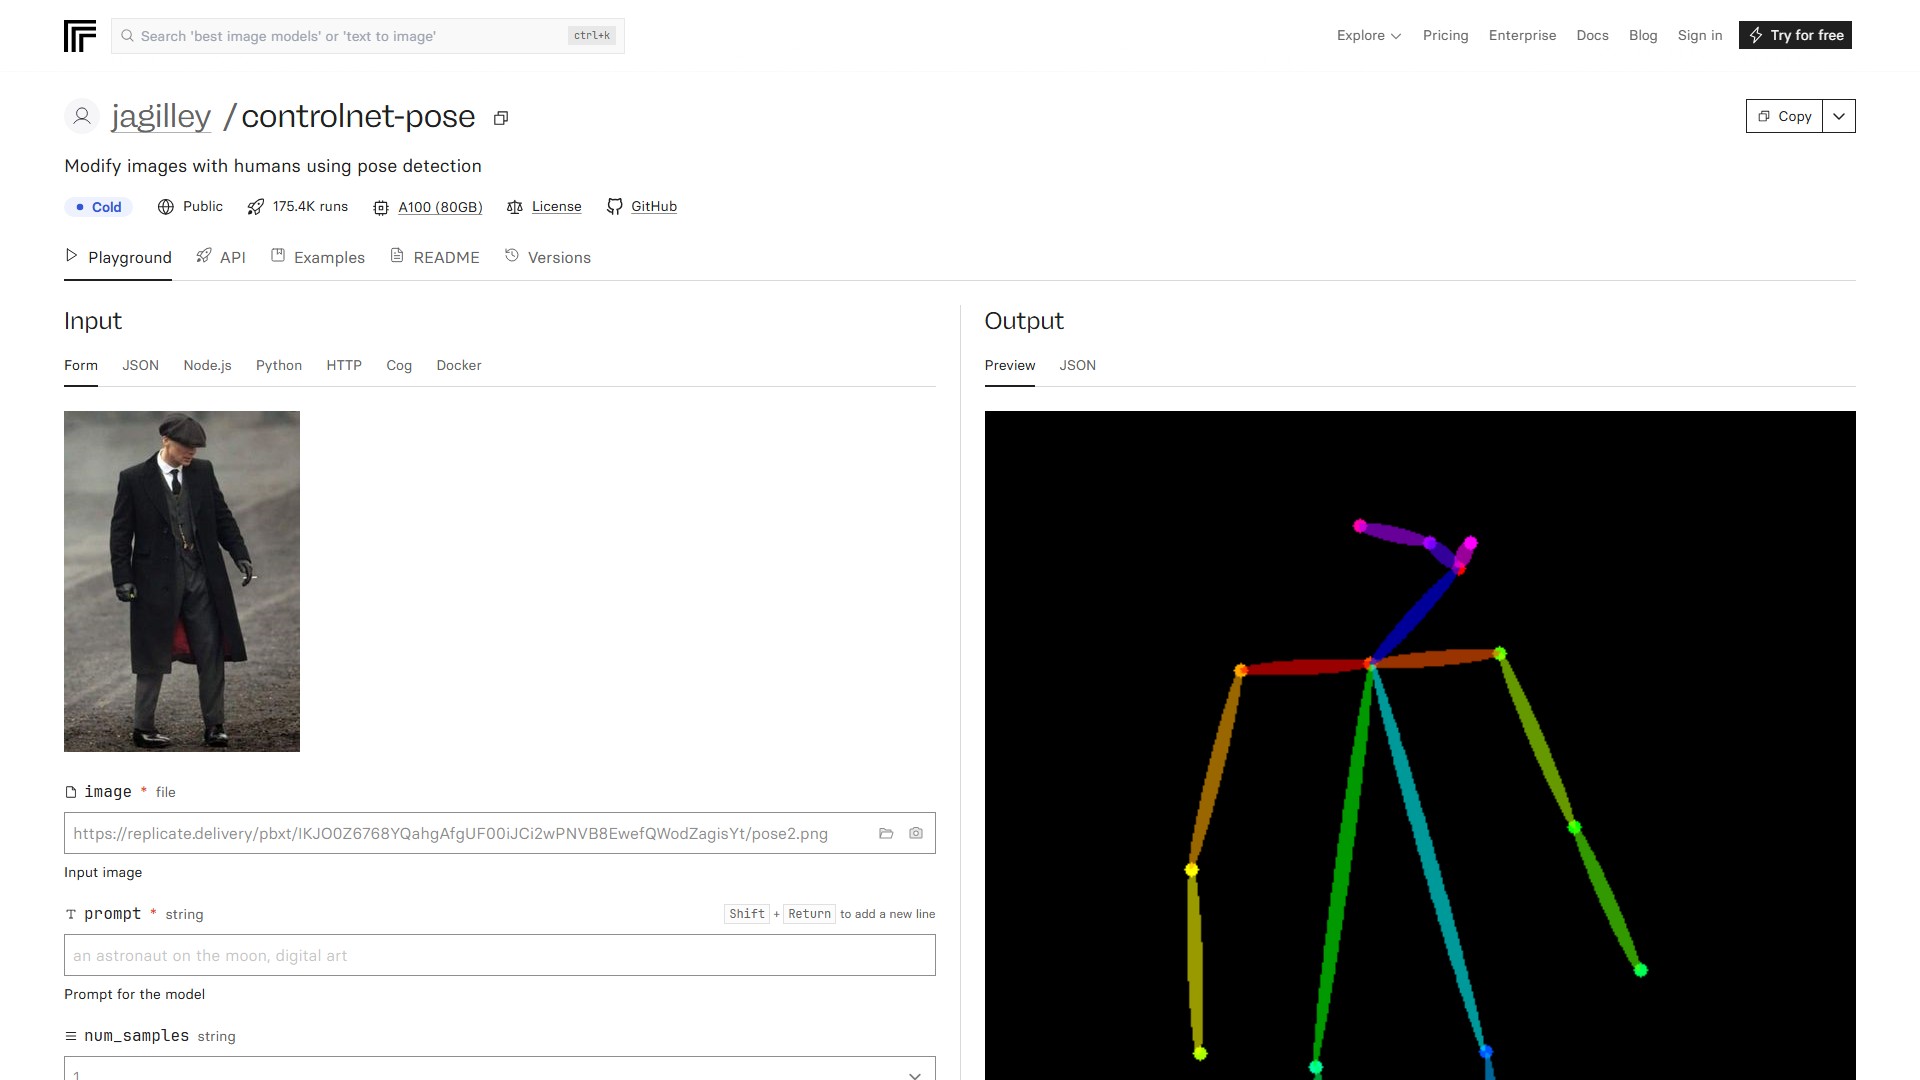
jagilley/controlnet-poseモデルを使用し、ポーズ検出によって人物画像を変更します。画像とプロンプトを入力すると、Stable Diffusionと同じように画像を生成でき、Openposeがポーズを自動検出します。
モデルの説明
ControlNetは、プロンプト以外の追加の入力条件にも対応できるよう、事前学習済みの大規模拡散モデルを制御するニューラルネットワーク構造です。タスク固有の条件をエンドツーエンドで学習し、学習データセットが小さい場合(< 50kサンプル)でも堅牢に学習できます。Stable Diffusionのような大規模拡散モデルにControlNetを追加することで、エッジマップ、セグメンテーションマップ、キーポイントなどの条件付き入力を利用できます。
入力パラメータ
image:入力画像(必須)。prompt:モデルへのプロンプト(必須、デフォルトは"an astronaut on the moon, digital art")。num_samples:サンプル数。大きな値ではOOMが発生する可能性があります(デフォルトは1)。image_resolution:生成する画像の解像度(デフォルトは512)。low_threshold/high_threshold:Canny線検出の下限・上限しきい値(デフォルトは100/200)。ddim_steps:ステップ数(デフォルトは20)。scale:classifier-free guidanceのスケール(デフォルトは9)。seed:シード。eta:ノイズ除去拡散プロセスで追加するノイズ量を制御します。値が高いほどノイズが増えます(デフォルトは0)。a_prompt:プロンプトに追加するテキスト(デフォルトは"best quality, extremely detailed")。n_prompt:ネガティブプロンプト(デフォルトは"longbody, lowres, bad anatomy...")。detect_resolution:検出メソッドを適用する解像度(デフォルトは512)。
利用方法
Replicate上でNode.js、Python、HTTP APIから実行できるほか、CogとDockerを使ってローカルで実行できます。
対象ユーザーと主な利点
AI開発者や画像生成の愛好家を対象としています。Stable Diffusionの生成力とControlNetの正確なポーズ制御を組み合わせ、入力画像の人物ポーズを厳密に保ちながら、テキストプロンプトに基づく高品質な新しい画像を生成できる点が主な利点です。
料金とコスト
Replicateでの実行料金は入力内容によって異なり、1回あたり約$0.15($1で約6回)です。Nvidia A100(80GB)GPUで動作し、予測処理は通常108秒以内に完了します。最初のAPI呼び出しではコールド状態のモデルが起動するため、時間がかかる場合があります。
トラフィック分析
このツールのトラフィック、ランキング、エンゲージメントの指標。
訪問数の推移
トレンドデータなし
エンゲージメント
- 直帰率--
- 1回の訪問あたりのページ数--
- 平均滞在時間--
トラフィックソース
ソースデータなし
上位の国
国別データなし
インターフェースプレビュー