Seni
ControlNet Pose
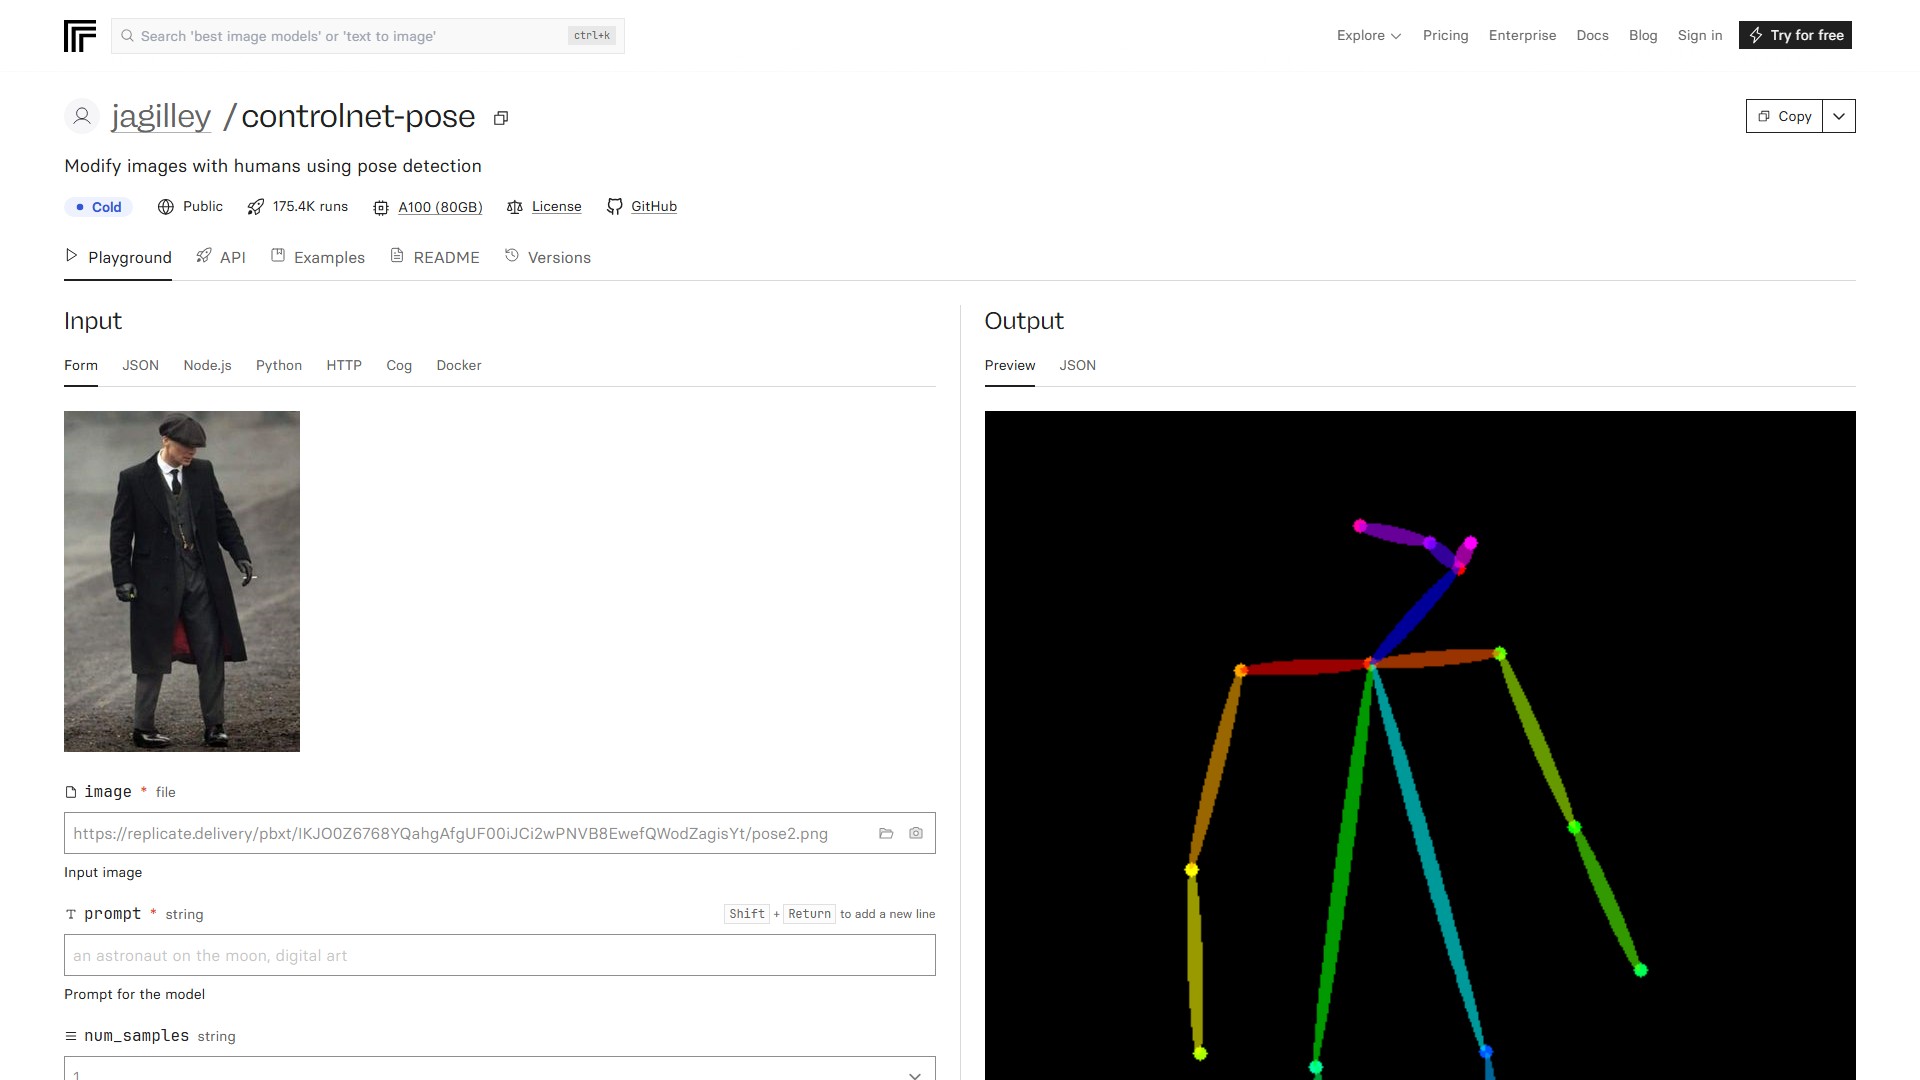
Membuat gambar dengan pose yang sama seperti gambar masukan.
Tentang alat ini
Fitur utama
Menggunakan model jagilley/controlnet-pose untuk memodifikasi gambar yang berisi manusia dengan deteksi pose. Masukkan gambar dan prompt untuk menghasilkan gambar seperti pada Stable Diffusion; Openpose akan mendeteksi pose secara otomatis.
Deskripsi model
ControlNet adalah struktur jaringan neural yang memungkinkan pengendalian model difusi besar yang telah dilatih sebelumnya serta mendukung kondisi masukan tambahan di luar prompt. ControlNet mempelajari kondisi khusus tugas secara menyeluruh dan tetap tangguh meskipun set data pelatihannya kecil (< 50k sampel). Model difusi besar seperti Stable Diffusion dapat ditingkatkan dengan ControlNet untuk mendukung masukan bersyarat seperti peta tepi, peta segmentasi, dan keypoint.
Parameter masukan
image: gambar masukan (wajib).prompt: prompt untuk model (wajib; default: “an astronaut on the moon, digital art”).num_samples: jumlah sampel; nilai lebih tinggi dapat menyebabkan OOM (default: “1”).image_resolution: resolusi gambar yang dihasilkan (default: “512”).low_threshold/high_threshold: ambang rendah/tinggi untuk deteksi garis Canny (default: 100/200).ddim_steps: langkah (default: 20).scale: skala untuk panduan tanpa pengklasifikasi (default: 9).seed: seed.eta: mengontrol jumlah noise yang ditambahkan selama proses difusi denoising; nilai lebih tinggi berarti lebih banyak noise (default: 0).a_prompt: teks tambahan yang ditambahkan ke prompt (default: “best quality, extremely detailed”).n_prompt: prompt negatif (default: “longbody, lowres, bad anatomy...”)detect_resolution: resolusi penerapan metode deteksi (default: 512).
Penggunaan dan biaya
Dapat dijalankan di Replicate melalui Node.js, Python, dan HTTP API, atau secara lokal menggunakan Cog dan Docker. Model ini ditujukan untuk pengembang AI dan penggemar generasi gambar. Keunggulan utamanya adalah menghasilkan gambar berkualitas tinggi dari prompt teks sambil mempertahankan pose manusia pada gambar masukan secara ketat.
Biayanya sekitar $0.15 per eksekusi di Replicate, atau 6 eksekusi per $1, bergantung pada masukan. Model berjalan pada GPU Nvidia A100 (80GB). Prediksi biasanya selesai dalam 108 detik. Panggilan API pertama akan menyalakan model yang sedang dingin dan mungkin memerlukan waktu lebih lama.
Analisis traffic
Sinyal lalu lintas, peringkat, dan interaksi untuk alat ini.
Tren kunjungan
Tidak ada data tren
Interaksi
- Rasio pentalan--
- Halaman per kunjungan--
- Durasi rata-rata--
Sumber traffic
Tidak ada data sumber
Negara teratas
Tidak ada data negara
Pratinjau antarmuka