Art
ControlNet Pose
Créez des images conservant la même pose que l’image d’entrée.
À propos de cet outil
Fonctionnalités principales
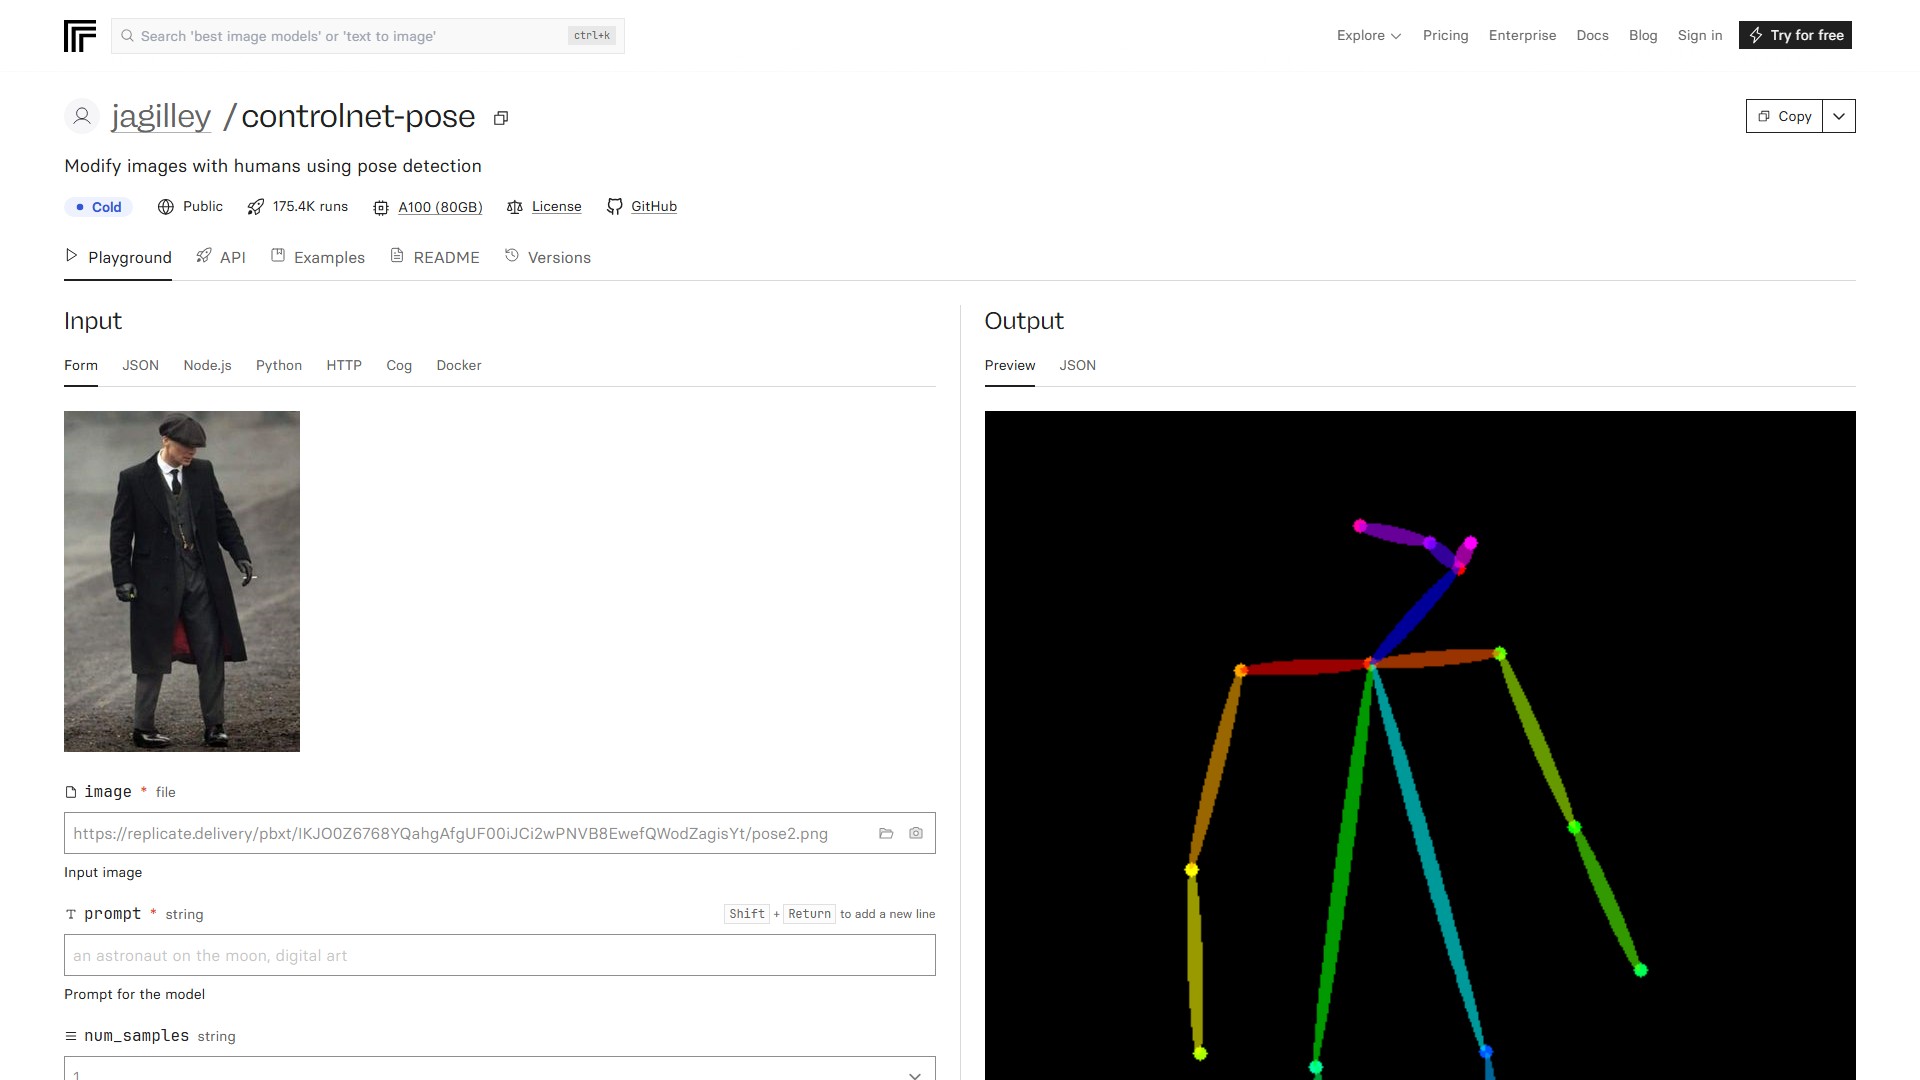
Le modèle jagilley/controlnet-pose utilise la détection de pose pour modifier des images contenant des personnes. Importez une image et saisissez un prompt comme avec Stable Diffusion pour générer une image ; Openpose détecte automatiquement la pose.
Description du modèle
ControlNet est une architecture de réseau neuronal qui permet de contrôler de grands modèles de diffusion préentraînés avec des conditions d’entrée supplémentaires au-delà des prompts. ControlNet apprend ces conditions propres à chaque tâche de manière de bout en bout, et cet apprentissage reste robuste même lorsque le jeu de données d’entraînement est réduit (< 50k échantillons). Les grands modèles de diffusion comme Stable Diffusion peuvent être complétés par des ControlNets afin d’accepter des entrées conditionnelles telles que des cartes de contours, des cartes de segmentation ou des points clés.
Paramètres d’entrée
image: image d’entrée (obligatoire).prompt: prompt du modèle (obligatoire, valeur par défaut :"an astronaut on the moon, digital art").num_samples: nombre d’échantillons ; des valeurs élevées peuvent provoquer une erreur OOM (valeur par défaut :1).image_resolution: résolution de l’image à générer (valeur par défaut :512).low_threshold/high_threshold: seuils inférieur et supérieur de détection des lignes Canny (valeurs par défaut :100/200).ddim_steps: nombre d’étapes (valeur par défaut :20).scale: échelle du guidage sans classifieur (valeur par défaut :9).seed: graine.eta: contrôle la quantité de bruit ajoutée pendant le processus de diffusion avec débruitage ; une valeur plus élevée ajoute davantage de bruit (valeur par défaut :0).a_prompt: texte supplémentaire ajouté au prompt (valeur par défaut :"best quality, extremely detailed").n_prompt: prompt négatif (valeur par défaut :"longbody, lowres, bad anatomy...").detect_resolution: résolution à laquelle la méthode de détection est appliquée (valeur par défaut :512).
Utilisation
Le modèle peut être exécuté sur Replicate via Node.js, Python ou l’API HTTP, ou localement avec Cog et Docker.
Utilisateurs cibles et avantages
Il s’adresse aux développeurs IA et aux amateurs de génération d’images. Son principal avantage est de générer de nouvelles images de haute qualité à partir de prompts textuels tout en préservant strictement la pose humaine de l’image d’entrée, en combinant la puissance générative de Stable Diffusion avec le contrôle précis de la pose de ControlNet.
Tarification et coût
Sur Replicate, ce modèle coûte environ $0.15 par exécution, soit 6 exécutions par $1, selon les entrées. Il fonctionne sur un GPU Nvidia A100 (80GB). Les prédictions se terminent généralement en 108 secondes. Le premier appel API démarre le modèle à froid et peut prendre plus de temps.
Analyse du trafic
Signaux de trafic, de classement et d’engagement pour cet outil.
Tendance des visites
Aucune donnée de tendance
Engagement
- Taux de rebond--
- Pages par visite--
- Durée moyenne--
Sources de trafic
Aucune donnée sur les sources
Principaux pays
Aucune donnée par pays
Aperçu de l’interface