Kunst
ControlNet Pose
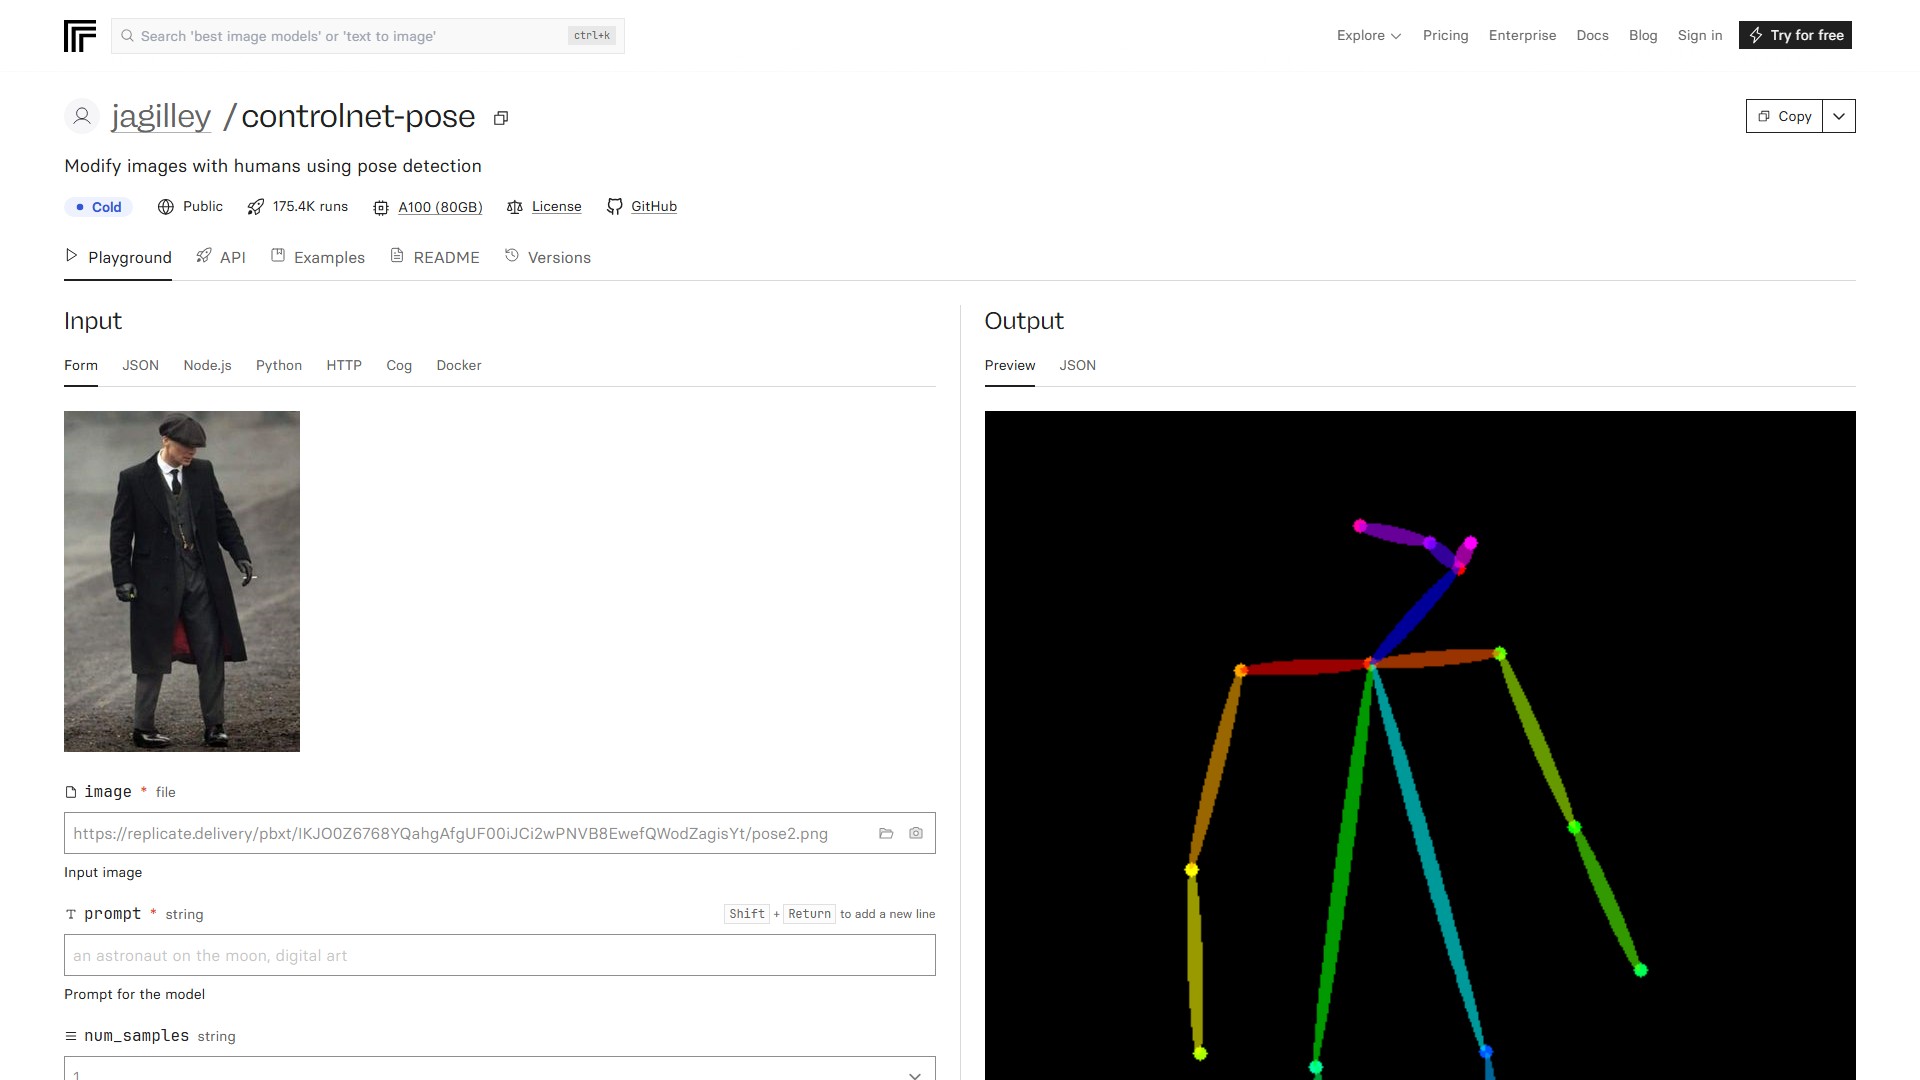
Erstellt Bilder mit derselben Pose wie im Eingabebild.
Über dieses Tool
Wichtigste Funktionen
Verwendet das Modell jagilley/controlnet-pose, um Bilder mit Menschen mithilfe der Pose-Erkennung zu bearbeiten. Geben Sie ein Bild und einen Prompt ein, um wie bei Stable Diffusion ein Bild zu erzeugen; Openpose erkennt die Pose automatisch.
Modellbeschreibung
ControlNet ist eine neuronale Netzwerkstruktur, mit der sich vortrainierte große Diffusionsmodelle steuern und um zusätzliche Eingabebedingungen über Prompts hinaus erweitern lassen. ControlNet lernt aufgabenbezogene Bedingungen durchgängig und bleibt auch bei kleinen Trainingsdatensätzen (< 50k Beispiele) robust. Große Diffusionsmodelle wie Stable Diffusion können durch ControlNets bedingte Eingaben wie Kantenkarten, Segmentierungskarten und Keypoints unterstützen.
Eingabeparameter
image: Eingabebild (erforderlich).prompt: Prompt für das Modell (erforderlich; Standard: „an astronaut on the moon, digital art“).num_samples: Anzahl der Samples; höhere Werte können OOM verursachen (Standard: „1“).image_resolution: Auflösung des erzeugten Bildes (Standard: „512“).low_threshold/high_threshold: niedriger/hoher Schwellenwert für die Canny-Linienerkennung (Standard: 100/200).ddim_steps: Schritte (Standard: 20).scale: Maßstab für die klassifikatorfreie Führung (Standard: 9).seed: Seed.eta: Steuert die während der Diffusion zur Entrauschung hinzugefügte Rauschmenge; ein höherer Wert bedeutet mehr Rauschen (Standard: 0).a_prompt: zusätzlicher Text, der an den Prompt angehängt wird (Standard: „best quality, extremely detailed“).n_prompt: negativer Prompt (Standard: „longbody, lowres, bad anatomy...“)detect_resolution: Auflösung, bei der die Erkennung angewendet wird (Standard: 512).
Nutzung und Kosten
Kann über Node.js, Python und die HTTP-API auf Replicate oder lokal mit Cog und Docker ausgeführt werden. Das Modell richtet sich an KI-Entwickler und Fans der Bildgenerierung. Der zentrale Vorteil ist die Erzeugung hochwertiger Bilder aus Text-Prompts bei gleichzeitiger strikter Beibehaltung der menschlichen Pose aus dem Eingabebild.
Die Ausführung auf Replicate kostet ungefähr $0.15 pro Lauf beziehungsweise 6 Läufe pro $1, abhängig von den Eingaben. Das Modell läuft auf einer Nvidia-A100-GPU (80GB). Vorhersagen werden typischerweise innerhalb von 108 Sekunden abgeschlossen. Der erste API-Aufruf startet das kalte Modell und kann länger dauern.
Traffic-Analyse
Traffic-, Ranking- und Engagement-Signale für dieses Tool.
Besuchstrend
Keine Trenddaten
Engagement
- Absprungrate--
- Seiten pro Besuch--
- Durchschnittliche Dauer--
Traffic-Quellen
Keine Quelldaten
Top-Länder
Keine Länderdaten
Interface-Vorschau