이미지 편집
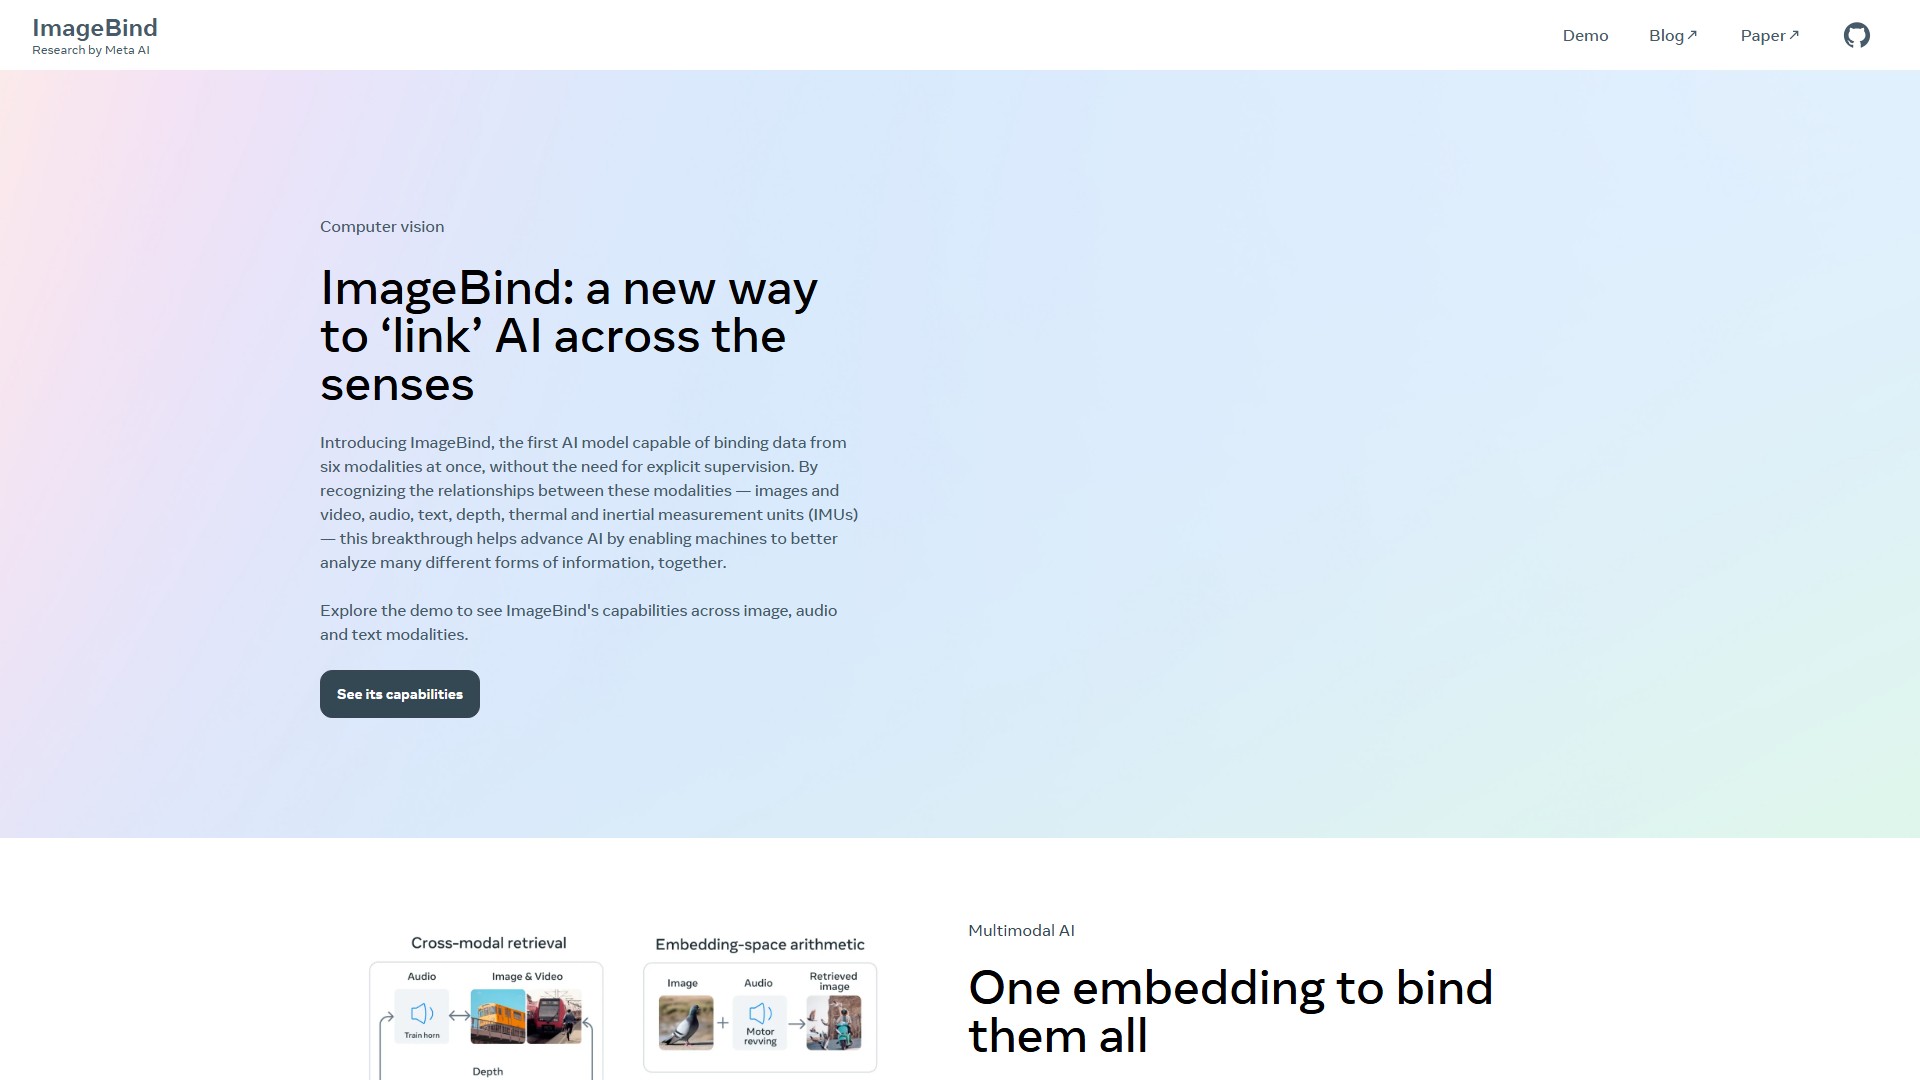
ImageBind
ImageBind는 명시적 감독 없이 6가지 모달리티의 데이터를 연결하는 AI 모델입니다. 이미지, 동영상, 오디오, 텍스트, 깊이, 열 데이터 및 IMU 간 관계를 인식해 AI 분석을 발전시킵니다.
이 도구 정보
주요 기능
ImageBind는 6가지 모달리티(이미지와 동영상, 오디오, 텍스트, 깊이, 열 데이터, 관성 측정 장치/IMU)의 데이터를 명시적 감독 없이 한 번에 연결할 수 있는 최초의 AI 모델입니다. 여러 감각 입력을 연결하는 단일 임베딩 공간을 학습해 기존 AI 모델을 확장하고, 6가지 모달리티 중 어느 것에서든 입력을 받을 수 있도록 합니다. 이를 통해 오디오 기반 검색, 크로스 모달 검색, 멀티모달 산술 및 크로스 모달 생성이 가능해집니다.
핵심 장점
ImageBind는 모달리티 간 관계를 인식하는 데 획기적인 발전을 보여 주며, 기계가 다양한 형태의 정보를 함께 더 잘 분석할 수 있도록 합니다. 오픈 소스 ImageBind 모델은 모달리티 전반의 새로운 제로샷 인식 과제에서 SOTA(state-of-the-art) 성능을 달성하며, 해당 모달리티에 특화해 학습된 기존 전문 모델보다도 뛰어난 성능을 보입니다. 제로샷 및 퓨샷 인식도 지원합니다.
사용 방법
사용자는 웹사이트의 데모 페이지에서 이미지, 오디오 및 텍스트 모달리티에 걸친 ImageBind의 기능을 살펴볼 수 있습니다. 개발자는 GitHub에서 오픈 소스 코드에 접근해 통합 및 개발에 활용할 수 있습니다.
기타 정보
모델과 코드는 오픈 소스로 제공됩니다. 페이지에는 가격 또는 요금 정보가 언급되어 있지 않습니다.
트래픽 분석
이 도구의 트래픽, 순위 및 참여도 지표입니다.
방문 추이
추이 데이터 없음
참여도
- 이탈률--
- 방문당 페이지 수--
- 평균 체류 시간--
트래픽 소스
소스 데이터 없음
주요 국가
국가 데이터 없음
인터페이스 미리보기