Редактирование изображений
ImageBind
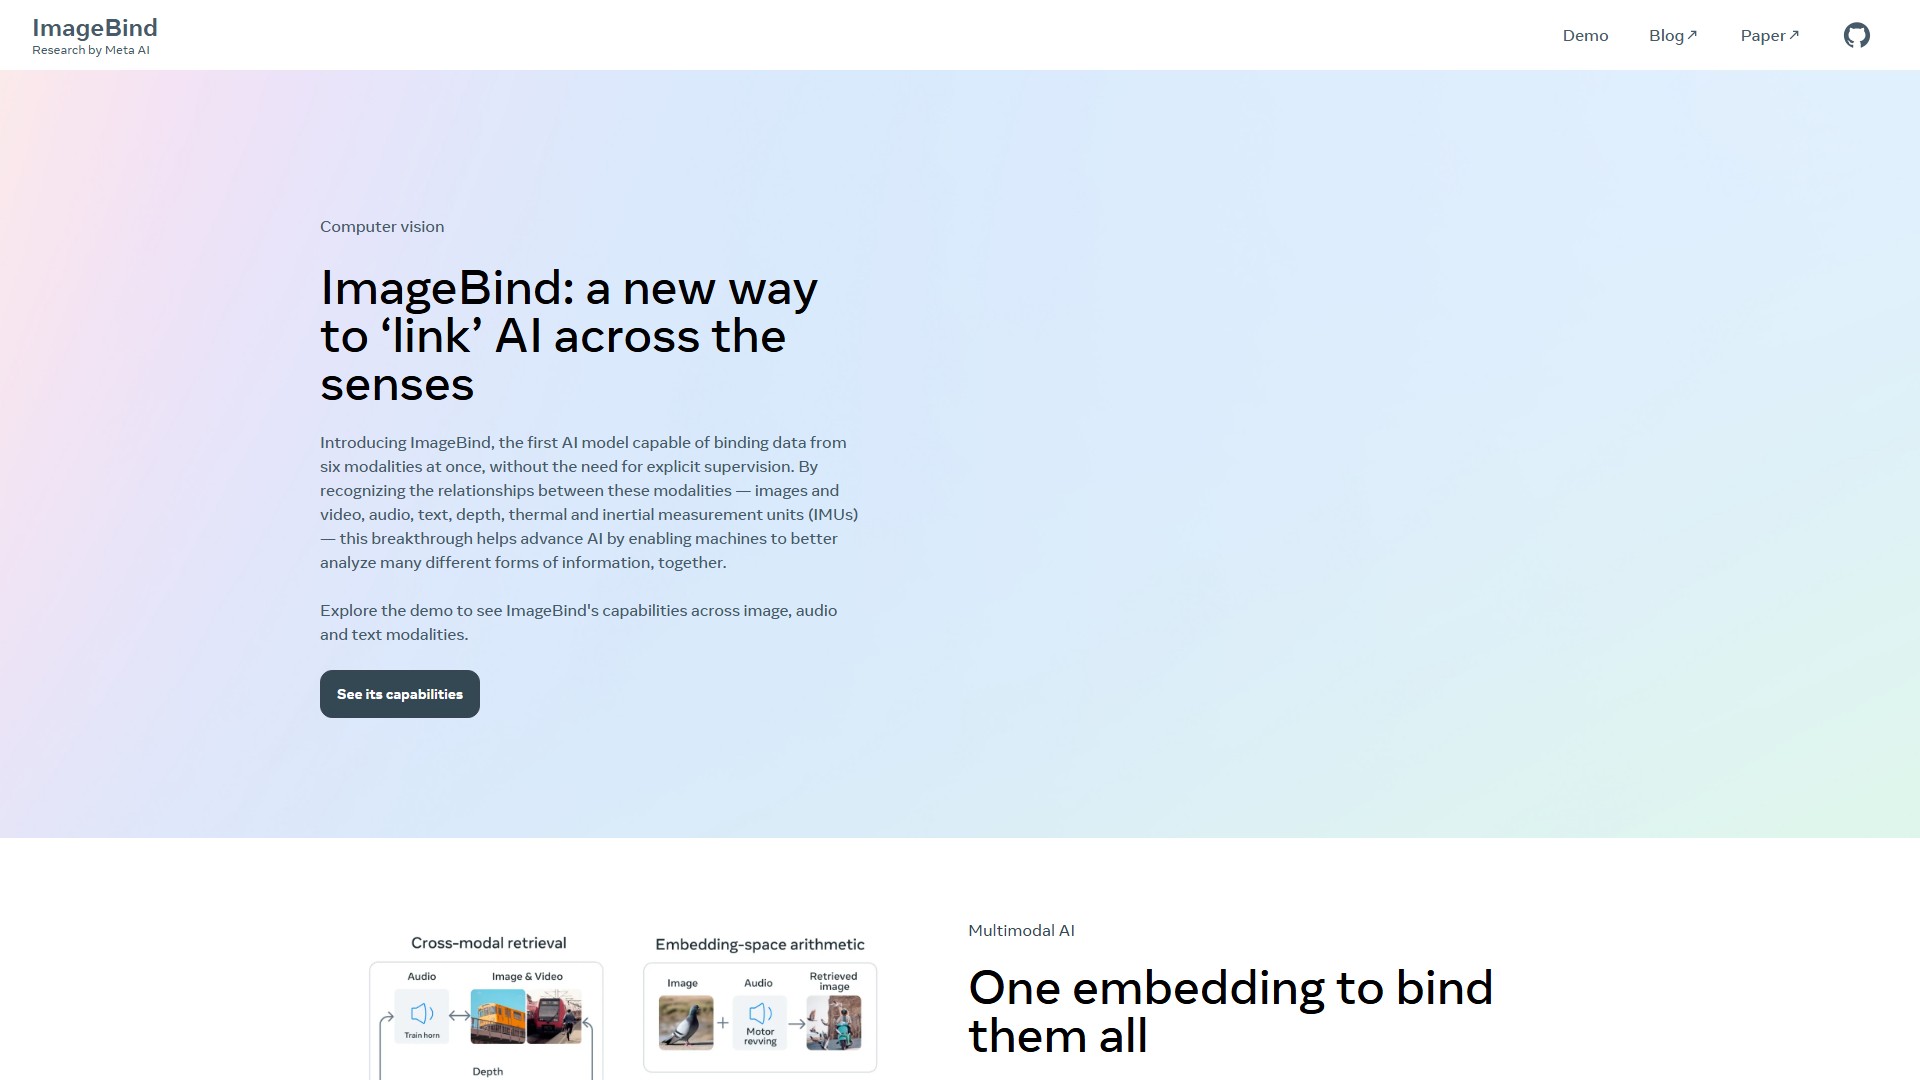
ImageBind — это ИИ-модель, объединяющая данные из 6 модальностей без явного обучения с учителем. Она распознаёт связи между изображениями, видео, аудио, текстом, данными глубины, тепловыми данными и IMU для расширения возможностей ИИ-анализа.
Об этом инструменте
Основные функции
ImageBind — первая ИИ-модель, способная одновременно объединять данные из шести модальностей — изображений и видео, аудио, текста, данных глубины, тепловых данных и инерциальных измерительных модулей (IMU) — без необходимости в явном обучении с учителем. Обучаясь единому embedding space, связывающему несколько сенсорных входов, модель может расширить существующие ИИ-модели, добавив поддержку любого из шести типов данных. Это позволяет выполнять поиск по аудио, кросс-модальный поиск, мультимодальную арифметику и кросс-модальную генерацию.
Основные преимущества
Модель демонстрирует прорыв в распознавании связей между модальностями, помогая машинам лучше анализировать различные формы информации вместе. Открытая модель ImageBind показывает новый результат SOTA (state-of-the-art) в новых задачах zero-shot распознавания между модальностями и превосходит предыдущие специализированные модели, обученные отдельно для этих модальностей. Она также поддерживает zero-shot и few-shot распознавание.
Инструкции по использованию
Пользователи могут изучить возможности ImageBind для изображений, аудио и текста на странице Demo сайта. Разработчики могут получить открытый исходный код через GitHub для интеграции и разработки.
Другая информация
Модель и код предоставляются как открытое программное обеспечение. На странице нет информации о ценах или плате.
Анализ трафика
Данные о трафике, рейтинге и вовлечённости этого инструмента.
Динамика посещений
Нет данных о динамике
Вовлечённость
- Показатель отказов--
- Страниц за посещение--
- Средняя длительность--
Источники трафика
Нет данных об источниках
Основные страны
Нет данных по странам
Предпросмотр интерфейса