画像編集
ImageBind
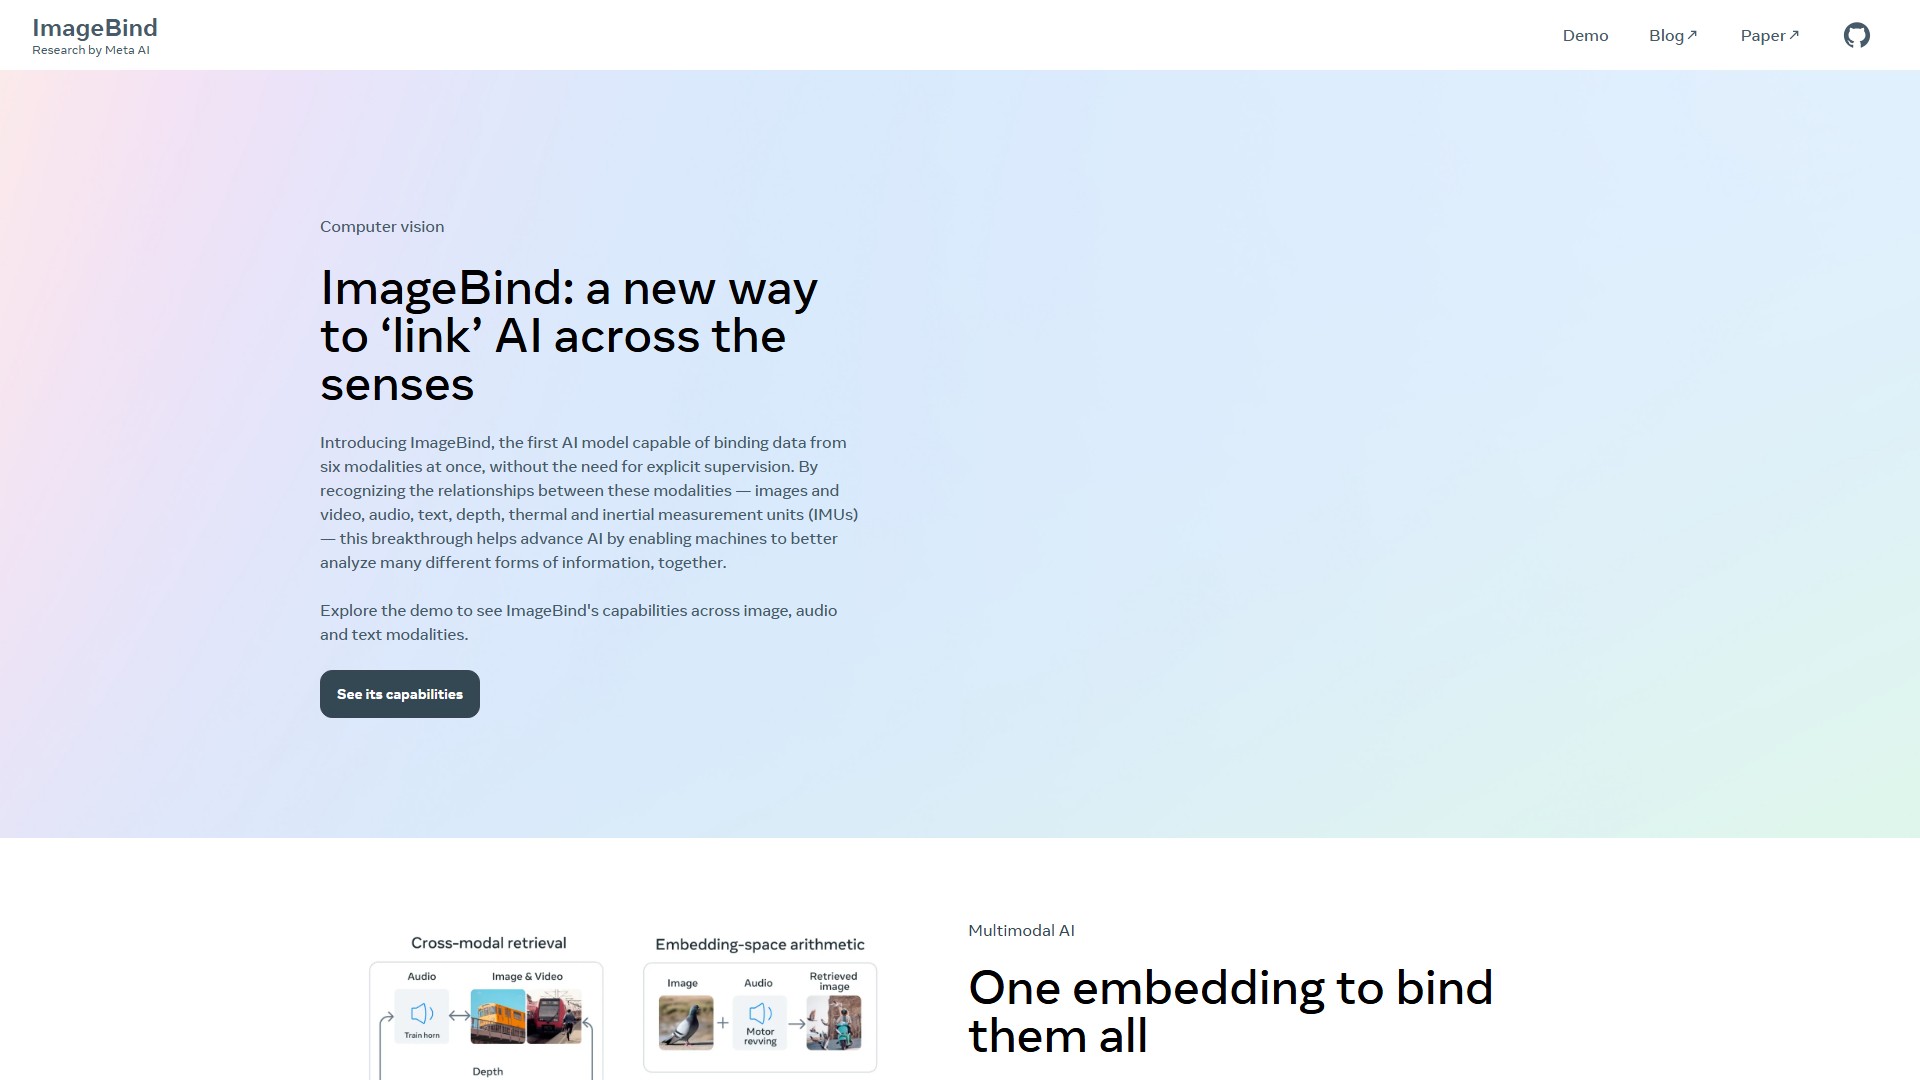
ImageBindは、明示的な教師あり学習なしで6つのモダリティのデータを結び付けるAIモデルです。画像、動画、音声、テキスト、深度、熱、IMUの関係を認識し、AI分析を高度化します。
閲覧数
68.2K
月間訪問数
68.2K
世界ランキング
#- -
票数
0
このツールについて
主な機能
ImageBindは、6つのモダリティ(画像と動画、音声、テキスト、深度、熱、慣性計測ユニット/IMU)のデータを、明示的な教師あり学習なしで一度に結び付けられる初のAIモデルです。複数の感覚入力を結び付ける単一の埋め込み空間を学習することで、既存のAIモデルを拡張し、6つのモダリティのいずれからの入力にも対応できるようにします。これにより、音声検索、クロスモーダル検索、マルチモーダル算術、クロスモーダル生成が可能になります。
主な利点
ImageBindは、モダリティ間の関係認識における画期的な進歩を特徴とし、機械がさまざまな形式の情報を組み合わせて分析する能力を高めます。オープンソースのImageBindモデルは、モダリティ間の新たなゼロショット認識タスクで、SOTA(state-of-the-art)の性能を達成します。各モダリティ向けに個別に訓練された従来の特化モデルを上回る性能も示します。また、ゼロショット認識とフューショット認識にも対応します。
使用方法
ユーザーは、ウェブサイトのデモページで画像、音声、テキストのモダリティにおけるImageBindの機能を試せます。開発者はGitHubからオープンソースコードにアクセスし、統合や開発に利用できます。
その他の情報
モデルとコードはオープンソースで提供されています。ページ上に料金や手数料の情報は記載されていません。
トラフィック分析
このツールのトラフィック、ランキング、エンゲージメントの指標。
世界ランキング
#- -
国別ランキング
#- -
月間訪問数
68.2K
訪問数の推移
トレンドデータなし
エンゲージメント
- 直帰率--
- 1回の訪問あたりのページ数--
- 平均滞在時間--
トラフィックソース
ソースデータなし
上位の国
国別データなし
インターフェースプレビュー