تصویر میں ترمیم
ImageBind
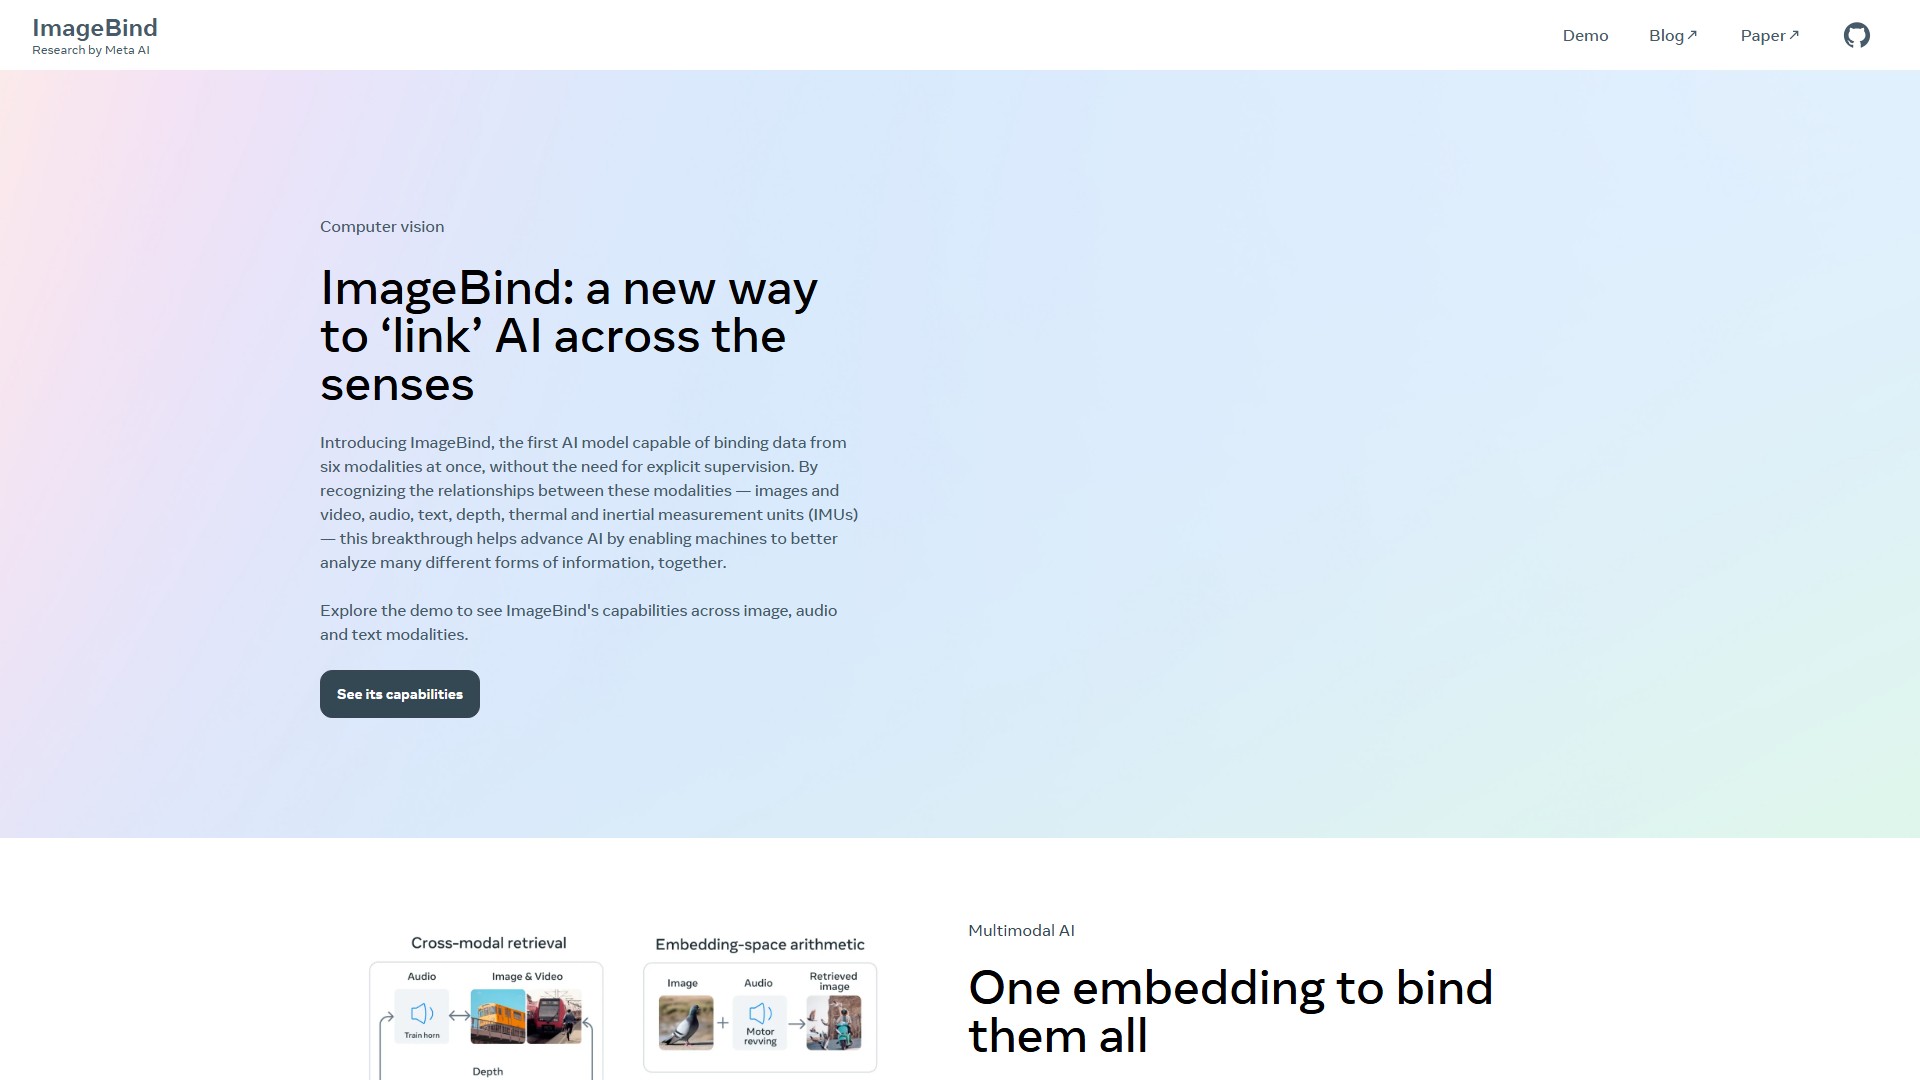
ImageBind ایک AI ماڈل ہے جو واضح نگرانی کے بغیر 6 اقسام کے ڈیٹا کو باہم مربوط کرتا ہے۔ یہ AI تجزیے کو بہتر بنانے کے لیے تصاویر، ویڈیو، آڈیو، متن، گہرائی، حرارتی ڈیٹا اور IMUs کے درمیان تعلقات کو پہچانتا ہے۔
اس ٹول کے بارے میں
اہم خصوصیات
ImageBind پہلا AI ماڈل ہے جو واضح نگرانی کی ضرورت کے بغیر بیک وقت چھ اقسام کے ڈیٹا—تصاویر اور ویڈیو، آڈیو، متن، گہرائی، حرارتی ڈیٹا اور inertial measurement units (IMUs)—کو باہم مربوط کر سکتا ہے۔ متعدد حسی ان پٹس کو جوڑنے والی ایک واحد embedding space سیکھ کر یہ موجودہ AI ماڈلز کو چھ میں سے کسی بھی قسم کے ان پٹ کی معاونت کے لیے بہتر بنا سکتا ہے۔ اس سے آڈیو پر مبنی تلاش، cross-modal تلاش، multimodal arithmetic اور cross-modal generation ممکن ہوتی ہے۔
اہم فوائد
یہ مختلف اقسام کے ڈیٹا کے درمیان تعلقات کو پہچاننے میں اہم پیش رفت پیش کرتا ہے، جس سے مشینیں متعدد شکلوں کی معلومات کا بہتر طور پر مشترکہ تجزیہ کر سکتی ہیں۔ اوپن سورس ImageBind ماڈل مختلف modalities کے درمیان ابھرتے ہوئے zero-shot recognition کاموں پر نیا SOTA (state-of-the-art) مظاہرہ کرتا ہے اور ان modalities کے لیے خاص طور پر تربیت یافتہ سابقہ ماہر ماڈلز سے بھی بہتر کارکردگی دکھاتا ہے۔ یہ zero-shot اور few-shot recognition بھی ممکن بناتا ہے۔
استعمال کی ہدایات
صارفین ویب سائٹ کے Demo صفحے پر تصاویر، آڈیو اور متن کی modalities میں ImageBind کی صلاحیتیں دیکھ سکتے ہیں۔ ڈویلپرز انضمام اور ترقی کے لیے GitHub کے ذریعے اوپن سورس کوڈ حاصل کر سکتے ہیں۔
دیگر معلومات
ماڈل اور کوڈ اوپن سورس کے طور پر فراہم کیے گئے ہیں۔ صفحے پر قیمت یا فیس سے متعلق کوئی معلومات درج نہیں ہے۔
ٹریفک کا تجزیہ
اس ٹول کے ٹریفک، رینکنگ اور انگیجمنٹ کے اشارے۔
وزٹس کا رجحان
رجحان کا کوئی ڈیٹا نہیں
انگیجمنٹ
- باؤنس ریٹ--
- فی وزٹ صفحات--
- اوسط دورانیہ--
ٹریفک کے ذرائع
ذرائع کا کوئی ڈیٹا نہیں
سرفہرست ممالک
ممالک کا کوئی ڈیٹا نہیں
انٹرفیس کا پیش نظارہ