
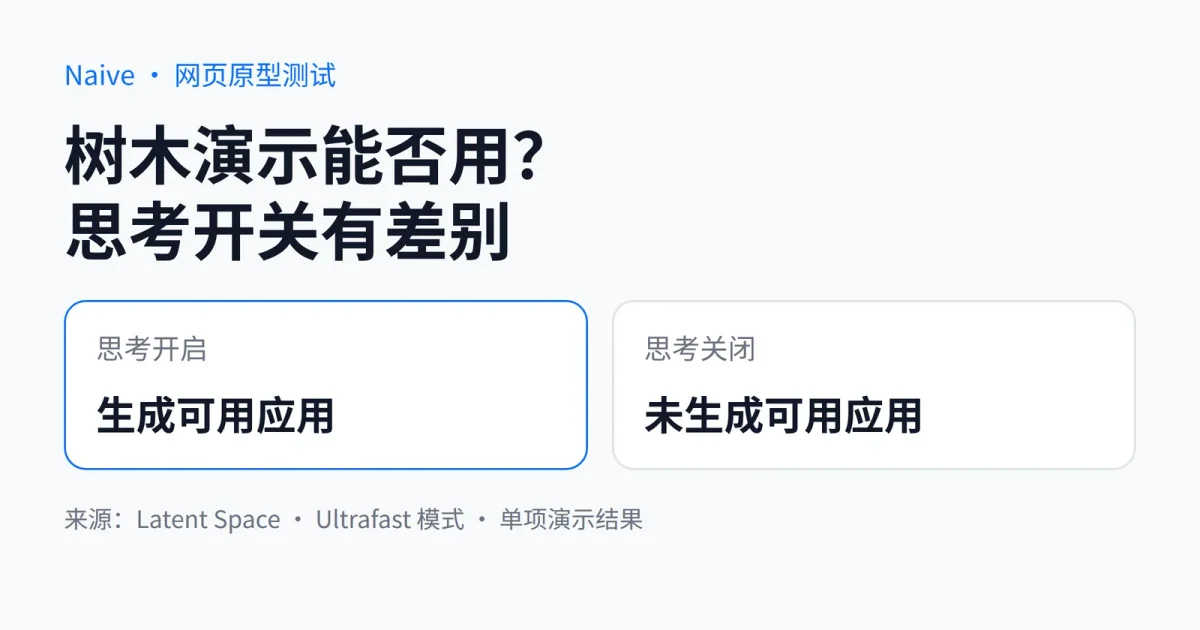
想用 Naive-N0.5-Flash 做网页原型,别为了少等一会儿就关掉思考。Latent Space 在11月10日发布的同题评测中,使用 Ultrafast 模式测试 Naive,发现它开启思考时能生成可用的树木演示,关闭后却没能交出可用应用。对准备试用的人,这比单看输出速度更有参考价值。
能生成页面,还得检查页面跑得怎样
Ultrafast 是服务模式,与思考开关不是同一个维度,结果不能直接套到 Standard 模式。测试对手是 DeepSeek V4.1 Flash 1017 和 GLM 5.3 Flash,任务包括太阳系、树木生成和浏览器光线追踪。评测者认为,开启思考的 Naive 做出了细节最丰富的太阳系;树木任务中,它与高思考档 DeepSeek 都表现不错。这里说的是特定提示词下的产物,不是通用编程排名。
光线追踪更能提醒人别只验收截图。三款模型开启思考后都做出了能运行的应用,但评测者把效率优势给了 DeepSeek,认为 Naive 的 JavaScript 虽然正确,运行效率却较低。生成得快,和生成的程序跑得快,是两回事。
价格先当预算参考,不当结算承诺
这次新消息是评测,不是模型刚刚发布。NaiveAI 的官方研究页标注日期为9月27日,写明权重与推理代码采用 MIT 许可,但 API 使用将提供访问的表述。每百万 token 标价为输入 0.10 美元、输出 0.40 美元、缓存读取 0.01 美元;Latent Space 称其为目标价格。试用前须核实访问权限、支持模式和实际收费,不能把开放权重当成托管服务已可用的证明。
低单价也不等于低单次成本。在独立于网页任务的计时实验中,Naive 开启思考后,困难题平均输出约 108,500 tokens,约为 GLM 高思考档的 9 倍、DeepSeek 高思考档的 11 倍。这说明为什么要看输出量,但不能把目标单价换算成实际账单。
我们的建议是把它放进网页原型候选,而不是直接替换现有编程模型。保留同一任务,分别检查思考开关下的可运行性、交互缺陷、运行效率和总输出量。评测中的计时实验没有给答案准确性打分,不能拿速度结果替代验收。
下一步最值得记录的是:交付一个通过验收的页面,到底花了多久、多少 token,以及几次修补。省下生成等待,却增加调试时间,不一定划算。