
如果你正在为高频调用任务挑选低价模型接口,OpenAI 财务长 Sarah Friar 的最新表态很可能会让你动心。2026年11月10日,Friar 在接受 Deirdre Bosa 专访时表示,旗下轻量模型 Luna 的调用成本只有中国开源竞争对手的大约五分之一到六分之一,并称中国模型更便宜是“2026年必须破除的迷思之一”。她同时提到,OpenAI 在 Luna 上线两周后将价格下调约 80%,此后模型用量增至原来的 10 倍。
把这句话直接当作选型结论前,最好先翻一遍两边的公开价目表。对比 OpenAI 官方定价页、DeepSeek 官方文档 以及多平台比价库 Nadir 的 11月更新数据 后可以看到:Luna 确实比部分经第三方云端托管的中国模型便宜好几倍,但面对直连官方接口的轻量档位和缓存命中场景,价差并没有五六倍那么大,甚至在少数选项上还更贵。
把标价摆在一起:五倍价差成立在哪,不成立在哪
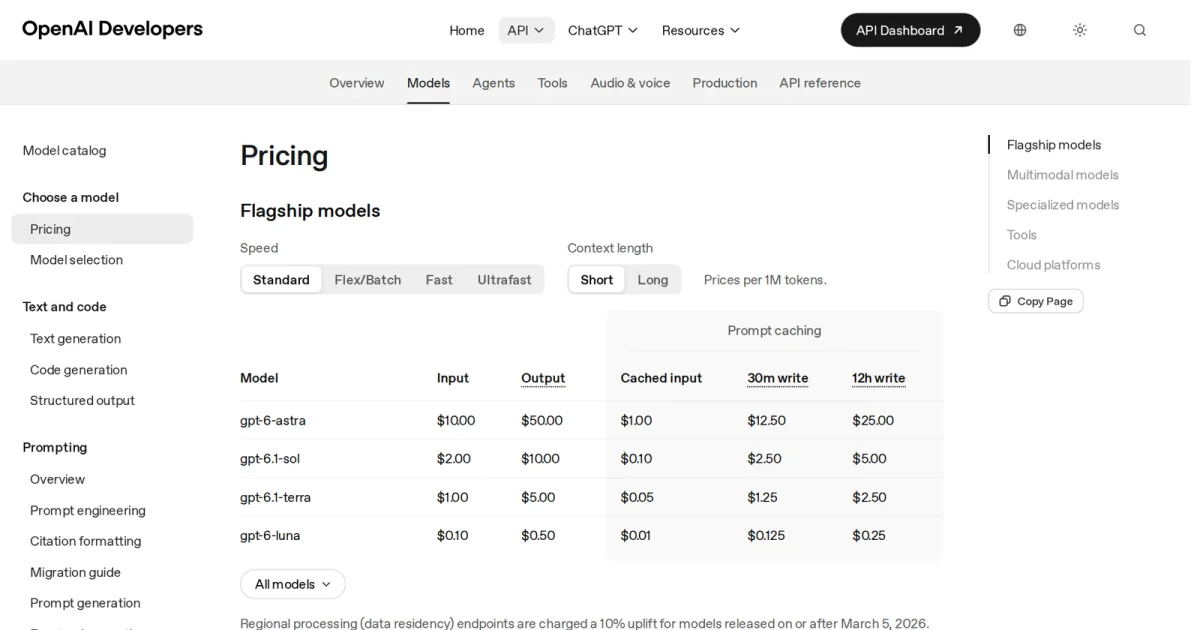
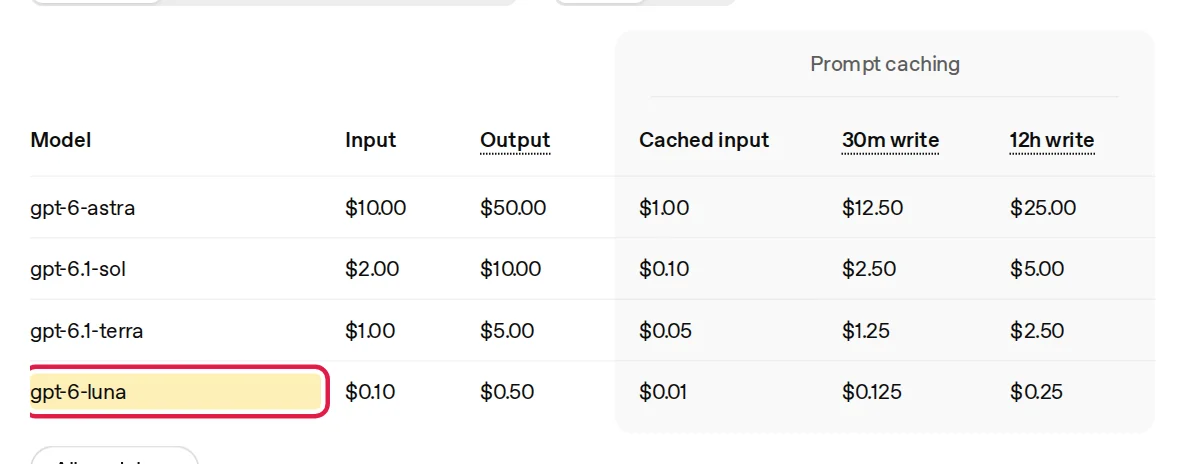
在 OpenAI 的标准费率表里,gpt-6-luna 的定价是每百万输入词元 0.10 美元、缓存输入 0.01 美元、输出 0.50 美元;如果走批处理 Batch 或弹性 Flex 通道,直接打对折,降到输入 0.05 美元、缓存输入 0.005 美元、输出 0.25 美元。按 Nadir 记录的发布节点,GPT-6 Luna 于 2026年9月22日上线,取代了此前输入 0.20 美元、输出 1.20 美元的 GPT-5.6 Luna。
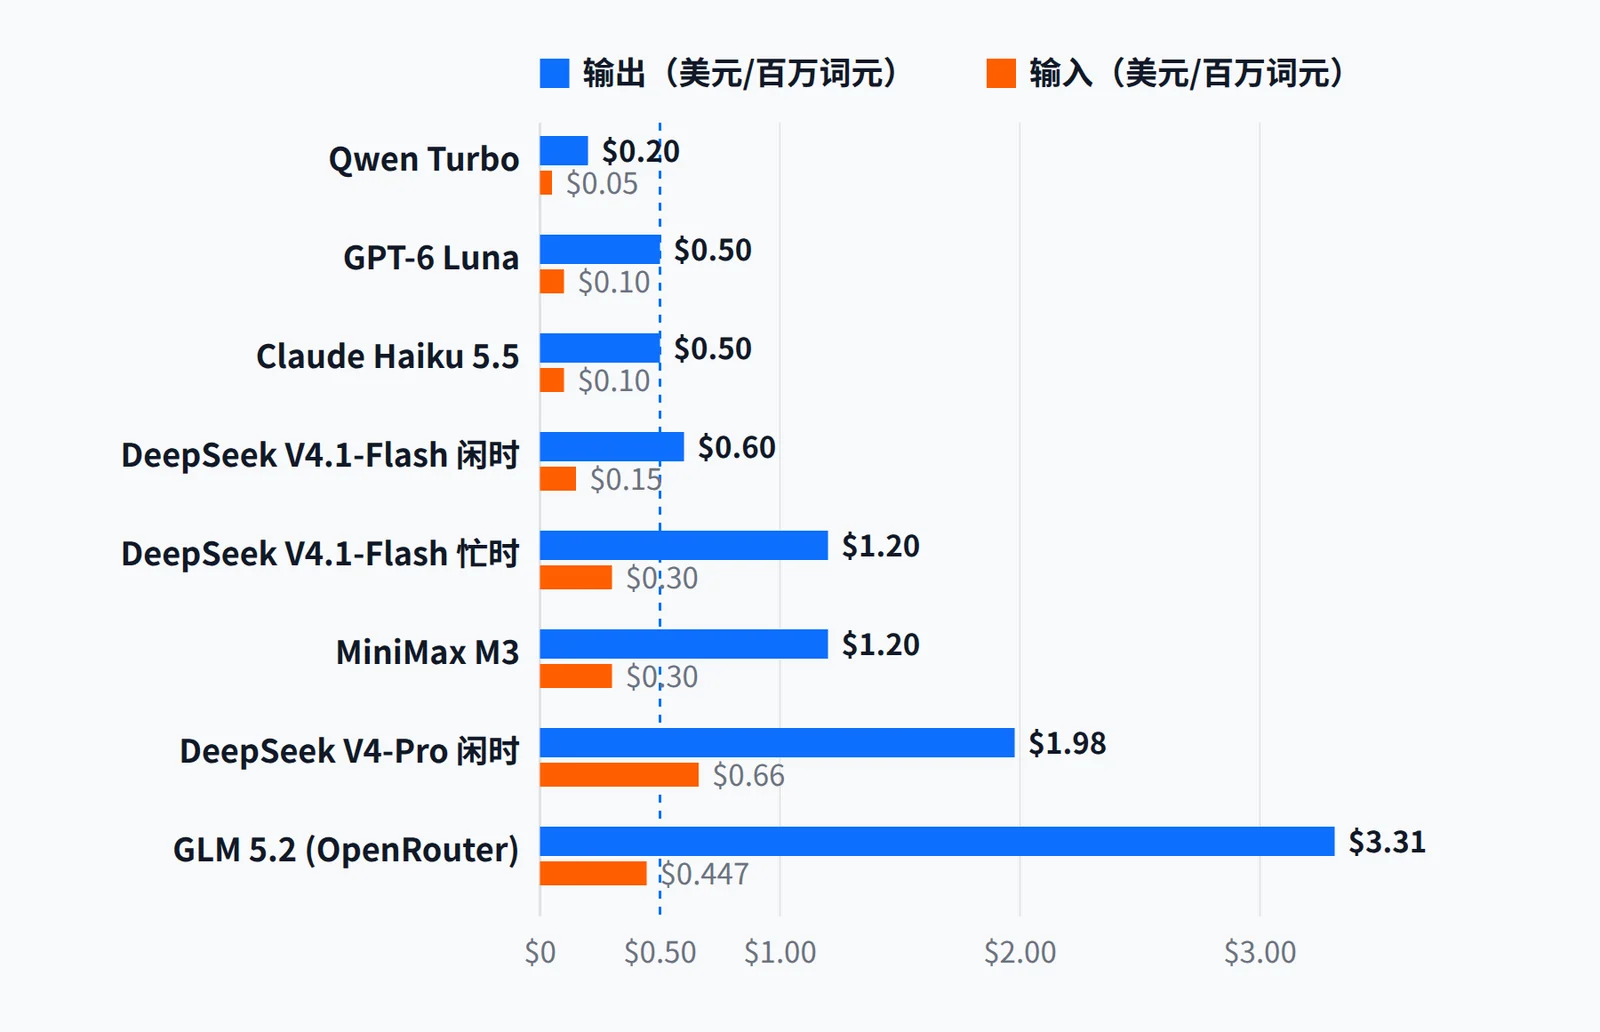
那位财务长说的“五分之一到六分之一”,如果拿去对照第三方云托管的开源模型,数字其实对得上。OpenAI 在 2026年9月9日 Quartz 的报道 中点名对比的对象就是智谱旗下的 GLM 5.3 云端部署;按 Nadir 统计的 OpenRouter 各托管方加权均价,GLM 5.2 的输入与输出价格分别达到每百万词元 0.447 美元和 3.31 美元。拿 0.10 美元、0.50 美元去比 0.447 美元、3.31 美元,或者去比 Kimi K2.6 的 0.95 美元、4.00 美元以及 DeepSeek V4-Pro 闲时的 0.66 美元、1.98 美元,Luna 的确把成本压到了五分之一甚至更低。
可一旦换回中国厂商自家的入门主力,结果立刻变样。DeepSeek 官方现在的轻量主力是 deepseek-flash(DeepSeek-V4.1-Flash),在非高峰时段每百万输入词元 0.15 美元、输出 0.60 美元,只比 Luna 的 0.10 美元和 0.50 美元高出一截,远远不到五倍;在需要反复读取长系统提示词的场景里,DeepSeek 的缓存命中价只有每百万词元 0.003 美元,反过来比 Luna 的 0.01 美元更便宜。如果看阿里在 Nadir 榜单里的 Qwen Turbo,输入 0.05 美元、输出 0.20 美元的列表价甚至只有 Luna 的一半左右。
真正拉高账单的,是价目表下面的三道门槛
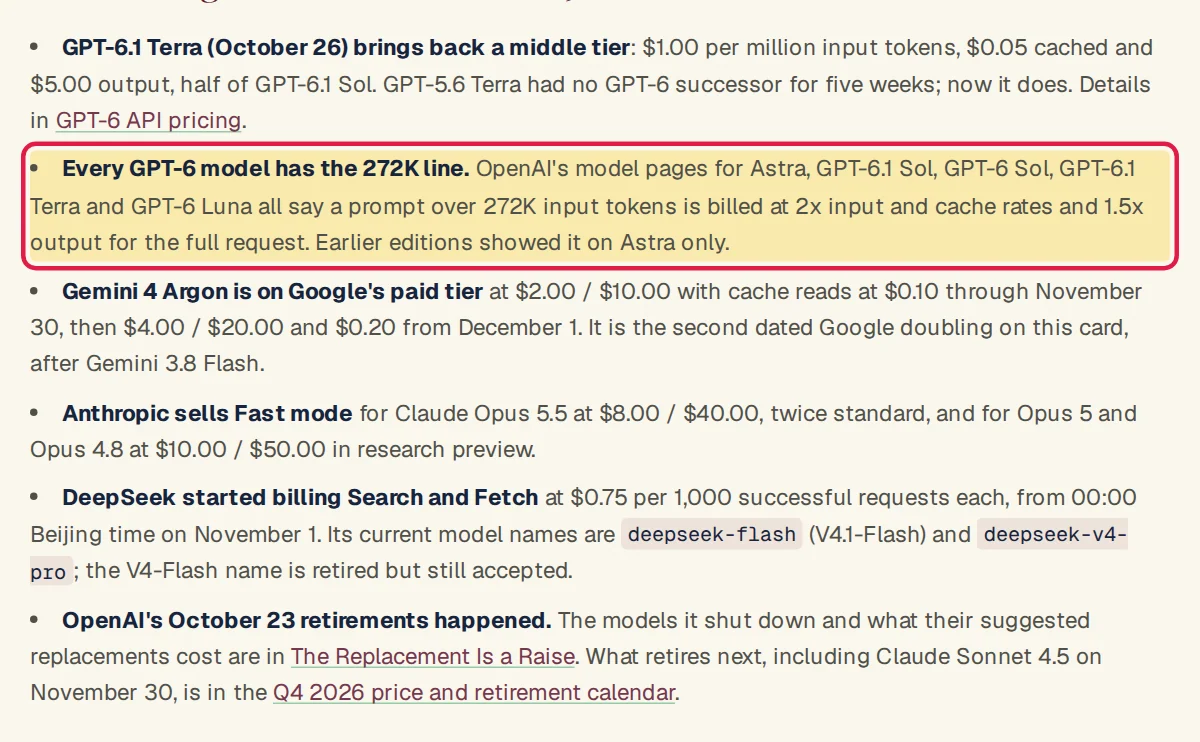
如果只比第一眼看到的数字,开发团队在真实生产环境里多半会算漏三笔账。第一道门槛藏在提示词长度里。Nadir 核对各模型页面后指出,包括 GPT-6 Luna 在内的所有 GPT-6 系列模型都设有一条 272K 输入词元的分界线:单次请求的输入一旦超过 272K 词元,整笔请求的输入和缓存读取费率全部按 2 倍计价,输出按 1.5 倍计价,不是只对超出的部分加价。
同档位的竞争对手也有类似阶梯。Anthropic 在 2026年10月7日推出的 Claude Haiku 5.5 同样给出每百万输入 0.10 美元、输出 0.50 美元、缓存读取 0.01 美元的起点价,但它把分界线压到了更低的 100K 词元,超过后整笔请求(包含缓存读写)直接按 5 倍收费,变成输入 0.50 美元、输出 2.50 美元。相比之下,DeepSeek V4.1-Flash 没有按上下文长度分段加价的条款,却在 2026年8月16日结束了全天统一定价,改成按小时段浮动的忙闲时计费。
按照 DeepSeek 官方文档给出的规则,每周一至周五(不含中国法定节假日)的北京时间09:00至12:00以及14:00至18:00(即协调世界时01:00至04:00和06:00至10:00)属于高峰时段,其余时段以及周末、中国法定节假日全天均按闲时费率计费;进入高峰时段后,deepseek-flash 的输入、缓存命中和输出费率都会翻倍,分别涨到每百万词元 0.30 美元、0.006 美元和 1.20 美元,而且官方网页检索和抓取服务也已从 2026年11月1日00:00起单独计费,每 1,000 次成功请求各收 0.75 美元。也就是说,如果你的业务流量集中在亚洲工作日的白天,又不做缓存命中,DeepSeek 轻量版的账单就会迅速被拉到 Luna 标准价的 2 倍以上。
接入前先算清的四件事
把这些条款拆开后,选型其实不需要听谁一家之言,直接按自己业务的请求形态对号入座就能得出结论:
- 单次提示词长度是否常过 100K 或 272K:文档问答和代码库整包分析最容易踩中阶梯线,GPT-6 Luna 在 272K 以内维持低价,过线后整单翻倍;Haiku 5.5 在 100K 就会跳涨 5 倍。
- 请求高峰落在哪个时区:面向欧美用户的夜间批量任务或周末作业走 DeepSeek 闲时通道最划算;亚洲白天同步请求则要按忙时 0.30 美元与 1.20 美元核算,或者把能延后的任务切去 OpenAI 的半价 Batch 接口。
- 前缀缓存命中率有多高:固定模板占比高的智能体,DeepSeek 闲时每百万词元 0.003 美元的缓存命中价比 Luna 的 0.01 美元低得多;但写入和未命中场景仍是 Luna 或 Qwen Turbo 占优。
- 是否依赖内置联网或推理输出:DeepSeek 的 Search 与 Fetch 按每 1,000 次成功调用 0.75 美元另算,OpenAI 的网页搜索工具则是每 1,000 次调用 10.00 美元外加检索词元计费;此外,Luna 保留了可将
reasoning_effort设为none的设置,而 DeepSeek 默认开启思考模式,简单任务若不手动切到非思考模式,额外的推理输出同样会推高账单。
把接口切向低价模型之前,拿线上最近一周的真实日志按输入长度、缓存命中率、请求时段和工具调用次数重新跑一遍试算,往往比只看榜单里的入门标价更能守住预算。