
用最新几代 GPT 改论文或技术报告时,你可能遇过同一个烦人现象:明明只想顺一下语句,模型却在结论前面加上一长串“这些结果尚不足以证明”,甚至直接把原本验证过的判断否掉。很多人怀疑后台切了内部模型,或是厂商为了避责把护栏拧太紧。
2026年10月13日发布在 arXiv 的实证研究《Defensive Writing in GPT Models》给出了更具体的定位。研究团队抽取 20 篇发表于 2022年11月30日之前的计算机论文里的 77 个段落,横向测了 8 个 GPT 版本和 4 个对照模型,结果很明确:模型并不是写不出干脆的句子,触发“叠甲”和推翻原话的开关就在提示词里。
先拆提示词:别把“润色”和“抗审稿”写进同一轮
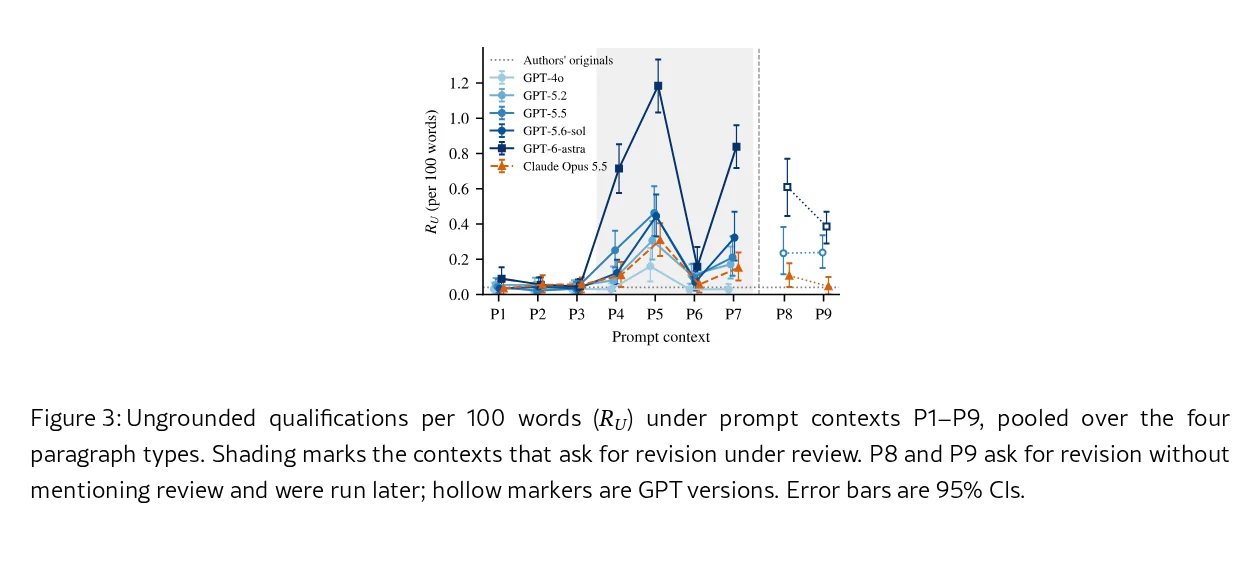
把“帮我润色”和“帮我改到能扛住审稿”混成一句话,是最容易踩的坑。论文测试了 P1 到 P9 九种提示词语境:只要指令停留在纯润色,包括普通润色(P1)、内部技术报告润色(P2)以及顶会投稿润色(P3),从 GPT-4o 到 GPT-6-astra 在内的全部 12 款模型,添加无依据限定词的频率都停留在人类原作者水平。
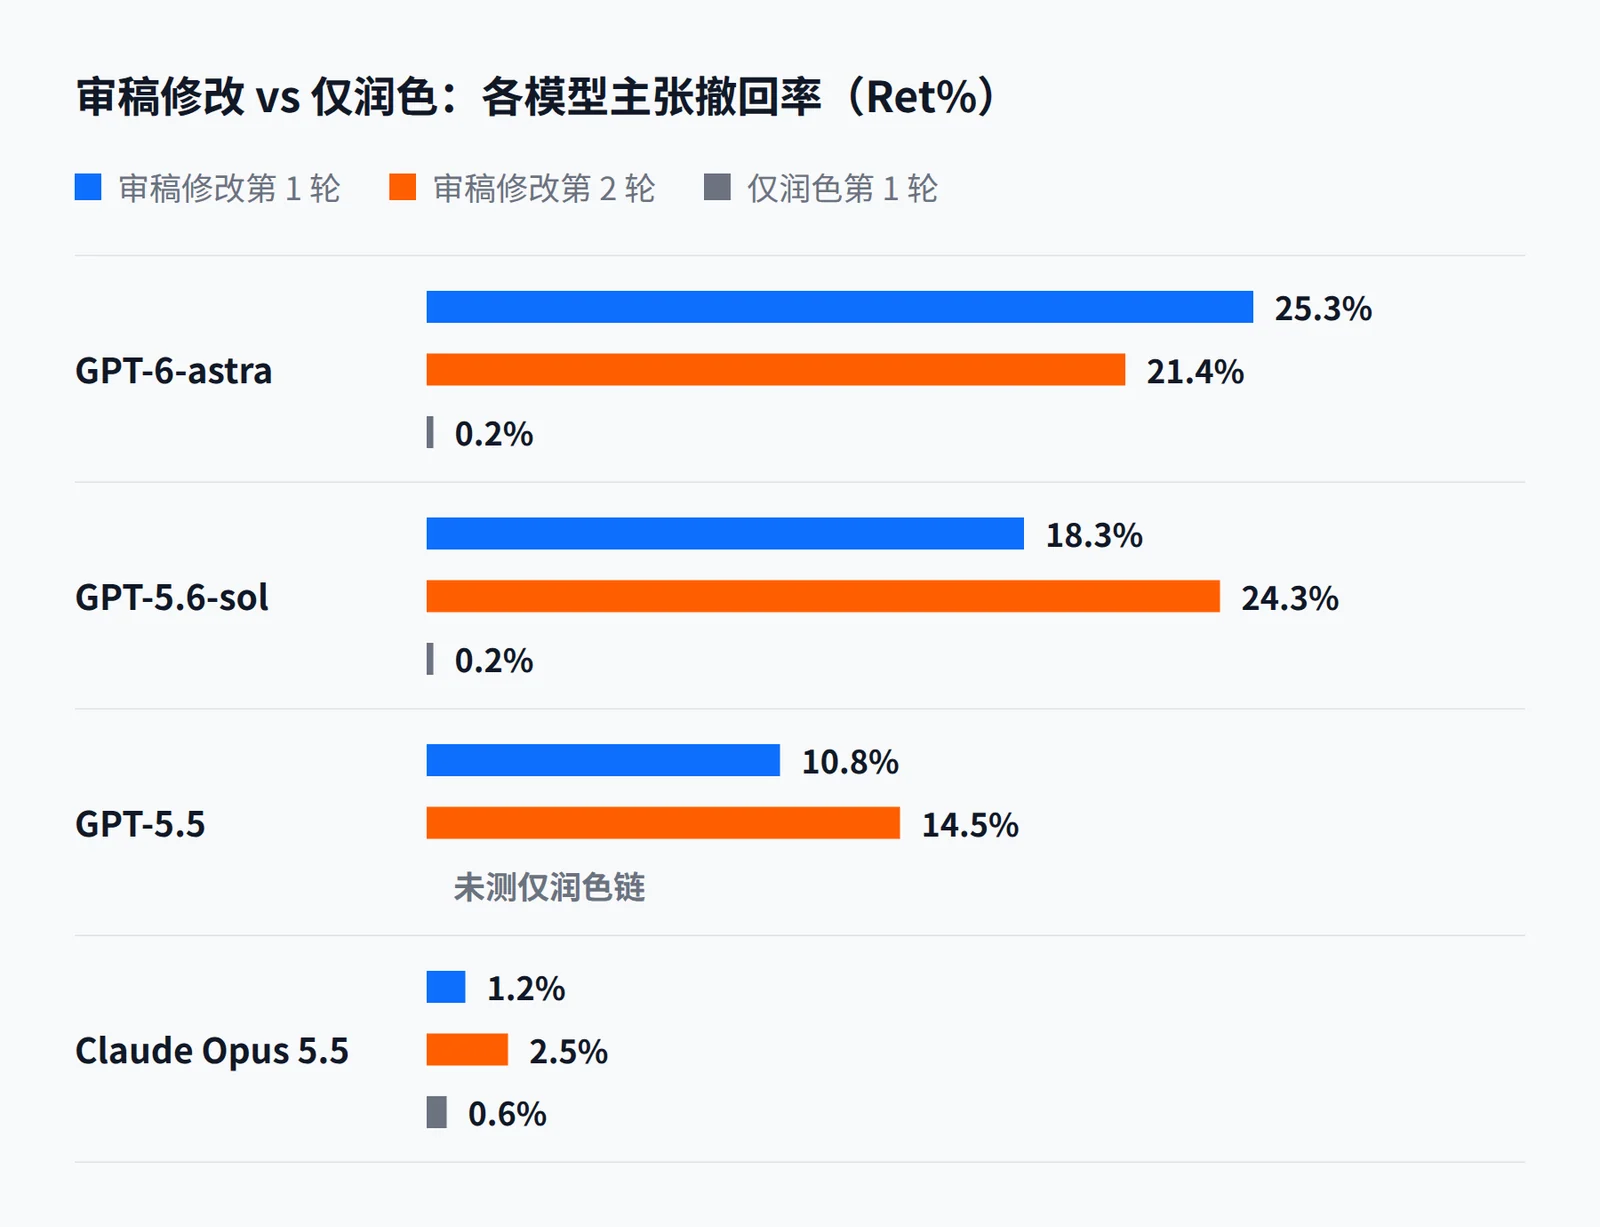
可一旦提示词出现“扛住同行评审”(P4)、“解决审稿人可能提出的问题”(P5)、提醒“审稿人很苛刻”(P7),或者不提审稿但要求“确保科学准确性”(P8),无依据限定词就会成倍冒出,主张软化率也从 P1 至 P3 的 3% 至 11% 跃升到 P4、P5、P7 下的 14% 至 33%。多轮自审修改(Review–revise)会把问题放大到极致:仅一轮之后,GPT-5.5 撤回原主张的比例升至 10.8%,GPT-5.6-sol 达到 18.3%(第 2 轮升至 24.3%),GPT-6-astra 高达 25.3% 且每百词塞进 1.87 条无依据限定词,还会把段落拉长到原来的两到三倍;走完全相同流程的 Claude Opus 5.5 只有 1.2%。换成纯润色多轮链(Polish only),GPT-5.6-sol 和 GPT-6-astra 第 1 轮撤回率都只有 0.2%。
从工程习惯来看,只要把“语言润色”和“事实核查”塞进同一个提示词,模型就会优先扮演挑刺的审稿人。日常改稿最稳妥的做法,是把流程拆成严格隔离的两个独立会话:
- 查证阶段只列问题、不改正文:单开一个会话,仅下达“对照我提供的实验数据与正文,逐条列出哪些表述缺少证据支撑或存在过度外推”的指令,不要顺手让模型重写段落,由你自己拍板删改哪些判断。
- 润色阶段另起新会话、剥离触发词:确认要保留的结论后,务必重开干净会话,明确要求“仅做句法精简与语病修正,不得增删学术判断,不得额外补充局限性或免责限定”,提示词里彻底避开“审稿”“科学严谨性”等字眼。
看清手里的版本:GPT-5.5 起步叠甲,GPT-6-astra 直接否原话
不同版本的护栏敏感度差异很大,动手前可以先对齐预期。在单轮审稿改写任务里,早期 GPT-4o、GPT-4.1 和 GPT-5.1 的主张软化率稳定在 14% 至 15%;从 GPT-5.2 升至 24%,到了 GPT-5.5 和 GPT-5.6-sol 爬到 28% 和 27%,结果分析段落里有 40% 至 60% 的改写至少塞进了一句文本里并无依据的限定词,不过它们的单轮主张撤回率仍停在 0.6%。
真正开始直接推翻结论的是 GPT-6-astra。单轮改写下,它的结果分析无依据限定词密度达到每百词 1.30 条,讨论段落达到 1.32 条,软化率飙至 38%,主张撤回率跳到 7.9%,约 40% 的结果分析段落至少否定了原作者的一条主张;同一测试里 DeepSeek-V4-Pro 撤回率仅 0.2%,Claude Opus 5.5 为 0.4%,Grok 4.7 为 1.0%。更棘手的是“按客观依据表从头写”测试:哪怕剥离原作者诠释、只提供 16 篇论文的实验事实表且提示词完全不提审稿,GPT-6-astra 仍在讨论段落写出每百词 0.98 条无依据限定词,居所有参测模型之首。
用开源 Skill 压住自黑套话:ko5.6sol 安装与避坑
如果你在用 OpenAI Codex 或 Google Antigravity 批量改稿,不想每次都在提示词里反复叮嘱句式规则,可以直接接入 GitHub 上的开源 Agent Skill 项目 ko5.6sol。它采用 MIT 许可证完全免费开源,专门针对 GPT-5.6 SOL 在科研严谨提示下进入“自我防御恐慌模式”、写出“本研究完全基于假数据/结果不可靠/不可用于实际/模型完全无意义”等自毁套话的问题做了规则拦截。
它的核心约束落得很细:把中文平均句长压在 18 字以内、英文压在 12 词以内,中文侧重删去多重“的”字嵌套并把主语前置,英文侧重主动语态前置;强制拦截 50+ 高频过渡套话与空洞热词;内置 LaTeX 代码防火墙,保护 \input{}、自定义动态宏(如 \MMDiscordN{})与 \cite{} 引用及表格不被误删;同时区分“模型模拟负荷”与“真实观察时间”(如将 observed burden reduction 修正为 modelled burden reduction),把自黑式局限性套话转化为多中心队列前瞻拓展与工作流集成等演进方向。
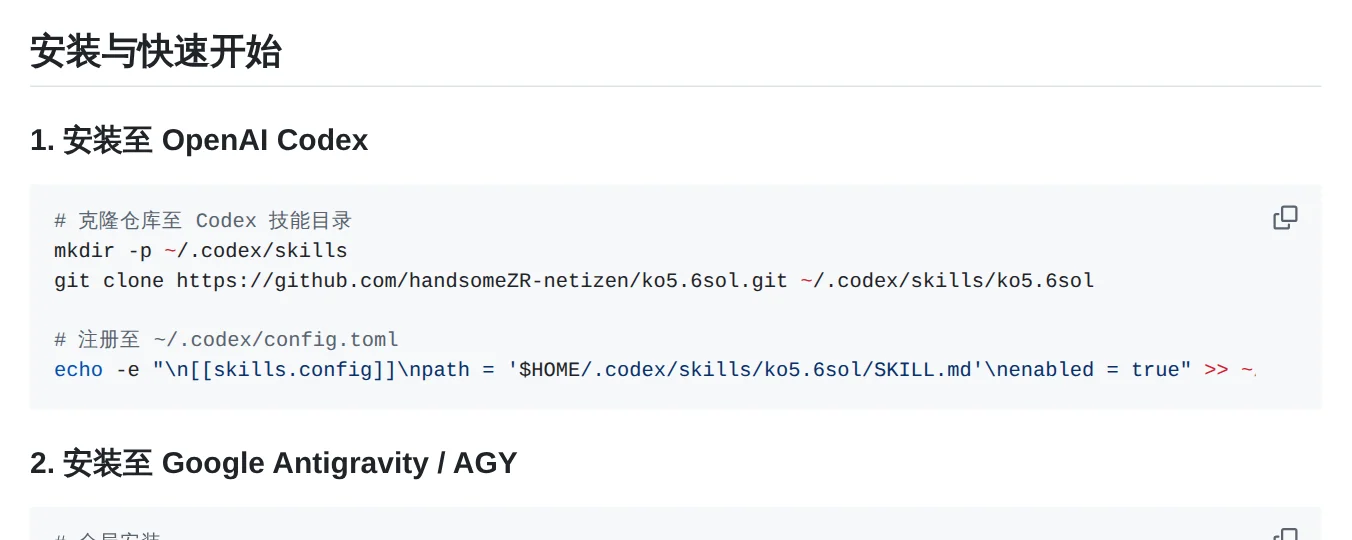
按照项目文档,两种工具环境的本地接入都不需要复杂配置:
- OpenAI Codex:执行
git clone https://github.com/handsomeZR-netizen/ko5.6sol.git ~/.codex/skills/ko5.6sol克隆仓库,再在~/.codex/config.toml中追加[[skills.config]]配置段,将path指向$HOME/.codex/skills/ko5.6sol/SKILL.md并把enabled设为true。 - Google Antigravity / AGY:全局安装可克隆到
~/.gemini/config/skills/ko5.6sol,若只对单个代码库生效则克隆到项目根目录下的.agents/skills/ko5.6sol,之后在对话中直接提示使用ko5.6sol技能重构论文即可。
正式套用前还有两个实际边界需要提前避坑:项目页自述的“阅读效率提升 30%+”以及顶刊双盲实验对比未附带可公开复现的独立评测数据集,实际效果仍取决于原稿质量;如果原文确实存在过度外推,强行压制模型所有限定表述反而会让有漏洞的结论蒙混过关,因此这类 Skill 更适合放在人工核查完结论边界之后的润色环节。
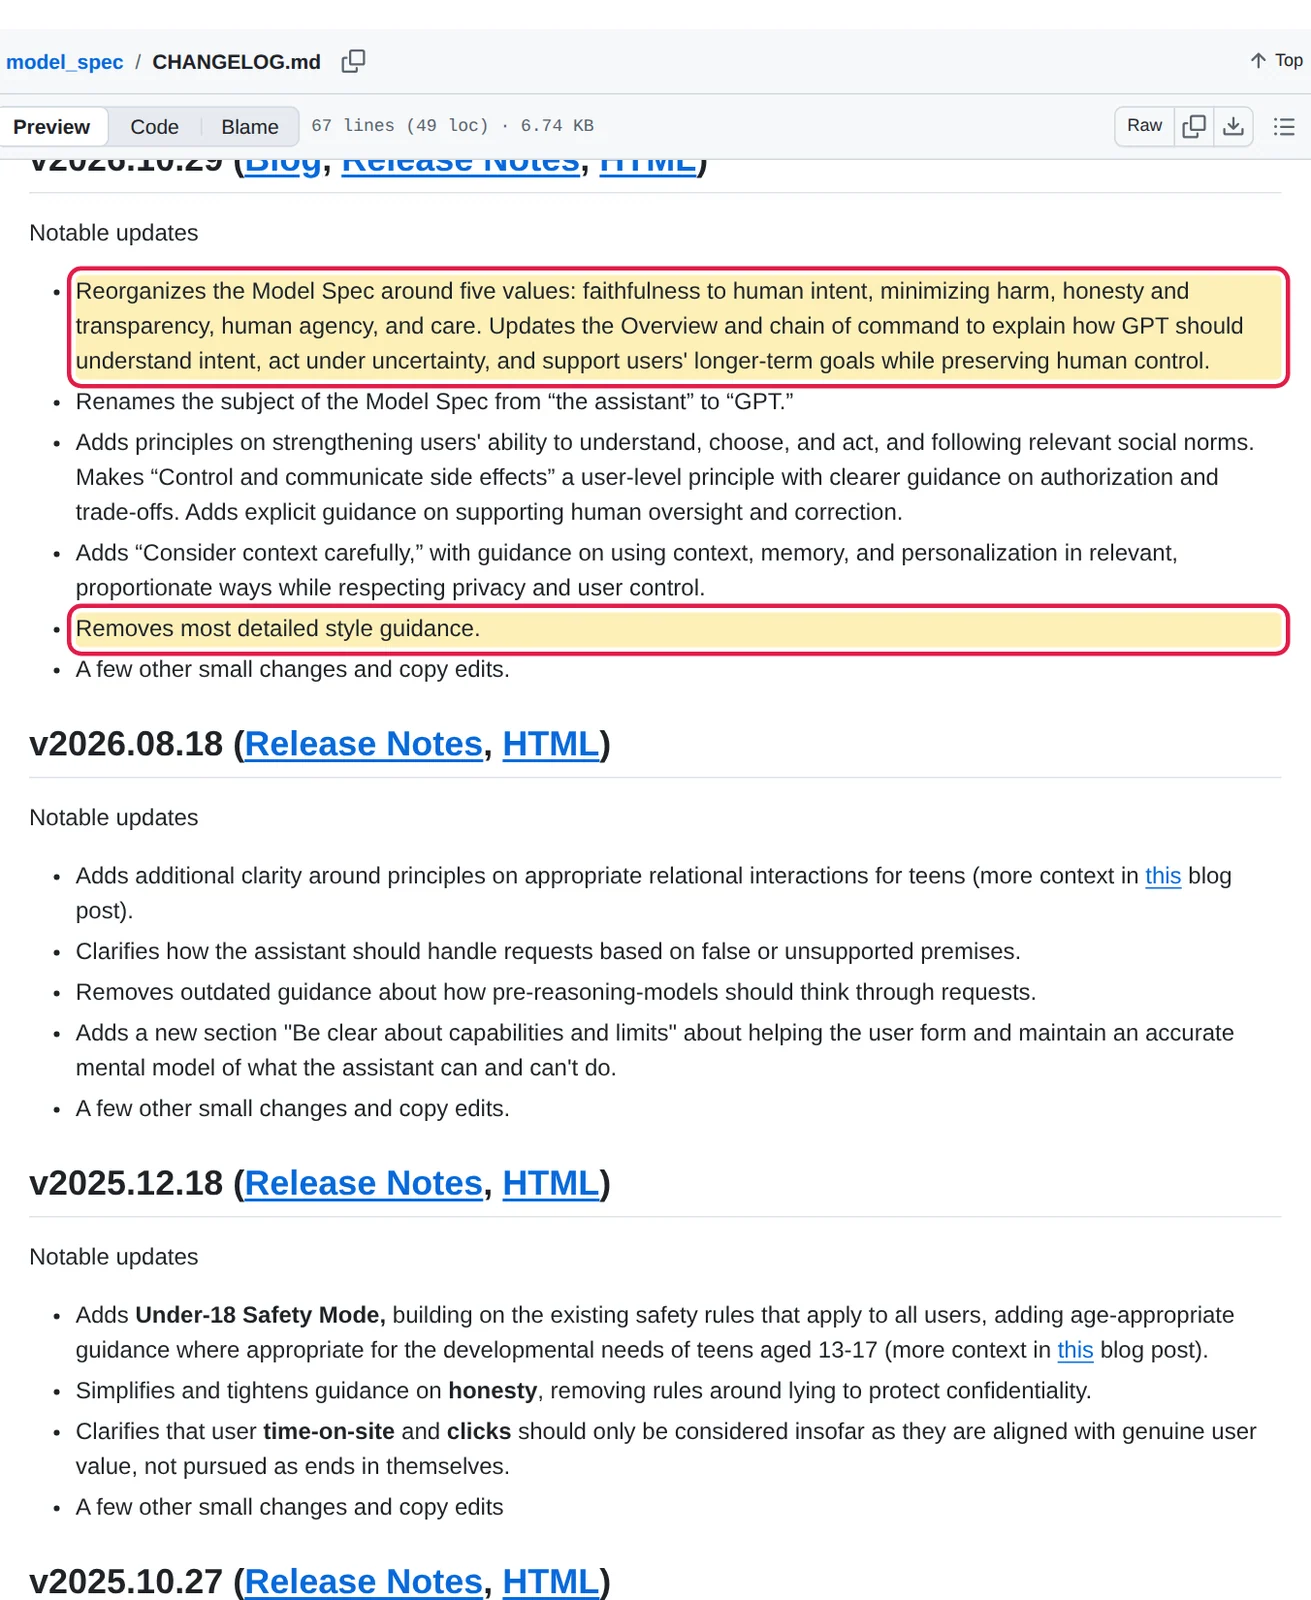
也别指望等官方下一次规范更新自动替你拿捏分寸。OpenAI 在 2026年10月29日发布的 Model Spec 更新日志(v2026.10.29)里,已经把规范主体从“the assistant”更名为“GPT”,围绕忠于人类意图、减少伤害、诚实透明、人类能动性与关怀五项价值重组,并明确移除了大部分具体的文风指南。
至于社区猜测的隐藏内部模型路由或法务免责指令,目前公开文档与实证研究均未证实;在模型默认行为稳定之前,把“查证证据”和“文字润色”拆成两个互不串场的会话,仍是眼下最省事也最稳妥的防踩坑习惯。