
2026年11月10日,Google 全面开放了 Gemini 4 Carbon,两天后又发布 Gemini 4 Hydrogen。真要把它们接进科研写作、实验核查或代码工作流,先得把最常踩的几个坑核对清楚:免费账号究竟能开哪一档、11月30日优惠期结束前后的 API 账单差多少,以及写作榜和数学榜各自测的是什么。
下手接 API 或开订阅之前,先把 Google 官方访问条件、定价表、Towards AI ToneBench 与 BenchLM 的实测边界摆在一起核对。
先查账号与入口:谁能直接用,订阅价表里没写什么
三款模型目前的可用范围差得很大,不能只看参数表选型:
- Gemini 4 Hydrogen:覆盖面最广。Google AI Studio、Gemini API、Android Studio、Gemini for business 与 Google Search 全部可用;Gemini app 面向所有用户开放,免费账号在系统自动选模判断合适时也能调用。Google Antigravity 与 Gemini in Google Sheets 则要求付费 Google AI Pro、Ultra 或符合条件的企业订阅。
- Gemini 4 Carbon:开发者可通过 AI Studio 与 Android Studio 的 Gemini API 付费层接入,企业可用 Gemini for business、Google Antigravity 或 CodeMender;日常端(Gemini app 与 Search AI Mode)及 Antigravity 试用仅面向 Google AI Ultra 订阅用户。科研人员另有免费通道:Google 四周前启动的 10,000 名科学家 6 个月免费试用 Antigravity 最高用量档位计划,已在 11月10日将访问范围扩大至 Carbon,按周滚动审核资格与名额。
- GPT-6 Astra:BenchLM 标注其处于 Limited Availability(受限开放)状态,列表入口包括 OpenAI Responses API、Chat Completions API、ChatGPT Plus、Pro、Business、Enterprise,以及 Microsoft Azure 与 AWS Bedrock。
需要注意一个费用缺口:Google 官方公告与 BenchLM 都只披露了按 token 计费的 API 标准单价,没有列出 Google AI Pro、Ultra 或 ChatGPT 各档个人订阅月费。如果你打算走网页端会员而不是 API,下单前得去对应产品账单页单独核对月费与配额。
算清 API 账单:三档负载开销与 Hydrogen 的四级思考
API 标准费率方面,Hydrogen 在整个 1M 上下文窗口统一按每 1M 输入 tokens $1.50、输出 $7.50 计费;Carbon 在 2026年11月30日前按引入期优惠每 1M 输入 $2、输出 $10 计费(缓存输入 $0.1),优惠期满后翻倍至 $4 与 $20;GPT-6 Astra 则为每 1M 输入 $10、输出 $50(缓存输入 $1)。
按 BenchLM 给出的三套固定测试负载对比 Carbon(当前优惠价)与 Astra,价差并不全都停在五倍:
- 单轮对话(1K 新输入加 500 输出):Carbon 约 $0.007,Astra 约 $0.035,正好差五倍。
- 代码库审查(50K 新输入加 3K 输出):Carbon 约 $0.13,Astra 约 $0.65,同样是五倍。
- 重缓存代理循环(200K 缓存输入加 20K 新输入加 10K 输出):Carbon 约 $0.16,Astra 约 $0.9。这一项不再是五倍,因为两者的缓存输入单价分别为 $0.1 与 $1,差了十倍,最终整轮开销差出五倍以上。
11月12日发布的 Hydrogen 正好用来分担高频任务。它提供 low、medium、high(默认)与 xhigh 四档思考深度,默认 high 档在 Artificial Analysis Intelligence Index 拿到 51 分(高于 Argon 的 50 分),xhigh 档达 54 分;对比 Gemini 3.8 Flash,任务完成速度提至 2.5 倍,Terminal-Bench 4.1 从 18.2% 升至 57%,内部诚实度测试通过率达 94%。把它和 Carbon 一起放进 Google Antigravity 的 Orchestrator 自动切换,在 Terminal-Bench 4.0 上既能维持接近单用 Carbon 的成功率,还能平均少用 24% 额度并缩短 19% 耗时。
写作与推理实测边界:ToneBench 测的不是论文
不少人在比较长文“去 AI 味”时会引用 ToneBench,但使用前必须先看清它的测试范围:它测的是闭卷条件下,严格按风格指南模仿创作者 Louis-François Bouchard 口吻写 10 份 YouTube 视频口播脚本(每份 5 稿)的表现。Gemini 4 Carbon(高思考模式)得分页也明确提醒,这项基准只测长篇脚本写作,结论不能外推到所有文本类型。
限定在这个视频脚本测试里,87 个参评模型中 Carbon(高思考模式)排第 27 位(151 个配置中排第 54 位),Writing Score 为 80.1 分。在检验固定套话和破折号残留的 Slop Score 单项上(越高越少套话),Carbon 拿到 83.6 分,只比配置中位数 81.3 分高 2.3 分,排第 51 位;拿走全榜 Slop Score 第一名的是 OpenAI 的 GPT-6 Sol(medium 模式,89.0 分)。同榜写作总分第一名则是 Anthropic 的 Claude Opus 5.5(xhigh 模式,85.8 分,单篇脚本 $1.003)。
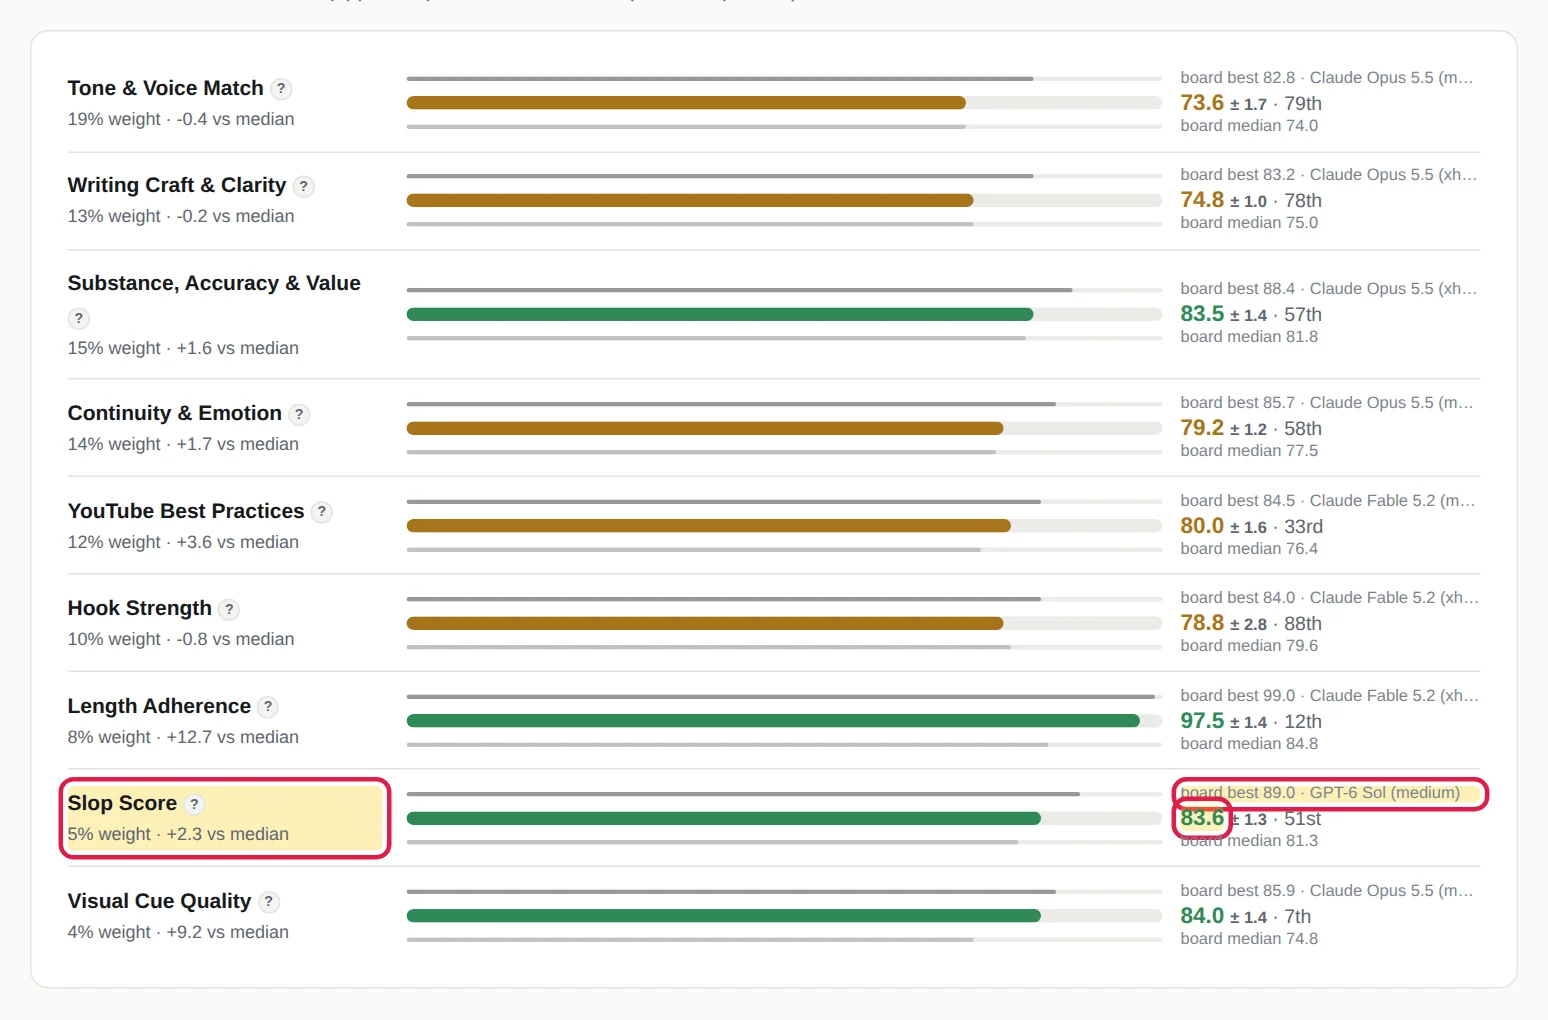
同一测试下,Carbon 高思考模式平均每篇花费 $0.586,含重试平均等待 8.7 分钟(全榜中位数为 1.5 分钟);调到中思考模式降为 $0.218 与 3.1 分钟(79.2 分),低思考模式为 $0.061 与 0.8 分钟(77.2 分)。而目前 ToneBench 尚未上线 Hydrogen 或 GPT-6 Astra 的对应得分页,所以 Hydrogen 在科研论文或长文草稿上能不能既少等又少套话,目前只是待你用自己样稿验证的假设,不能从榜单直接下定论。
切到硬核数理与代码仓任务,BenchLM(11月13日更新)给出的单项胜负很具体:GPT-6 Astra 在 FrontierMath v2 的 Tiers 1-3 拿到 93.684%(Carbon 为 90.526%)、Tier 4 拿到 97.600%(Carbon 为 95.122%),软件工程 FrontierSWE v2 拿到 65.5%(Carbon 为 61.2%),并且记录在案的上下文窗口为 1.05M(Carbon 为 1M)。
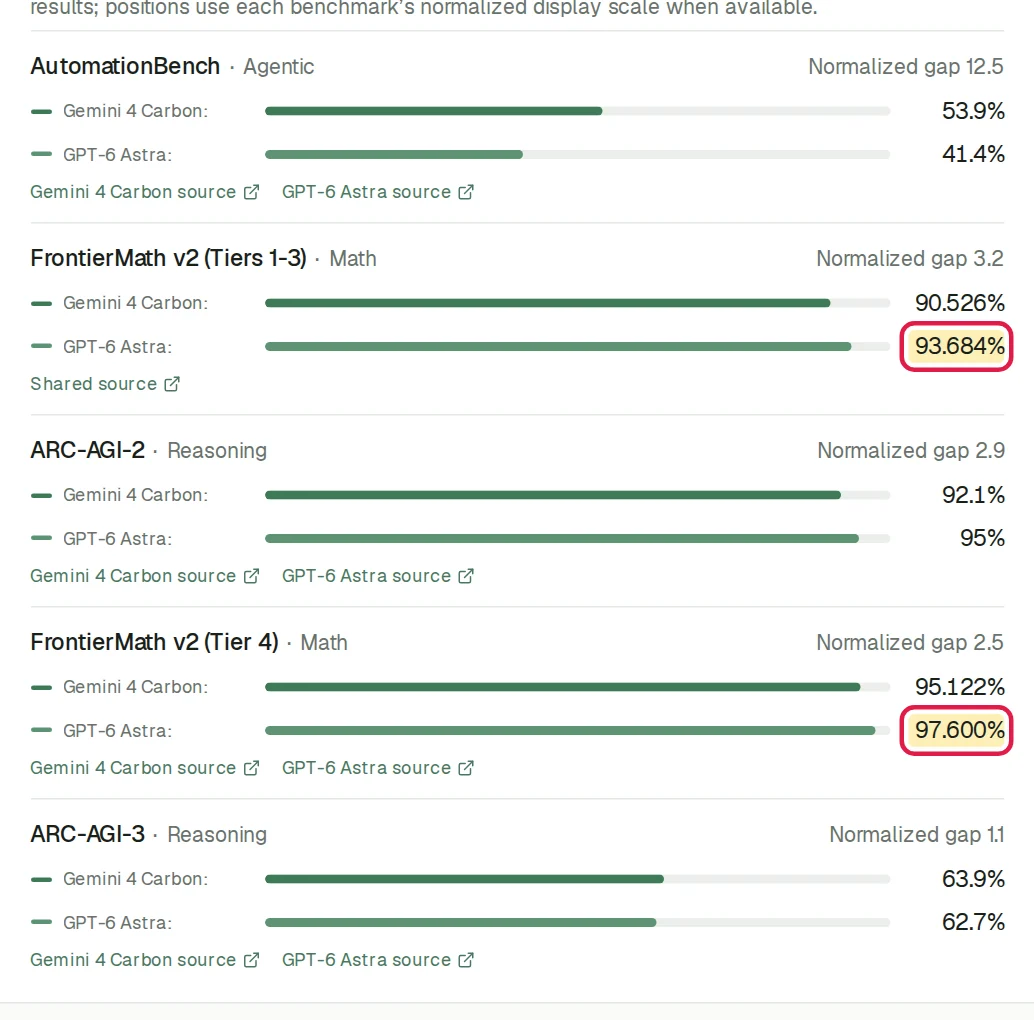
Carbon 则在找错修补的 Bug Hunt Bench(57.3 对比 45.0)和长图谱遍历 GraphWalks BFS(96.2% 对比 71.8%)领先。输入规格上,BenchLM 文档列明 Carbon 原生支持文本、图像、视频、音频与 PDF,Astra 在同页文档中列明的是文本与图像(页面未列明其余输入格式是否支持)。至于数据核查,Google 在 11月10日公告披露其内部 375 项代理诚实度评测中,Carbon 遇到缺失实验数据时拒绝补造的比例为 98%。这只代表内部测试表现,你可以把它当成辅助核查工具,但原始实验记录和论文结论依然得由人自己把关。
上手前先跑三项实测
如果你只是整理文献笔记或润色段落,优先拿免费自动选模或每 1M 输入 $1.50、输出 $7.50 的 Hydrogen 试跑两三段自己的材料,不要把 ToneBench 的 8.7 分钟脚本均值当作所有任务的通用耗时;真要上 Carbon 跑复杂多模态资料或重度代理循环,符合条件的研究者可以先申请 Antigravity 6 个月免费资格,走付费 API 的用户则留意 2026年11月30日后价格会翻倍至 $4 与 $20。
只有碰到 FrontierMath 难度推导、FrontierSWE 代码仓修补或接近 1.05M 的长上下文任务时,才值得切去受限开放、目前标准单价贵五倍且重缓存循环贵出五倍以上的 GPT-6 Astra(11月30日 Carbon 涨价后,标准价差会缩至 2.5 倍)。如果你的目标单纯是在英文长脚本里压低 AI 套话,ToneBench 上已有 Slop Score 领先实据的是 GPT-6 Sol(89.0 分),而 Claude Opus 5.5 赢在脚本总榜第一,两者定位不同。