
打算把项目里的 Claude Fable 5.1 换成开源权重或 Kimi K3.1 Pro,先别一次性全切过去。把月之暗面在 Hugging Face 模型卡里公开的跑分表逐行拆开,Kimi K3.1 Pro 并不是全面平替:它在多步终端代理和办公文档抽取上得分高于对手,但一遇到单轮严格编程和高难度科学推理,就会露出明显短板。
更现实的约束来自产品线切换窗口和外部合规变量:月之暗面已宣布 K2 系列将在2026年12月底全面退役,同时监管机构对月之暗面和 DeepSeek 发起的数据安全审查仍在进行中。技术选型时,模型能力边界、实际单价账单和供应商备份节奏必须一并核对。
跑分拆解:代理工具流占优,严格编码与推理落后
只看 Kimi K3.1 Pro 技术博客首屏列出的 Terminal-Bench 4.0(65.7%)和 OfficeQA Pro v2(64.4),很容易得出“全面追平闭源旗舰”的印象。但把模型卡上同时列出 Claude Fable 5.1 成绩的项目摊开看,两者在不同测试里的表现几乎分成两条线。
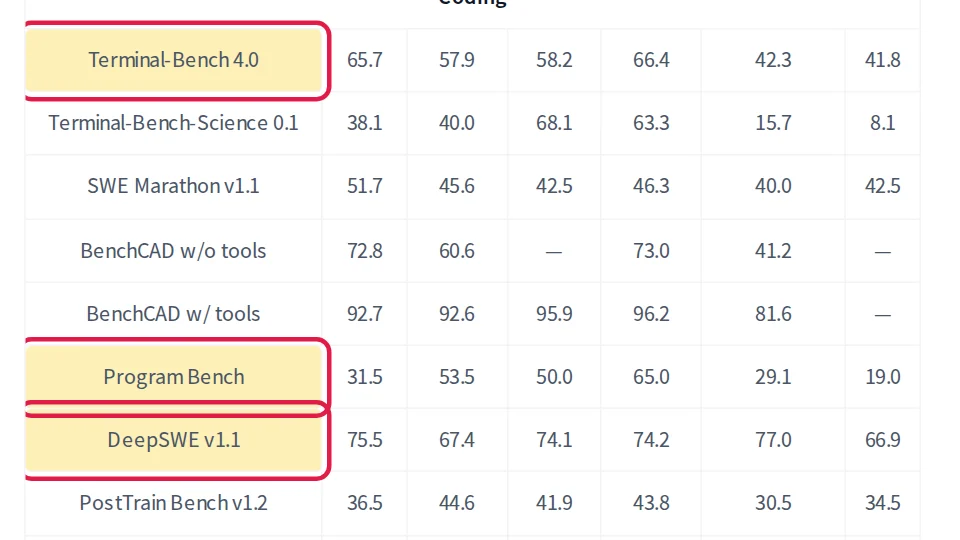
在依赖代理循环、工具调用和办公文档抽取的项目里,开启 max 推理档位的 Kimi K3.1 Pro 确实压过了 Claude Fable 5.1:Automation Bench-AA 为 73.3 对 59.4,OfficeQA Pro v2 为 64.4 对 54.5,DeepSWE v1.1 为 75.5 对 67.4,Terminal-Bench 4.0 为 65.7 对 57.9,GDPval-AA v2.1 为 1846 对 1754。
一旦离开工具反复试错的环境,切换到要求一次过关的高标准编码、复杂推理与安全攻防,排名立刻反转。在二值严格达标的 Program Bench 上,Kimi K3.1 Pro 只有 31.5,低于 Claude Fable 5.1 的 53.5;在高难推理子集 HLE-Diamond 上,K3.1 Pro 为 39.4,Claude Fable 5.1 为 55.1,无工具 HLE-Full 分别为 51.1 对 57.6;在安全基准 ExploitBench 和 ExploitGym 上,K3.1 Pro 分别为 74.7 和 20.7,低于后者的 83.0 和 30.4;在 PostTrain Bench v1.2(36.5 对 44.6)、Frontier Finance(58.6 对 60.8)以及 OSWorld V2.1(79.6 对 80.7)上也处于下风。
攻防分数的差距部分来自官方主动收敛。技术博客披露,为了降低开源后的安全风险,团队在中期训练和强化学习阶段剔除了网安相关数据,使内部 xdev-bench-hard 通过率从未经清洗检查点的 90.5% 降至 81.0%,并直言其攻防能力仍低于已公开至少三个月的闭源前沿模型。对指望它处处达到 Fable 5 级水准的团队来说,落差正集中在这些硬核推理与单轮高门槛任务上。
工程接入前必查的三项技术限制
Kimi K3.1 Pro 采用 2.8T 总参数、单 token 激活 104B 参数的混合专家架构,支持 1,048,576 上下文窗口,集成 401M 参数的 MoonViT-V2 视觉编码器,并使用原生 MXFP4 权重与 MXFP8 激活量化感知训练;线上还提供速度达标准版 2-3倍的 Highspeed 版本。需要注意的是,即便采用 MXFP4 权重,2.8T 总参数模型在 vLLM 或 SGLang 上自建部署仍面临重型多卡集群门槛,多数中小团队优先走托管 API 更现实。
在把代码或自建推理服务接上去之前,模型卡和文档里的三项工程约束容易踩坑:
- 核对评测脚手架:Kimi K3.1 Pro 在 Terminal-Bench 4.0、DeepSWE v1.1 和 Program Bench 等多项编码基准上依托 Claude Code 脚手架跑出分数,自研终端代理若工具编排较弱,实际效果会打折。
- 多轮接口必须回传思考字段:使用兼容 OpenAI 或 Anthropic 的接口进行多轮对话和工具调用时,必须把上一轮返回的完整助手消息原样放回
messages,保留reasoning_content和tool_calls,不能只保留content。 - 确认开源协议范围:权重虽托管在 Hugging Face,但采用定制的 Kimi K3.1 Pro License,商业托管或二次分发前需单独核对授权条款。
计费规则、单价对照与 K2 年底退场窗口
接口迁移还要算清账单和旧模型下线时间。从 OpenRouter 聚合报价看,月之暗面官方节点上的 Kimi K3.1 Pro 为输入每百万 tokens 2.00 美元、输出 10.00 美元、缓存读取 0.20 美元(Highspeed 节点为输入 4.00 美元、输出 20.00 美元;第三方托管商如 Relace 最低报到输入 0.2375 美元、输出 8.4114 美元)。对照 Anthropic 官方定价页,Claude Fable 5.1 为输入每百万 tokens 10 美元、输出 50 美元、缓存命中 0.25 美元(5分钟与1小时缓存写入分别为 12.50 美元和 20 美元),标价差距直接拉开。
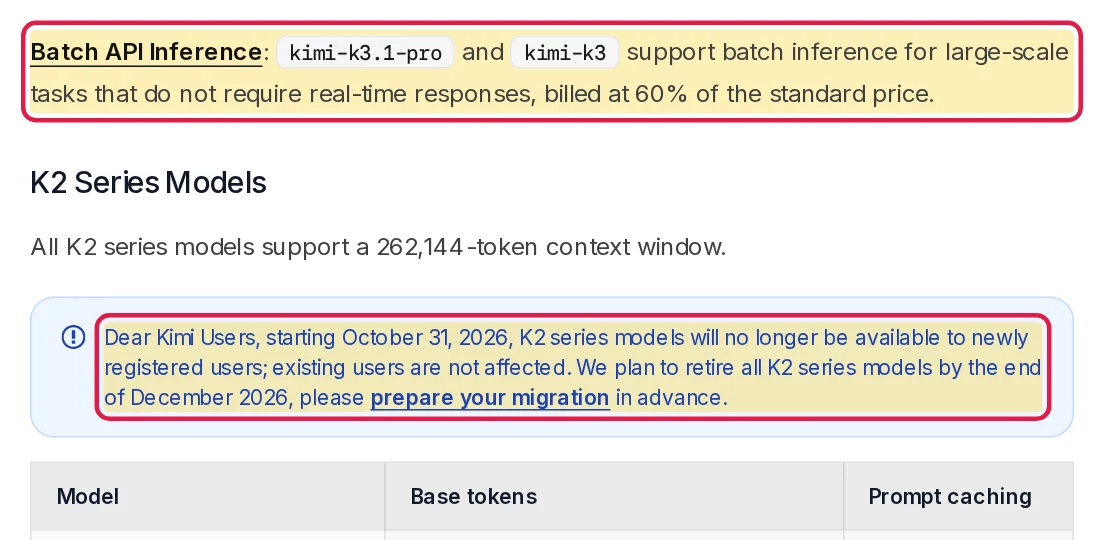
若直接接入 Kimi API 平台,官方仅提供按量计费、不设订阅套餐(与 Kimi 会员及 Kimi Code 分开结算);该文档页面正文未直接列出直连费率数字,下单前需在控制台定价页核对直连单价。规则层面,面向 K3 系列默认启用 5分钟 TTL 的上下文缓存,缓存写入按 5分钟或 1小时两档计费,命中缓存的输入仅收命中价;文件上传与内容提取接口目前暂免收费。对于不需要实时返回的离线批处理任务,kimi-k3.1-pro 和 kimi-k3 支持 Batch API,按标准价格的 60% 计费。更紧迫的节点是旧型号清退:自2026年10月31日起,K2 系列已停止向新注册用户开放,并计划在2026年12月底全面退役。
公司重组期间的务实选型
外部变数也不宜忽视。2026年11月13日至14日,AI Weekly 与《明报》引述《华尔街日报》指出,月之暗面正在注销开曼控股公司、筹备2027年初香港 IPO,同时面临市场震荡、数据安全审查与待解决的投资人纠纷,生产环境不宜把核心链路单押一家供应商。更稳妥的做法是拆开路由:长文档抽取、批量离线处理(配合 60% 折扣 Batch API)以及允许迭代调试的代理编码交给 Kimi K3.1 Pro;一次成型的严苛代码生成、高难推理与安全审计仍保留 Claude Fable 5.1 兜底,并从本周起先测试 K2 到 K3.1 Pro 的接口迁移。