
读懂模型结构
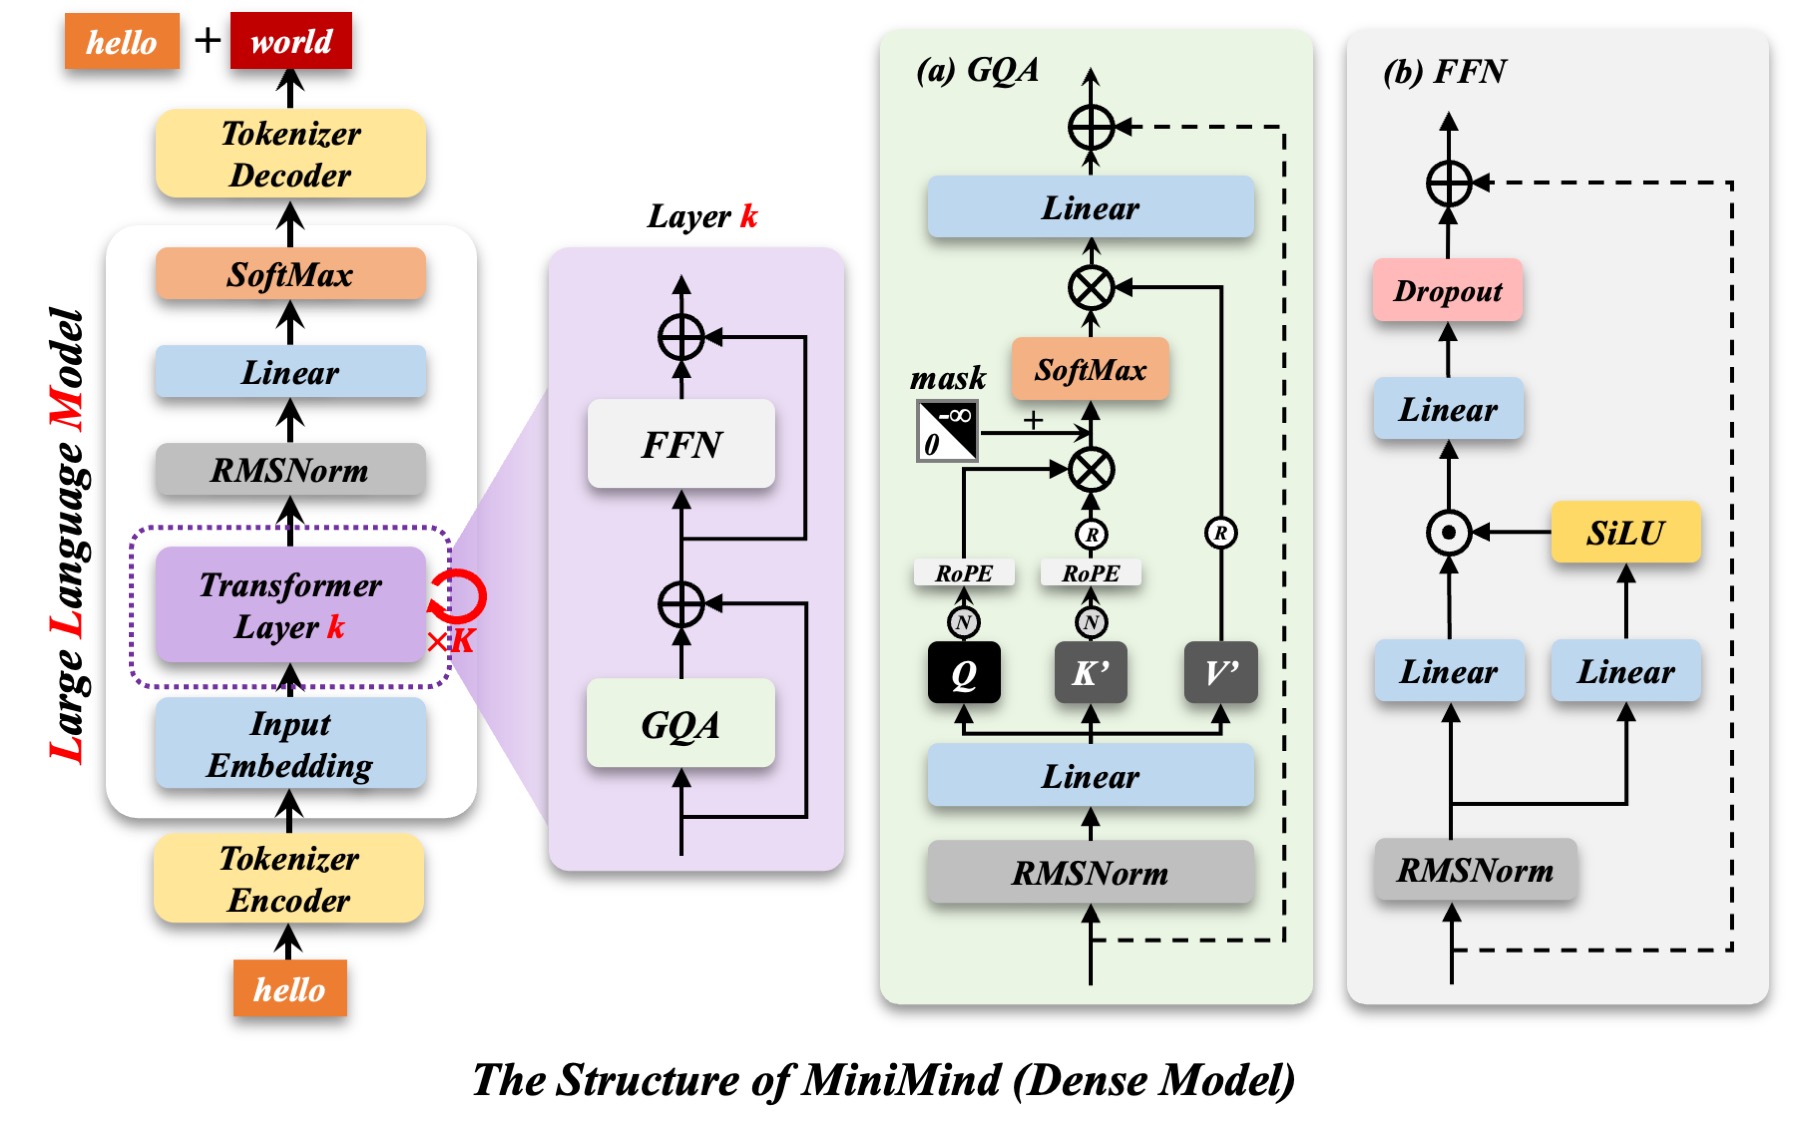
Dense 与 MoE 模型都有公开实现。可以沿着词嵌入、分组查询注意力(GQA)、RoPE、RMSNorm 和前馈层观察张量流动,再对照结构图理解每一层的作用。当前主线结构与 Qwen3 / Qwen3-MoE 生态衔接。
工具档案 TOOLAI
用小模型学习语言模型训练,从预训练、SFT 到工具调用。
 查看大图
认识这款工具
MiniMind 是一个面向语言模型学习与复现的开源项目。它公开模型结构、分词器、数据处理、预训练和微调代码,让读者可以在较小模型上追踪完整的训练过程。适合已有 Python 和深度学习基础、希望理解训练实现的人。
当前主线 MiniMind-3 Dense 约 6400 万参数,MoE 约 1.98 亿总参数、约 6400 万激活参数。历史的 MiniMind2-small 为 2600 万参数。2026 年 4 月的主线更新调整了模型结构、分词器、训练数据与推理接口,旧教程与新权重需要留意兼容性。
入门可先加载已发布模型,确认对话推理正常,再用两份 mini 数据完成预训练和 SFT。之后再逐项研究 LoRA、偏好优化或工具调用训练。代码无需购买套餐,硬件与云资源费用由使用者承担;模型知识、复杂推理和长文本表现仍受规模与数据限制。
看见实际效果
查看产品界面与已发布示例,点击图片了解更多。
从想法到结果
了解功能,再找到适合自己的用法。
Dense 与 MoE 模型都有公开实现。可以沿着词嵌入、分组查询注意力(GQA)、RoPE、RMSNorm 和前馈层观察张量流动,再对照结构图理解每一层的作用。当前主线结构与 Qwen3 / Qwen3-MoE 生态衔接。
预训练脚本读取 JSONL 文本样本,计算下一 token 的预测损失并保存权重。mini 数据适合先验证流程;更大的数据版本用于进一步训练。数据长度、清洗质量和学习率都会影响结果。
全参数 SFT 使用对话样本,在预训练权重上继续训练。当前主线数据包含基础工具调用内容,默认 full_sft 权重具备相应的基础能力。训练与推理应使用匹配的分词器和聊天模板。
仓库提供原生 LoRA 实现,用少量额外可训练参数调整模型,也提供合并导出流程。适合比较某类任务或表达方式的变化;适配器仍然依赖匹配的基础模型。
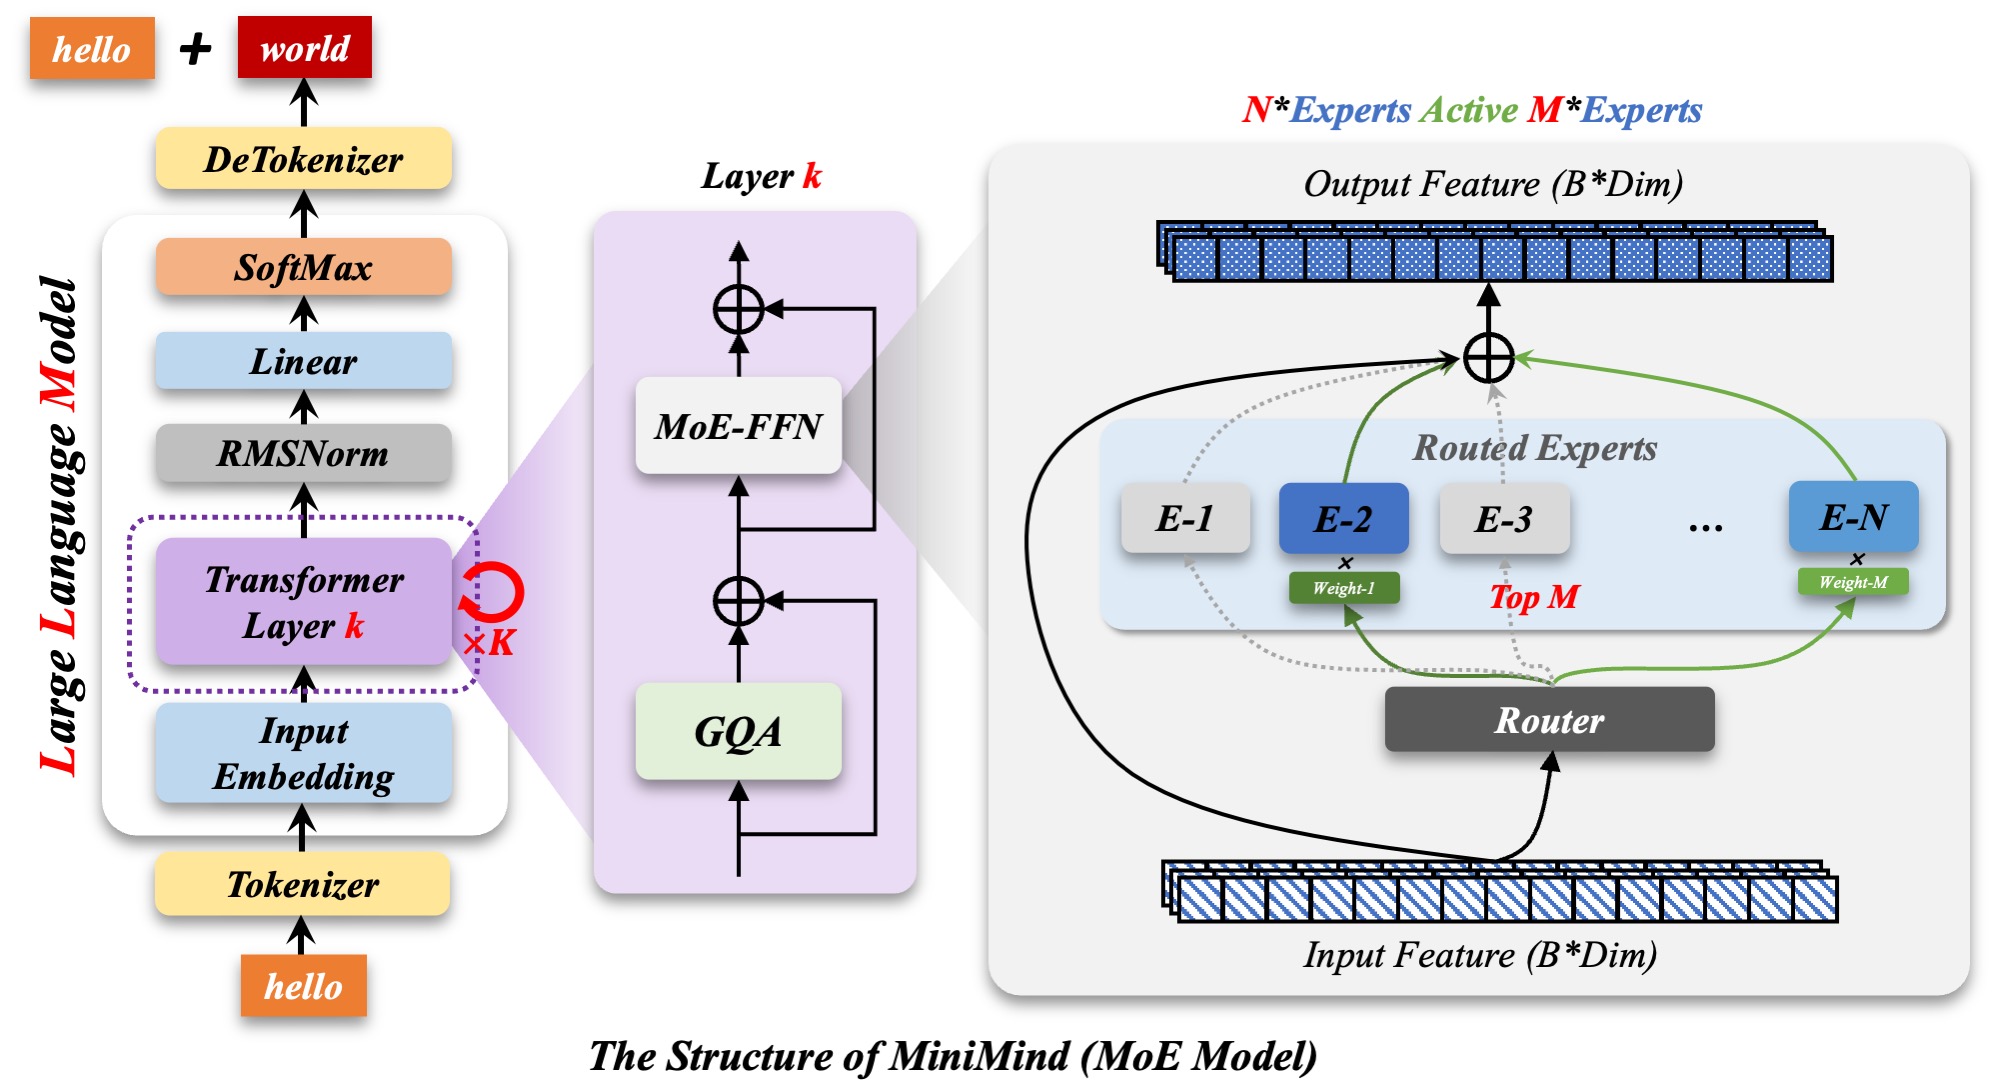
MiniMind-3-MoE 约有 1.98 亿总参数,每个 token 激活约 6400 万参数。可比较路由选择、辅助损失与 Dense 模型的差异。激活参数较少,并不意味着全部权重只占用相同规模的存储或显存。
DPO 使用成对的偏好回答调整模型,仓库提供相应脚本与数据读取方式。样本的选优标准会影响输出倾向,不能仅凭训练损失判断回答已经变得正确或可靠。
这些训练方法引入奖励信号,并包含生成、评分与参数更新过程。适合在基础训练跑通后研究。实验需要额外的生成计算,奖励设计不合适时,模型可能学会迎合评分而不是完成任务。
train_agent.py 面向多轮工具使用场景,支持 GRPO / CISPO。它把工具交互轨迹纳入训练流程,可以研究模型何时发起调用、怎样利用返回结果,以及如何处理后续轮次。
当前版本通过聊天模板、think 标记和 open_thinking 开关管理思考内容,不需要沿用旧教程中独立的 train_reason.py。显示思考内容与回答正确率是两回事,需要分别观察。
项目包含蒸馏以及数据清洗、去重和格式整理的相关实现。可以观察教师模型输出或训练信号怎样进入小模型。教师结果也可能包含错误,数据来源与使用权限需要单独检查。
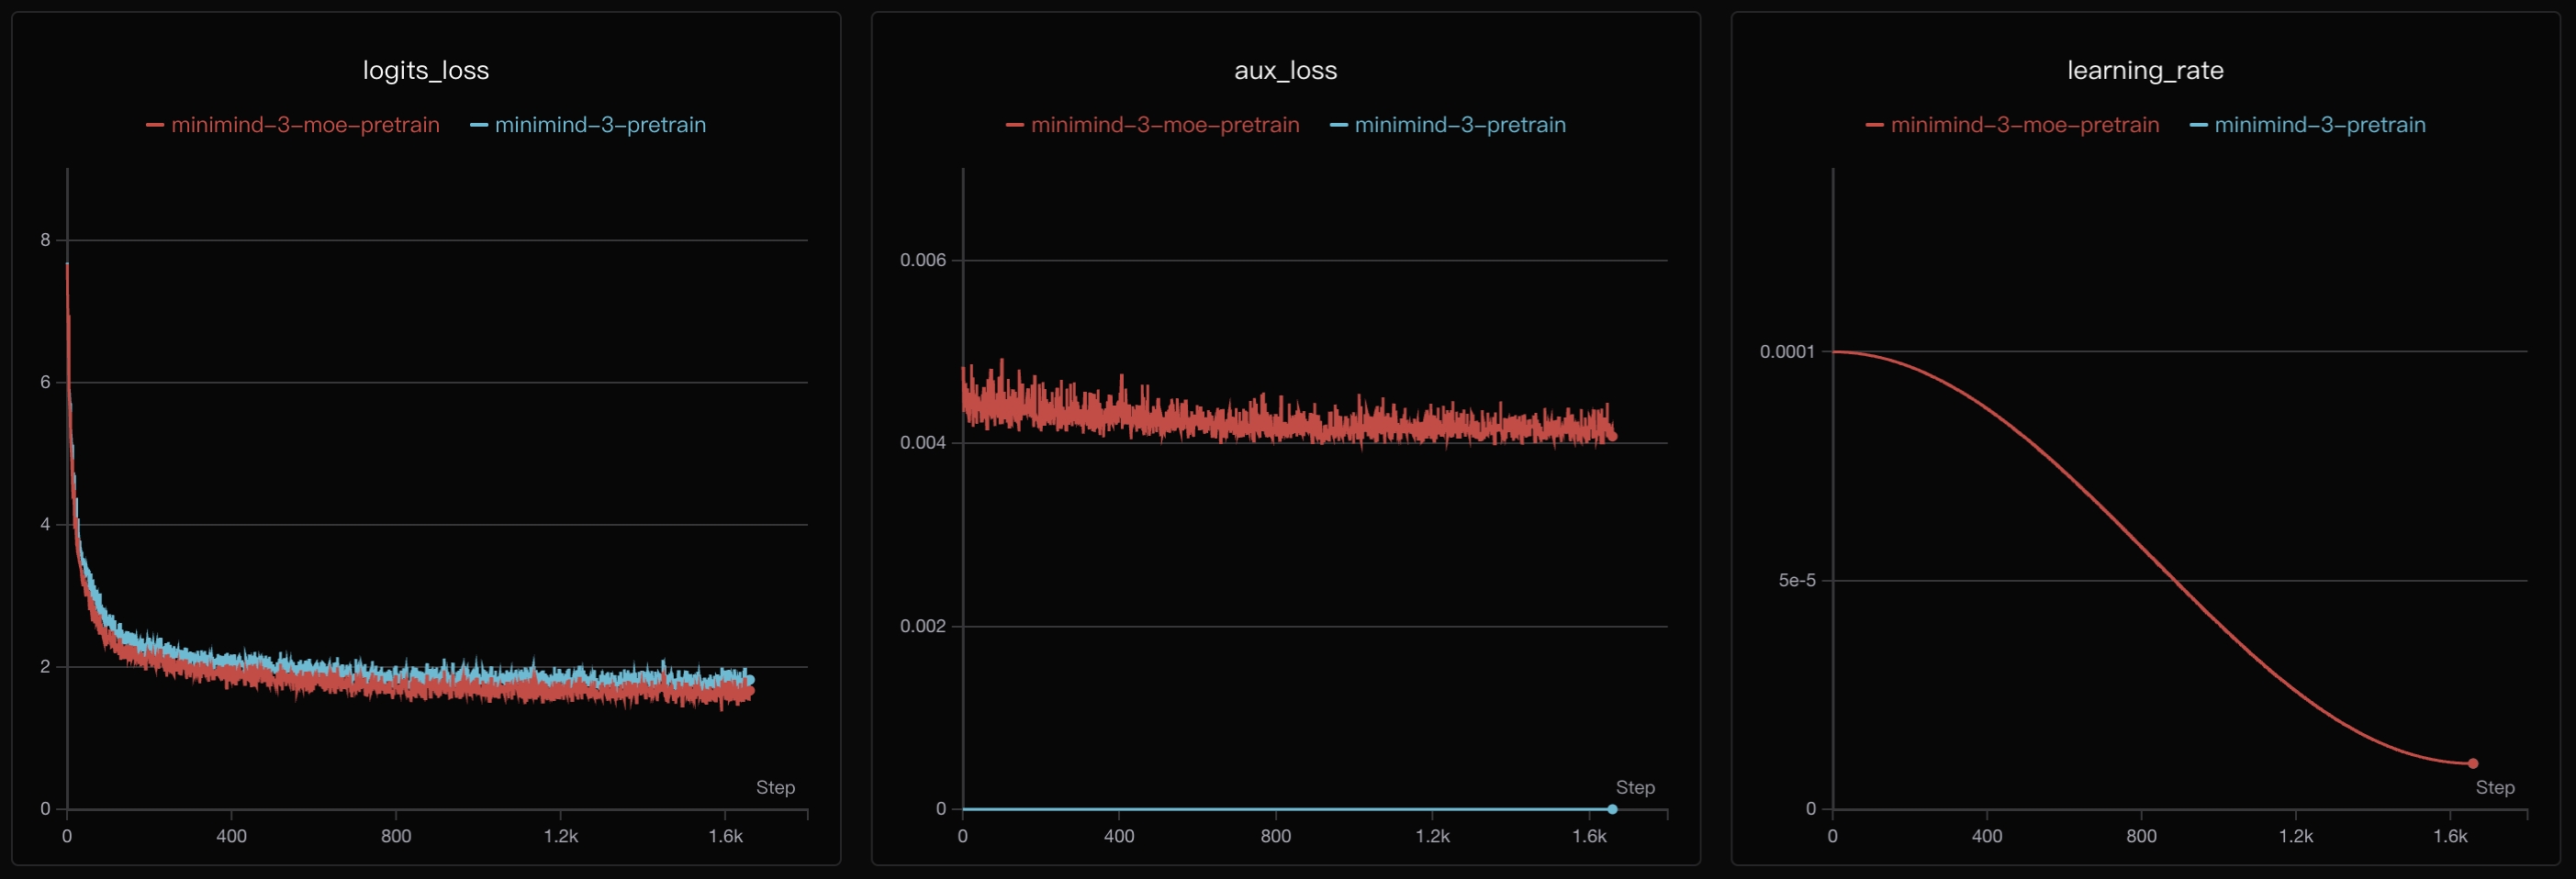
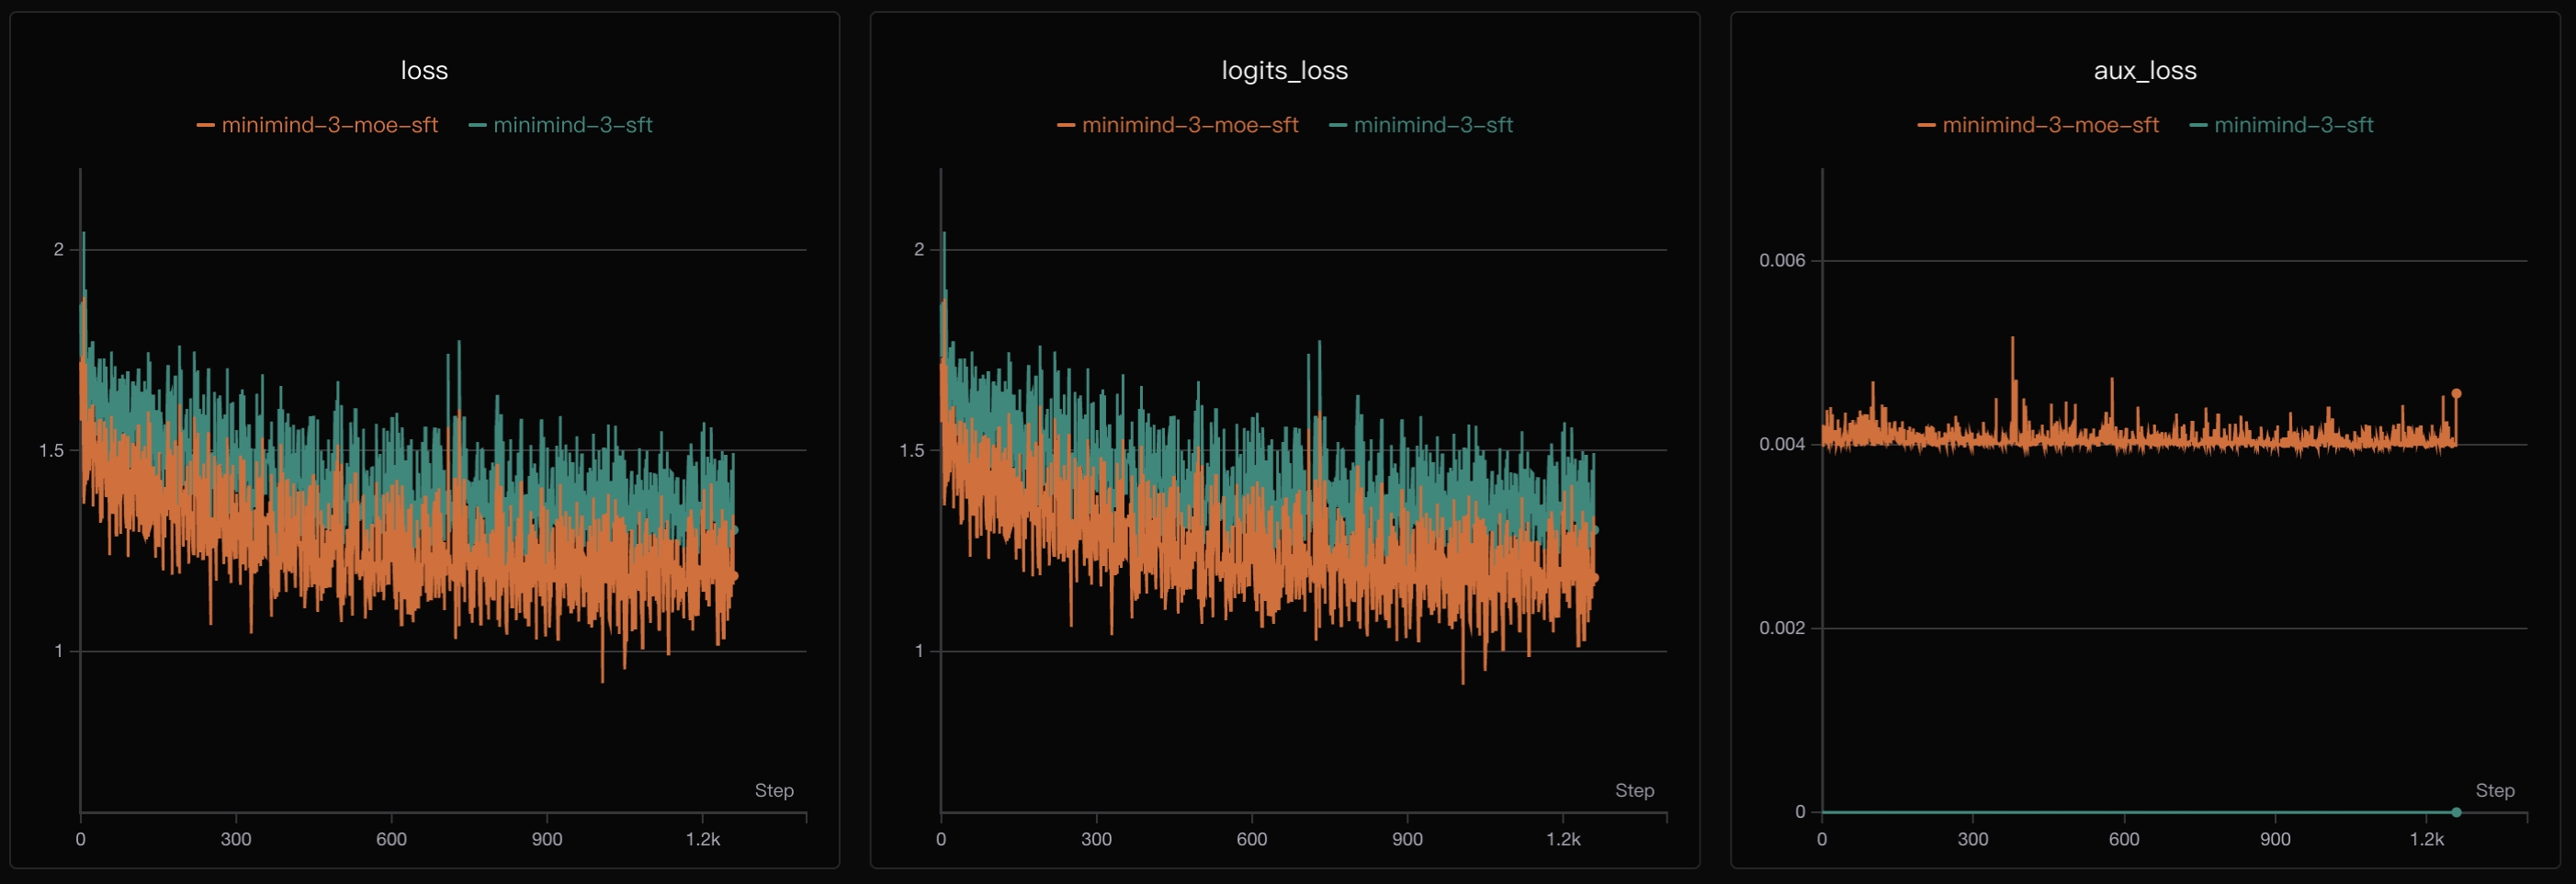
脚本支持记录损失、学习率和训练进度,并保存模型、优化器等续训状态。添加 --from_resume 1 可恢复已有检查点。用于继续训练的检查点,与单独用于推理的权重文件作用不同。
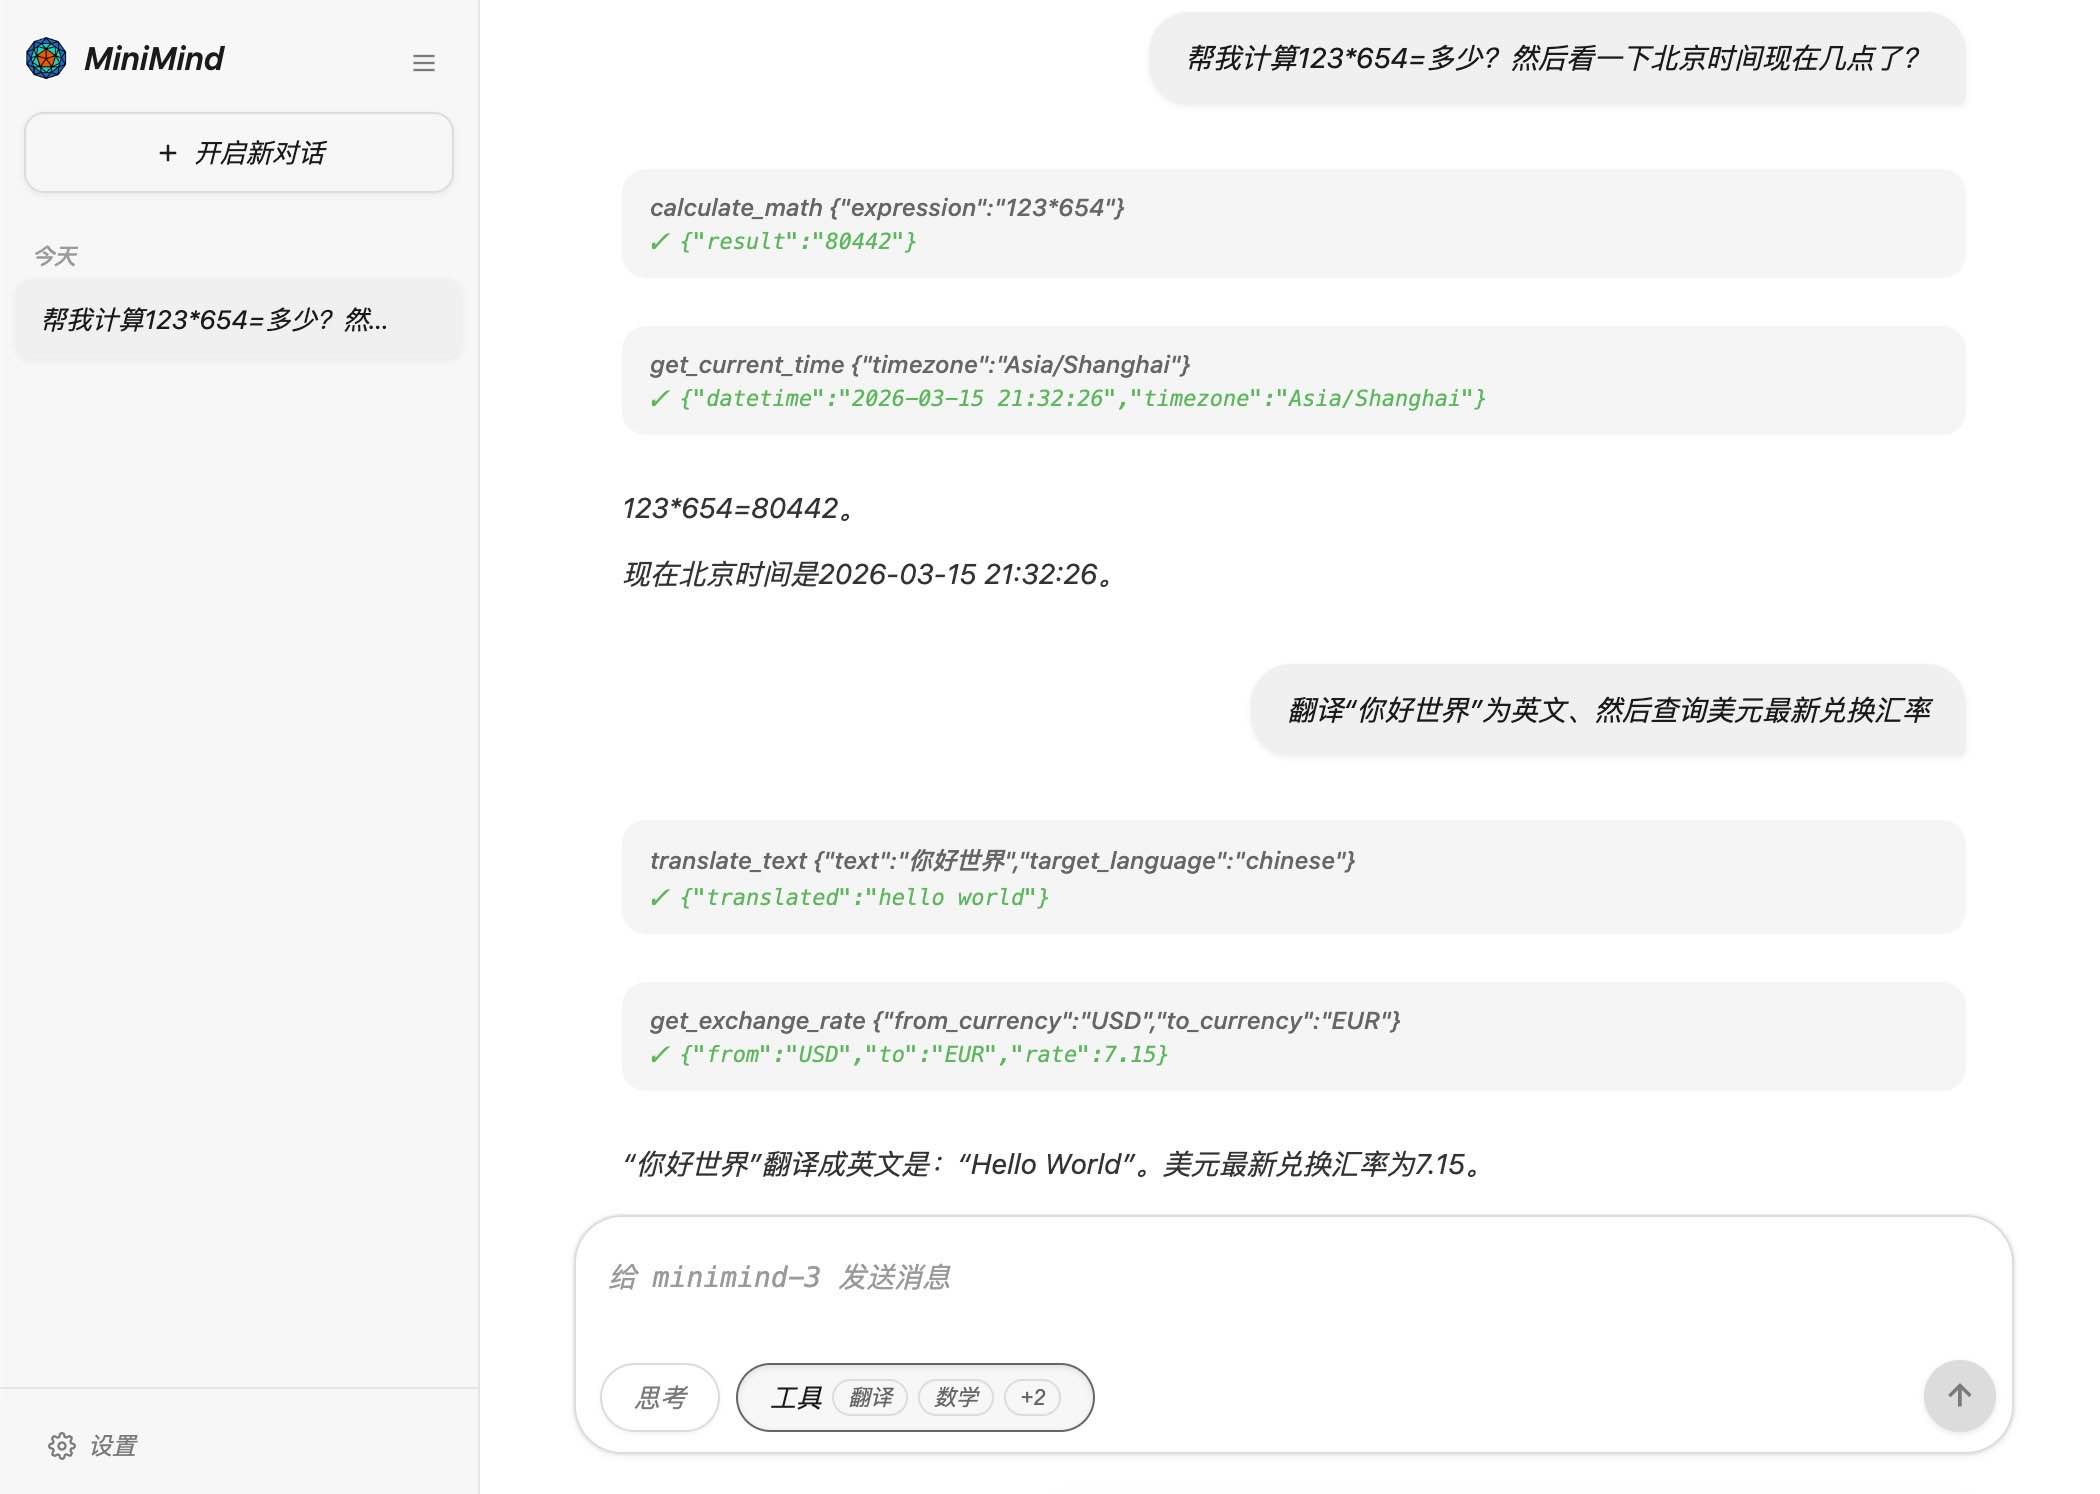
既可以通过 eval_llm.py 对话,也可以运行 Streamlit 聊天界面。WebUI 会扫描 scripts 下的模型子目录,使用 Transformers 格式模型时要先放到正确位置。界面支持思考展示、工具选择和多轮调用。
仓库提供兼容 OpenAI API 协议的最小服务示例,支持 reasoning_content、tool_calls 和 open_thinking;文档还列出 Ollama、vLLM、llama.cpp 等推理路径。接入时仍需检查模型格式与相应工具的版本。
项目包含 C-Eval、C-MMLU、OpenBookQA 等评估路径,代码采用 Apache 2.0。下载代码无需购买套餐;自己使用 GPU、存储或云服务时承担相应费用。业务任务应另外准备固定样本,检查事实、拒答和重复运行的一致性。
用在真正需要的地方
适合已经接触 Python、张量运算和基础深度学习的人。把一个样本经过的数据读取、前向计算、损失与权重更新串起来,之后再阅读更大模型的训练代码。
固定模型、评估样本与训练预算,替换一份 SFT 数据或比较 LoRA 与全参数微调。记录每次实验的版本、参数、数据量、耗时和错误回答。
观察专家路由、辅助损失和资源占用。应分别记录总参数、激活参数、权重大小及实际训练显存,避免仅用单个参数数字比较两类结构。
先使用已发布权重完成推理,再替换为自己的训练结果。固定一组中英文问题和生成参数,对比不同检查点的回答与速度。
用计算器、时间查询等可以明确核对结果的任务,观察工具参数、返回值和最终回答。图中的工具调用是作者演示,不能替代自己的测试。
模型规模较小,代码路径相对集中,便于按预训练、SFT 和评估分次讲解。设备、依赖和数据需要提前准备;讨论时可以保留失败样本,而不是只展示成功对话。
开始你的第一次尝试
克隆仓库,安装 requirements.txt,再为设备安装匹配的 PyTorch。README 参考配置为 Python 3.10.16、Ubuntu 20.04、CUDA 12.2;依赖清单中的 PyTorch 行被注释,不能假设它已经安装。
计划使用 CUDA 时确认 torch.cuda.is_available() 返回 True。记录仓库提交版本、显卡型号、可用显存和生成参数。作者的八卡工作站是参考设备,项目也支持单卡流程。
在仓库根目录下载 Transformers 格式的 minimind-3,然后运行 python eval_llm.py --load_from ./minimind-3。这个步骤主要确认模型、分词器与推理流程能够衔接。
把 pretrain_t2t_mini.jsonl 与 sft_t2t_mini.jsonl 放到 dataset 目录。预训练文本和 SFT 对话字段不同,先检查几条样本,再决定是否加入自己的数据。
进入 trainer 目录执行 python train_pretrain.py。默认隐藏维度为 768,默认两轮;权重输出到仓库的 out 目录。观察损失、学习率、耗时和可用显存,再考虑更大数据。
仍在 trainer 目录执行 python train_full_sft.py。默认加载 pretrain 权重,模型结构必须与前一步匹配。训练中断时,在原命令后加入 --from_resume 1 恢复现有检查点。
回到仓库根目录运行 python eval_llm.py --load_from ./model --weight full_sft。保持评估样本与采样参数固定,检查回答内容、错误类型和生成速度。训练数据中的问题不适合作为唯一评估集。
使用 WebUI 时先把 Transformers 模型目录放入 scripts,再运行 streamlit run web_demo.py。之后可以单独增加 LoRA、DPO 或 Agentic RL,并保存每次实验的数据、日志与权重。
它主要是开放代码、模型、数据与教程的训练项目,也提供命令行、WebUI 和在线演示入口。在线演示与自己训练是不同使用方式;下载仓库后,需要自行准备环境、模型或训练数据。
当前 MiniMind-3 Dense 主线约 6400 万参数。2600 万参数对应旧的 MiniMind2-small 等版本。旧教程、模型配置与新权重可能不匹配,复现时应记录同一代代码和模型。
MoE 模型总参数约 1.98 亿,每个 token 激活参数约 6400 万。完整模型仍需保存全部专家权重;不能把激活参数当作权重文件大小,也不能据此直接推断训练显存。
预训练阶段可以从新初始化的模型开始学习文本;SFT 通常继续使用预训练权重学习对话。LoRA 是另一种参数更新方式。下载现成 MiniMind-3 做推理,不属于自己完成了训练。
不包含。README 写的是单张 RTX 3090 上一轮 SFT 的实测时间和对应 GPU 租费。当前预训练和 SFT 脚本默认各两轮,环境配置、数据下载和其它训练阶段也另需时间。
不是。八卡是作者列出的参考工作站,项目提供单卡与多卡训练方式。具体设备能否跑下某个配置,还受批大小、序列长度、模型结构、精度和可用显存影响。
文档说明可以选择 CPU 或 MPS,但速度和兼容性差异明显;参考环境主要是 Linux 与 CUDA。Windows 还可能遇到依赖、路径和数据加载差异。先跑通已发布模型推理,再安排训练比较稳妥。
requirements.txt 中 PyTorch 行被注释掉。需要检查实际安装的 PyTorch 是否支持当前 CUDA,同时确认驱动、设备权限与环境。torch.cuda.is_available() 可作为第一项检查。
不可以直接互换。预训练主要读取文本,SFT 读取对话结构。文件名和后缀相似,不代表字段、模板或训练目标相同。自定义数据要先检查读取类、样本字段及长度截断。
out 中的权重文件主要用于推理或下一训练阶段。checkpoints 下的续训文件还保存优化器、进度等状态。恢复训练使用 --from_resume 1;加载对话模型则使用相应权重名称。
web_demo.py 扫描 scripts 下含权重文件的模型子目录。Transformers 格式模型如果只放在仓库根目录,就需要先复制到 scripts。单个 .pth 文件不能当作完整 Transformers 模型目录使用。
不能。图中展示了工具名称、参数、返回值与回答布局,是作者提供的示例。工具参数可能选错,返回值也需要检查;应另外测试错误输入、工具失败和结果核对。
它说明模型更贴合当前训练目标,但不能直接说明事实准确、推理正确或更安全。预训练与 SFT 的曲线也不是同一目标。应留出未用于训练的问题,记录错误与重复运行结果。
代码采用 Apache 2.0,通常允许商业使用,并有保留许可证和声明等义务。训练数据、下载权重、教师模型及第三方服务可能有各自条款;这些条件需要分别检查,不能只看代码许可证。
本地训练和推理可以使用本机文件,但启用 SwanLab 等实验记录、下载托管数据或调用外部工具时会发生相应网络访问。日志可能包含实验配置或文本。处理私有数据前,应检查实际脚本、记录选项与工具配置。
MiniMind-V 与 MiniMind-O 是关联项目;dLM 与线性注意力方向通过项目讨论等入口提供实验拓展。它们不应与 MiniMind-3 文本主线的默认能力混在一起介绍。
继续了解
分享实际使用心得
登录后分享真实体验,帮助其他人找到适合的工具。
发现更多可能
我们已经涵盖了每个用例。设计 AI 驱动的表单。为您的最终用户构建内容生成器。FormWise 是一种由 AI 提供支持的新型表单生成器。它采用表单响应并将它们作为变量注入到您自己的自定义 OpenAI 提示中。

使用 Wisemorph,您可以控制定义生成结果的结构和格式,确保一致和可靠的结果。与 Zapier 和 API 无缝集成,提供灵活性和效率。

粘贴 Youtube 视频 URL 并获取其摘要。您还可以在网站上查看趋势摘要。

我们是一家领先的人工智能技术公司,将软件即服务 (SaaS) 与人工智能 (AI) 相结合,为企业创造改变游戏规则的体验。我们提供用户友好的人工智能工具来促进创新和效率。
让想法成为下一步
前往官方网站,了解最新功能并开始你的体验。