画像生成器
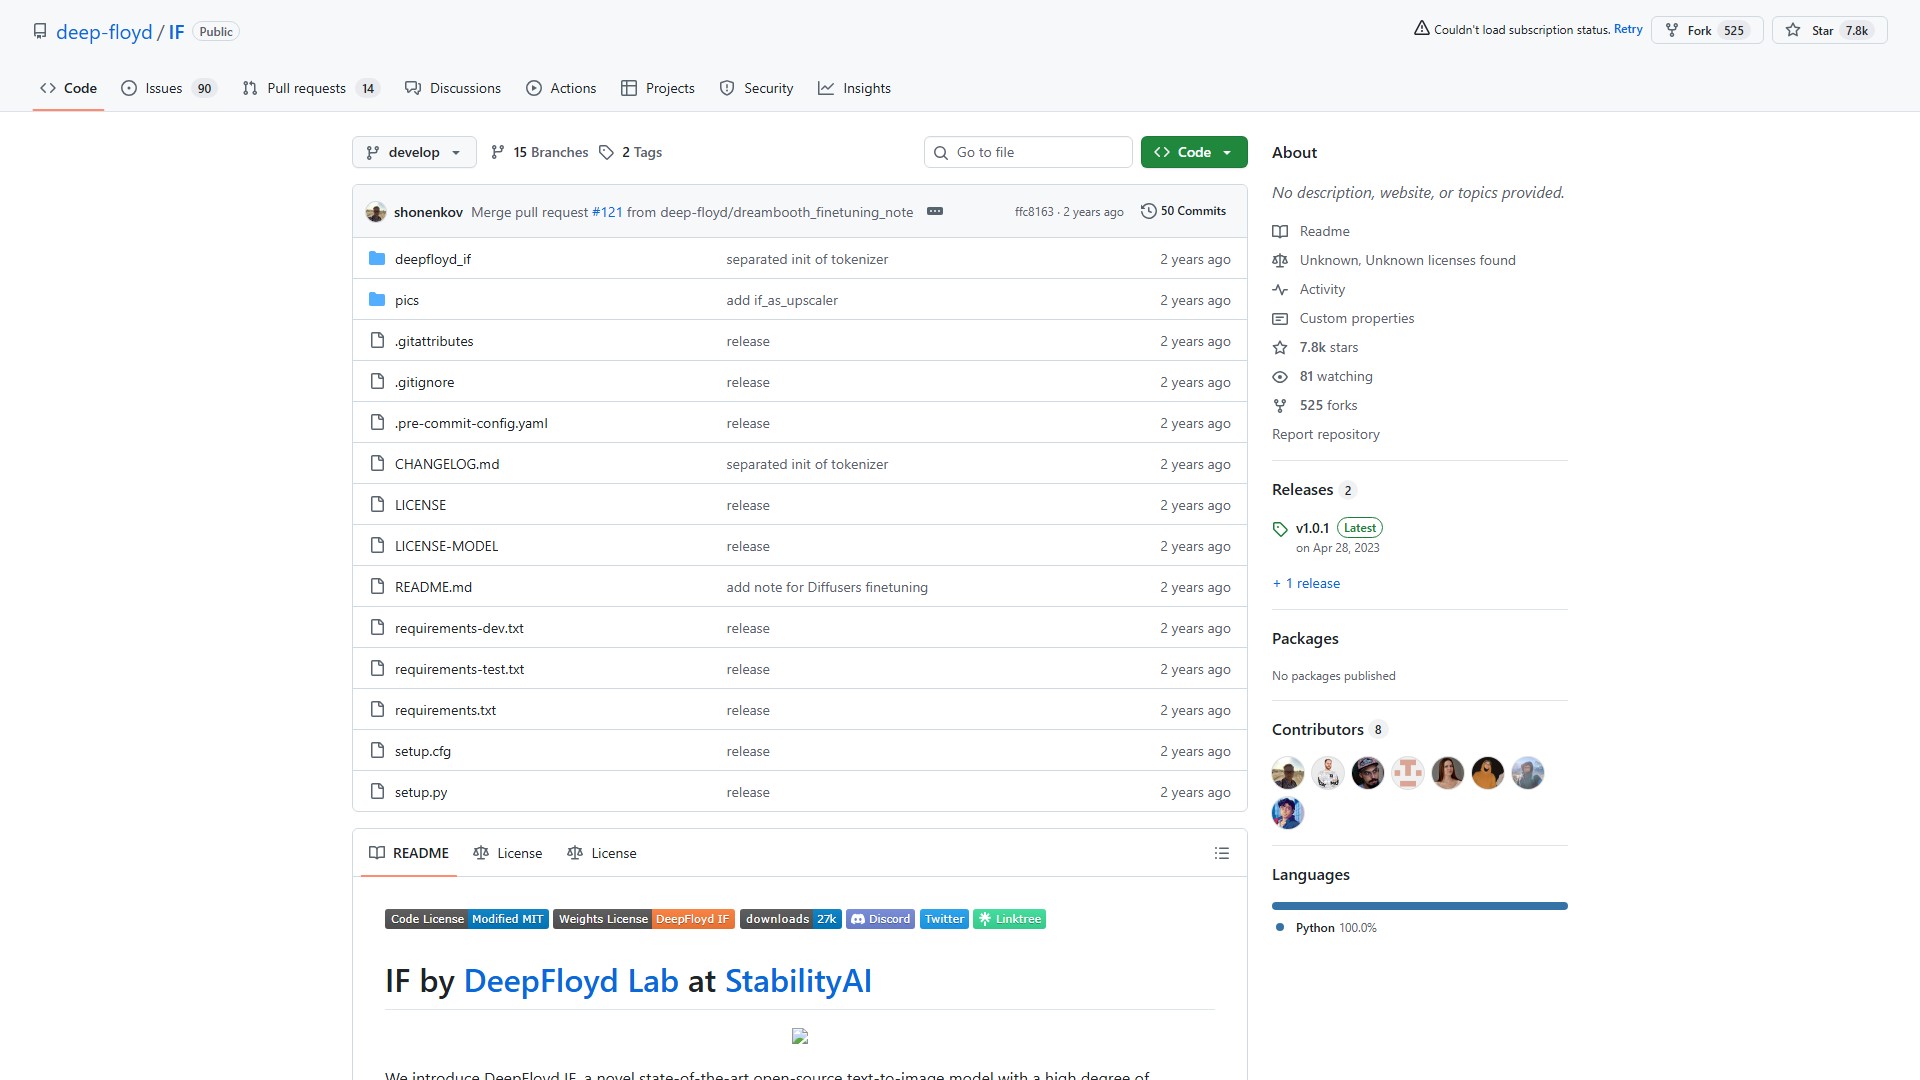
DeepFloyd IF
DeepFloyd IFは、凍結テキストエンコーダーと、64x64、256x256、1024x1024 pxの画像を生成する3段階のピクセル拡散モジュールで構成されたモジュール型モデルです。
このツールについて
主な機能と特徴
DeepFloyd IFは、凍結テキストエンコーダーと3つのカスケード型ピクセル拡散モジュールで構成されるモジュール型モデルです。テキストプロンプトから64x64 pxの画像を生成するベースモデルに加え、256x256 pxと1024x1024 pxという段階的に高い解像度の画像を生成する2つの超解像モデルを備えています。すべての段階で、T5トランスフォーマーを基盤とする凍結テキストエンコーダーを使ってテキスト埋め込みを抽出し、クロスアテンションとアテンションプーリングを備えたUNetアーキテクチャに入力します。COCOデータセットでゼロショットFIDスコア6.66を達成し、現在の最先端モデルを上回る性能を示しています。これは、カスケード型拡散モデルの第1段階における、より大規模なUNetアーキテクチャの可能性を示すものです。
主なモードと用途
- Dream(テキストから画像):テキストプロンプトに基づいて画像を生成します。
guidance_scaleやsample_timestep_respacingなどのパラメーターをカスタマイズできます。 - ゼロショット画像間変換(スタイル転送):
support_pil_imgのスタイルでプロンプトの出力を生成します。プロフェッショナルな折り紙、油彩、プラスチック製ブロック、クラシックアニメなどのスタイルに対応します。 - 超解像:IFで生成されていない画像にもIF-IIとIF-III、または
Stable x4を適用し、低解像度画像を高解像度に拡大できます。 - ゼロショットインペインティング:元画像、インペインティング用マスク、テキストプロンプトに基づいて、画像の一部を再描画します。
利用方法と統合
- Hugging Face Diffusersライブラリと統合でき、モデルをCPUへオフロードすることで、わずか14 GBのVRAMでIFパイプライン全体を実行できます。
torch>=2.0.0を使用する場合は、すべてのenable_xformers_memory_efficient_attention()関数を削除する必要があります。 - Hugging Faceアカウントを作成し、モデルカード上でライセンスに同意したうえで、アクセストークンを使って
huggingface_hubにローカルログインする必要があります。 - Pythonライブラリ
deepfloyd_ifを使ったローカルインストールにも対応しています。xformersとCLIPが必要です。
ハードウェア要件
- IF-I-XL (4.3B)とIF-II-L (1.2B)には最低16GBのVRAMが必要です。Stable x4アップスケーラーも含めて1024x1024まで処理するには24GBのVRAMが必要です。
xformersと、環境変数FORCE_MEM_EFFICIENT_ATTN=1の設定が必要です。
モデル一覧と規模
IF-I-M (400M)、IF-I-L (900M)、IF-I-XL (4.3B)、IF-II-M (450M)、IF-II-L (1.2B)、IF-III-L (700M)など、さまざまなパラメーター規模のモデルが含まれています。
料金とライセンス
コードは、特定の制限事項を含む独自ライセンスで公開されています。IFモデルの初期リリースは一時的に研究目的限定のライセンスで提供されており、後に完全なオープンソースモデルを公開する予定です。モデルの重みはHugging Faceから無料で利用できます。
トラフィック分析
このツールのトラフィック、ランキング、エンゲージメントの指標。
訪問数の推移
トレンドデータなし
エンゲージメント
- 直帰率--
- 1回の訪問あたりのページ数--
- 平均滞在時間--
トラフィックソース
ソースデータなし
上位の国
国別データなし
インターフェースプレビュー