
准备把开源模型接进业务,别把能下载权重当成能低价交付。在11月13日刊出的DeepTech 访谈转载中,前 Hugging Face 成员王铁震主张,把现有模型与真实数据结合,寻找商业回报,而不是只追参数和榜单。这给应用开发者的启发是:先证明一个任务能被稳定完成,再决定要不要换模型。
权重之外,运行中的实例也要付钱
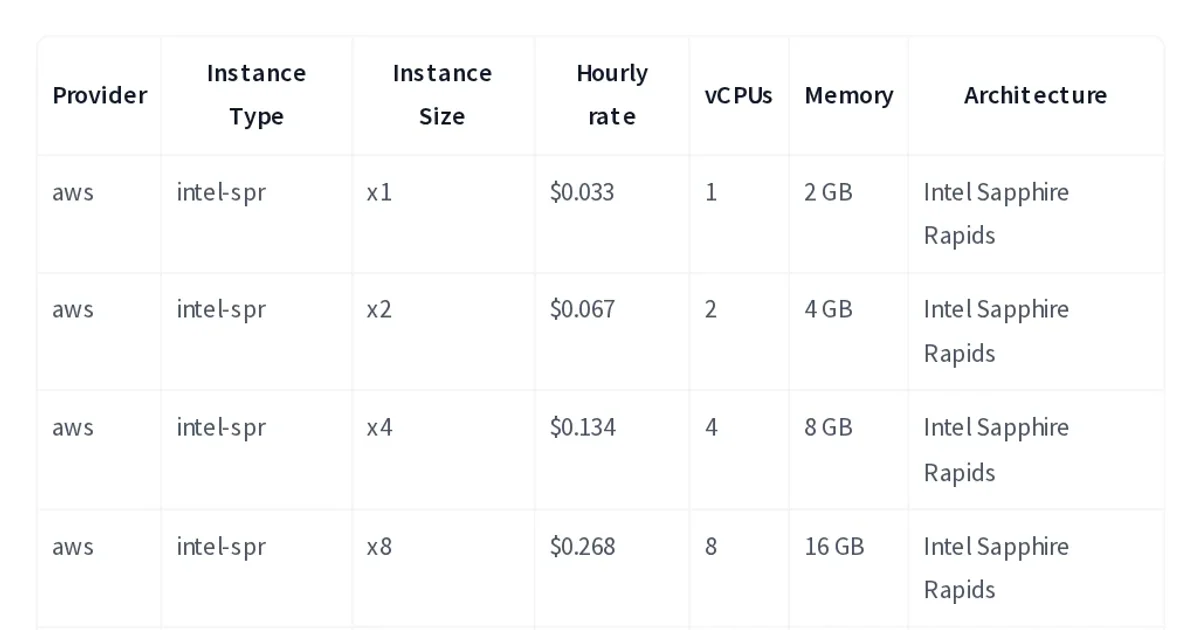
Hugging Face 的专用推理端点定价文档写得很具体:按所选实例提供小时单价,实际费用按分钟计算;成功部署的端点在初始化和运行状态下,使用的计算资源会被计费。这不是只在生成答案时才付费。
文档的基础示例使用 AWS CPU intel-spr x2 实例:每小时 0.067 美元,运行 1 小时、保持 1 个副本,费用为 0.067 美元。这只是计费示例,不是特定模型的适配推荐或完整部署报价。试跑前应把实例规格、运行时长和副本数量写进预算,而不是只比较模型下载是否免费。
避免空转,还要检查 Autoscaling:Automatic Scale-to-Zero 默认在无请求 1 小时后缩容到零,启用它需要把 Min 最小副本数设为 0。核对等待时间和副本下限,别因为演示成功就把服务一直开着。
“私有”认证不等于隔离网络
当前配置文档把认证和网络分开描述。认证选项中的 Private,允许本人或组织成员凭访问令牌调用;Public 则无需认证。但网络默认仍可通过互联网访问,并使用加密连接。AWS 部署可以另用 PrivateLink,将访问限制到指定虚拟私有云。
所以,接入内部资料前,要分别检查谁能调用、流量从哪里进入。不要看到 Private 就把它理解成已经断开公网,也不要把模型开放权重理解成数据自动留在本地。
我们的判断是,王铁震的建议更适合转化成一次小范围业务验证,而不是立即采购大机器。选一个已有任务,用有权使用的数据测试,记录错误后的人工返工和实际账单;如果换成更大的模型,仍省不掉返工,就先改数据接入和流程。能跑起来只是起点,能交付且算得过账,才值得扩大部署。