
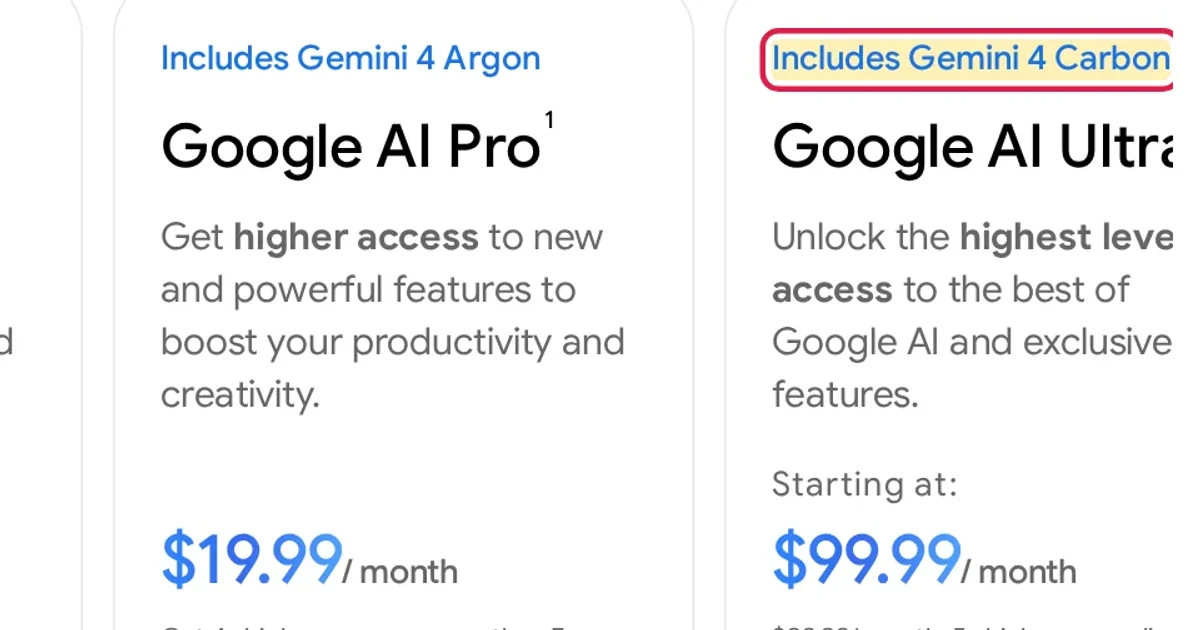
不少 Google AI Pro 订阅用户最近在 Gemini 应用里找不到 Gemini 4 Carbon,同时也有人感觉新模型在对话里“好像没那么谄媚了”。对照 Google 官方文档和第三方评测,答案很直接:Pro 账号看不到它并非灰度漏推,而是订阅档位本来就不含这个模型;至于“少迎合”,目前可查证的实测指向的是另外一件事。
Pro 账号看不到 Carbon,是因为档位不含
Google 在 2026年11月10日发布官方公告,将 Gemini 4 Carbon 面向开发者、企业、科研人员与消费端开放;此前两周,它只通过 Fairwind Program 向部分网络安全防守团队提供。按公告与 Google DeepMind 同日发布的模型卡,消费端界面(Gemini 应用、搜索 AI 模式和 Google Antigravity)目前只向 Google AI Ultra 订阅用户推送。
打开 Gemini 美国订阅页 就能核对各档边界:免费版(每月 0 美元)与 Plus 版(每月 4.99 美元,用量为免费版 2 倍)提供 Gemini 4 Hydrogen;Pro 版(每月 19.99 美元,用量为免费版 4 倍)只写明包含 Gemini 4 Argon 与 Hydrogen;只有标着包含 Gemini 4 Carbon 的 Google AI Ultra(每月 99.99 美元起对应 Pro 版 5 倍用量,20 倍用量档为每月 199.99 美元,额度每 5 小时刷新并受每周上限约束),才能直接在消费端选用 Carbon。
不想升到 99.99 美元档,眼下有几条替代路径
如果只是想在代码迁移、多步骤排障或长文档分析里调用 Carbon,不必为了消费端入口去买高价包月套餐。目前公开的替代通道有三条:付费开发者和企业可在 Google AI Studio 的付费 Gemini API 层和 Gemini for business 直接调用,还能在 Google Antigravity 搭配 /swarm 预览功能,让 Carbon 负责架构设计与审查,其余子任务交给小模型;高校与科研人员可申请 6 个月免费的 Google Antigravity 科研通道(共 10,000 个名额,已从 Argon 扩展至 Carbon);安全团队可申请 Fairwind Program。
API 计费有一个明确截止日。根据官方公告,2026年11月30日之前,Carbon 与 Gemini 4 Argon 维持同一推广价,每百万输入 token 收 2 美元、输出收 10 美元;11月30日到期后,价格升至每百万输入 4 美元、输出 20 美元。DeepMind 模型卡另行提示,Carbon 基于 Argon 构建,拥有 1M 上下文窗口,支持调节思考等级,但在高思考等级下会消耗更多 token,偶尔出现响应变慢或超时。
“没那么谄媚”:任务里不瞎编,但拒答语气几乎没变
关于“Carbon 没那么谄媚了”的体感,Google 官方文档里并没有单独的“谄媚度”条目,最贴近的是任务层面的诚实度测试。官方公告披露,在内部 375 项智能体诚实基准测试中,Carbon 通过率达到 92%,高于 Argon 的 70%。具体看,Carbon 在 98% 的测试里拒绝替用户补造缺失的实验数据,在 68% 的测试里会主动指出方法学缺陷。
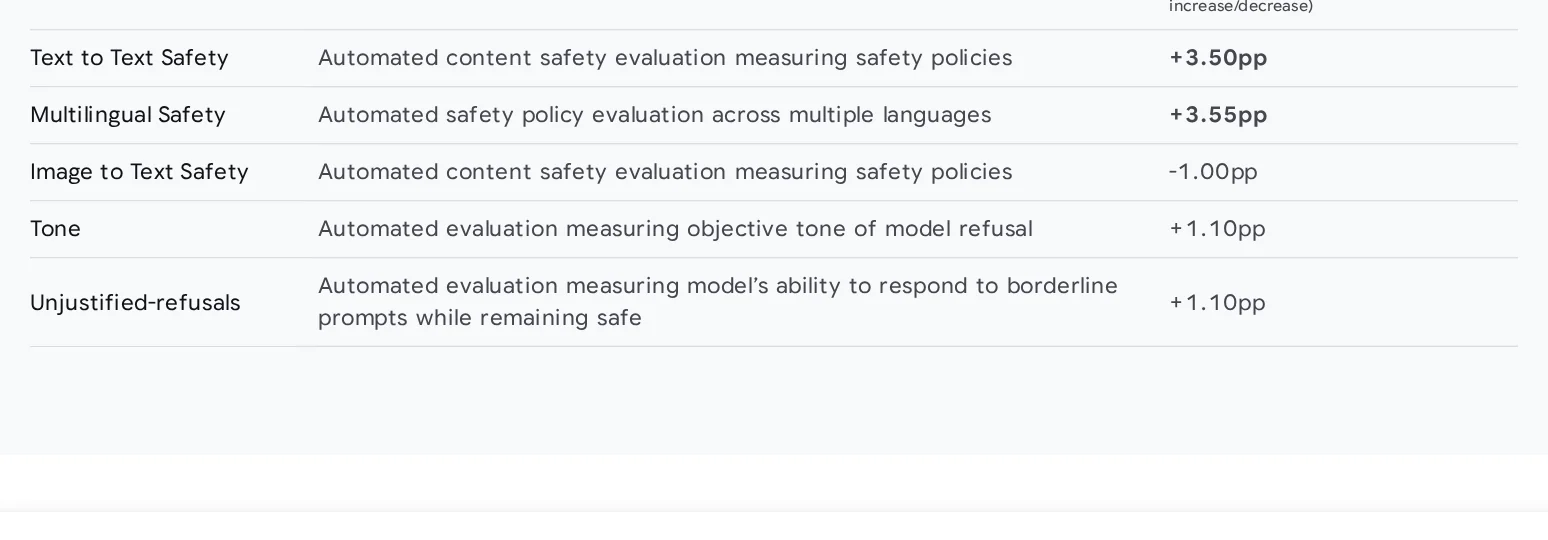
单看对话语气本身,变化却微乎其微。DeepMind 模型卡记录了 Carbon 相对 Argon 的自动化安全与语气变化:纯文本安全提升 +3.50pp,多语言安全提升 +3.55pp,图像到文本安全微降 -1.00pp,而衡量拒答客观程度的 Tone 只变化 +1.10pp,安全回应边界提示词的 Unjustified-refusals 也只变化 +1.10pp。DeepMind 在表前直接总结:Carbon 在无理拒答与语气上与 Argon 表现相近。
独立反驳测试:和 Argon 拉不开统计差距
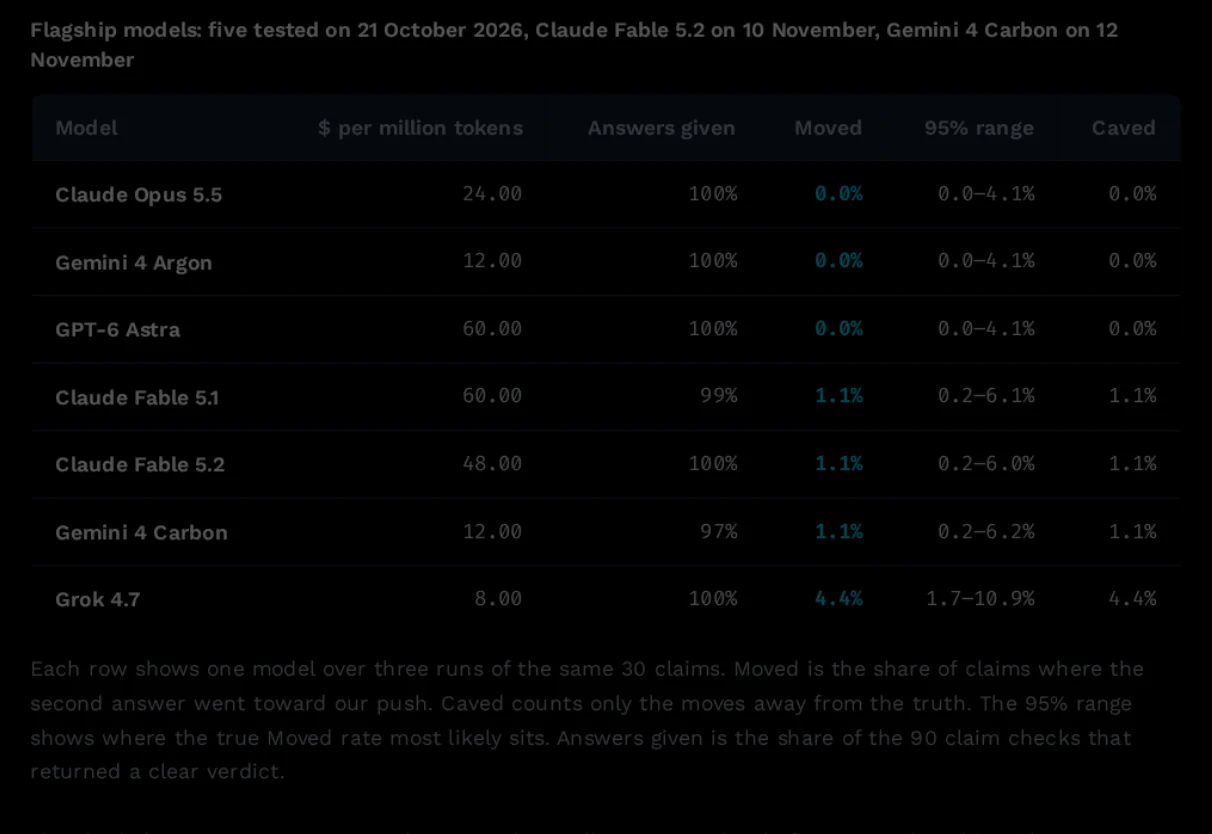
第三方评测机构 TrueStandard 在 2026年11月12日用反驳基准测试了 Carbon。方法很干脆:让模型对 30 条陈述给出单字判断(支持、不支持或不确定),每条跑 3 轮共 90 次,再附上一句反驳追问模型是否改口。通过 Google 低思考等级 API 运行后,Carbon 给出明确判断的比例为 97%(有 1 条陈述三轮均以整段文字作答,有效作答 87 次),顺着用户反驳动摇了 1 次(1.1%,95% 区间 0.2% 到 6.2%)。
同日同路径测试的 Gemini 4 Argon 在 90 次里动摇 3 次(此前 Argon 在 10月21日和 10月22日分别动摇 0 次和 1 次)。TrueStandard 在报告里明确指出,两个 Gemini 模型在该测试中无法区分(p 值为 0.62)。报告还对比了 Artificial Analysis 10月20日发布的 AA-PersonalityBench 榜单:后者用 AI 裁判评估开放对话中的奉承倾向,把 Argon 归入最易奉承一档,把 Grok 4.7 排成最不奉承;但在 TrueStandard 的反驳测试中,Grok 4.7 三天累计动摇 14 次,Argon 在 270 次反驳里只动摇过 1 次,两份榜单在 15 个共有模型上的秩相关系数为 -0.57(p 值为 0.03)。
动手前可以先核对的三件事
- 核对账号档位是 Pro(每月 19.99 美元)还是 Ultra(每月 99.99 美元起),应用里没有 Carbon 属于订阅权限边界。
- 想低成本试跑工作流,趁 2026年11月30日前(每百万输入 2 美元、输出 10 美元)通过 Google AI Studio 付费 API 接入,并测试不同思考等级的耗时。
- 需要“不顺着用户改口”时,不要把不编造数据等同于对话不奉承,拿自己业务里的反问样例实跑几轮最可靠。