
如果你正在给机械臂或具身硬件挑控制方案,这周有个直接影响选型的消息。据《财富》在2026年11月13日刊发的独家报道,OpenAI 证实已撤销独立机器人团队,理由是包含 GPT-6 Astra 在内的通用前沿模型无需专门训练就能直接控制硬件。省掉示教采集与动作微调、直接调 API 驱动机械臂,听着确实诱人。先别急着改架构。真正往控制器上接之前,得先把推理延迟、费用统计范围和复现门槛摊开算清。
最具参考价值的公开实测,来自英伟达西雅图机器人实验室在 CoRL 2026 发布的 Astranomy 研究报告。团队把推理档位设为 medium 的 GPT-6 Astra 零样本接入 DROID 机械臂仿真环境,跑完 120 项抓取与放置任务的 RoboLab-120 基准:最高配置拿到 74.8% 成功率,超出榜首专用策略 Lakeside(51.0%)达 23.8 个百分点。但代价很扎眼。直接调 API 请求动作时,单次调用平均要等 18.56 秒。
三路画面加提示词零样本驱动,但无状态直连得选对动作格式
不同于 π0.5 这类在训练时就固定动作空间的视觉语言动作模型,GPT-6 Astra 的控制协议全靠推理提示词临时定义。每次调用传入左肩、右肩和手腕三路宽 384 像素、高 216 像素的相机画面,附上夹爪与相机几何参数,单次输出上限设为 8,192 个补全 Token。
动作表示的差距主要集中在无状态直连(Direct Policy)下。跑满 RoboLab-120 的 120 项任务时,输出绝对末端执行器位姿(EEF)能拿到 66.3% 成功率(得分 76.7%),换成关节位置仍有 50.2%(得分 63.7%),关节空间 B 样条则掉到 38.8%(得分 53.7%)。这不代表模型天生算不好关节角。在 30 项任务消融实验中,直连末端位姿成功率为 72.7%,一旦换上保留交互历史的 Agentic Policy,末端位姿(86.0%)与关节位置(84.0%)就几乎拉平。只有在不带持久记忆的 API 直连下,锁定末端位姿才是稳妥选择。
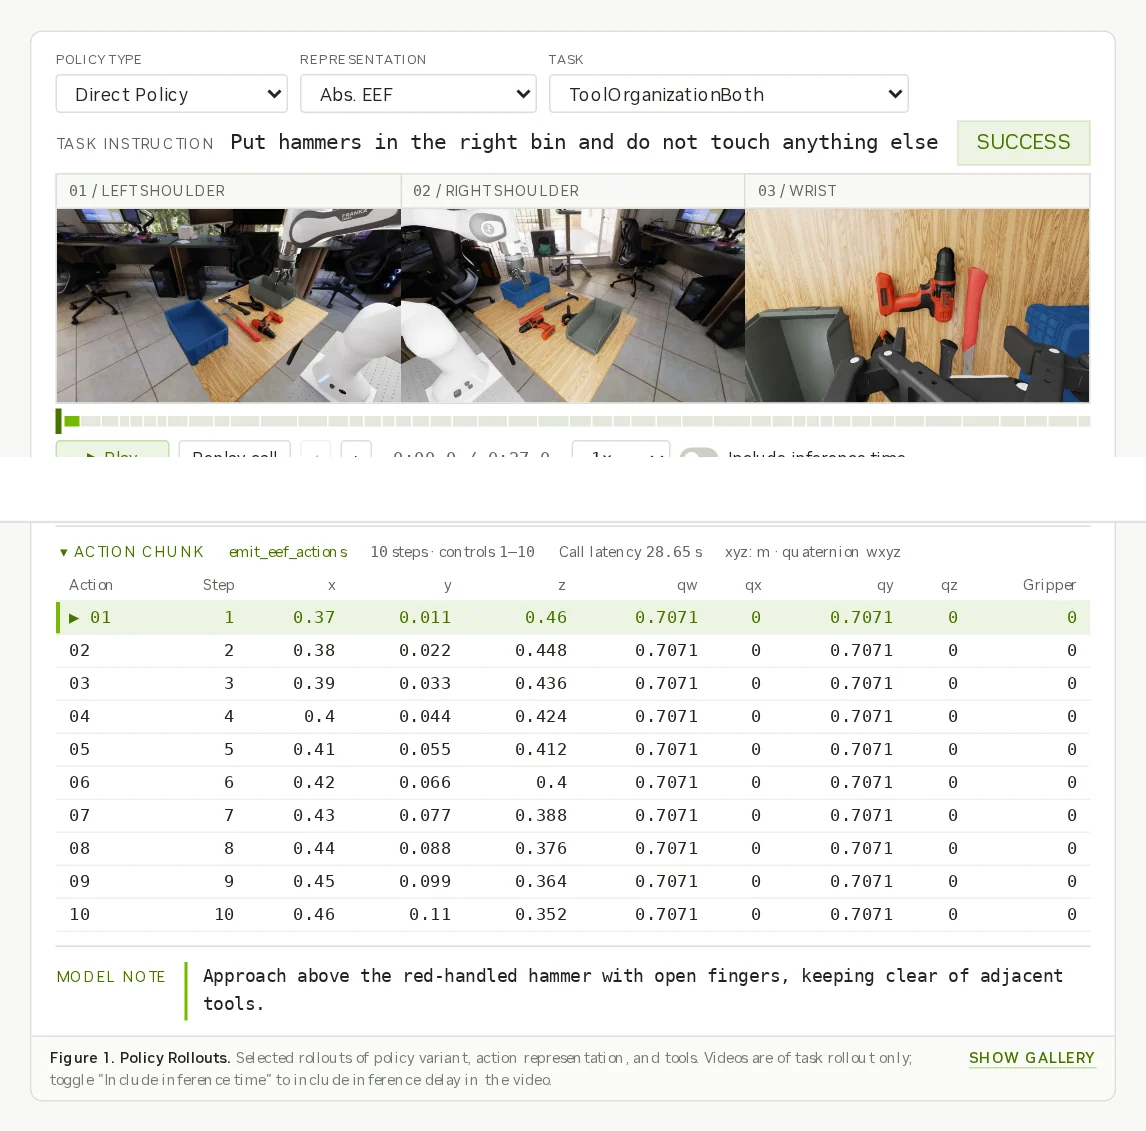
可变步长动作分块同样有代价。传统机器人模型每次固定输出相同步数,而 Direct Policy 允许模型在提示词区间内自选步数(默认 3 到 15 步),空旷移位时多走几步、贴近目标时缩短步长重看画面。但拉长步长并不白赚。在 30 项任务消融中,把动态步长从 3 到 15 步扩至 16 到 32 步后,成功回合调用次数虽减少 62%,平均任务耗时却相近,成功率反而从 72.7% 跌到 66.7%。
三种闭环接法三份账单:Codex 会话最准,成功回合均费 36.40 美元
围绕外围脚手架搭多重,Astranomy 对比了三种闭环方案,性能与开销分化极端:
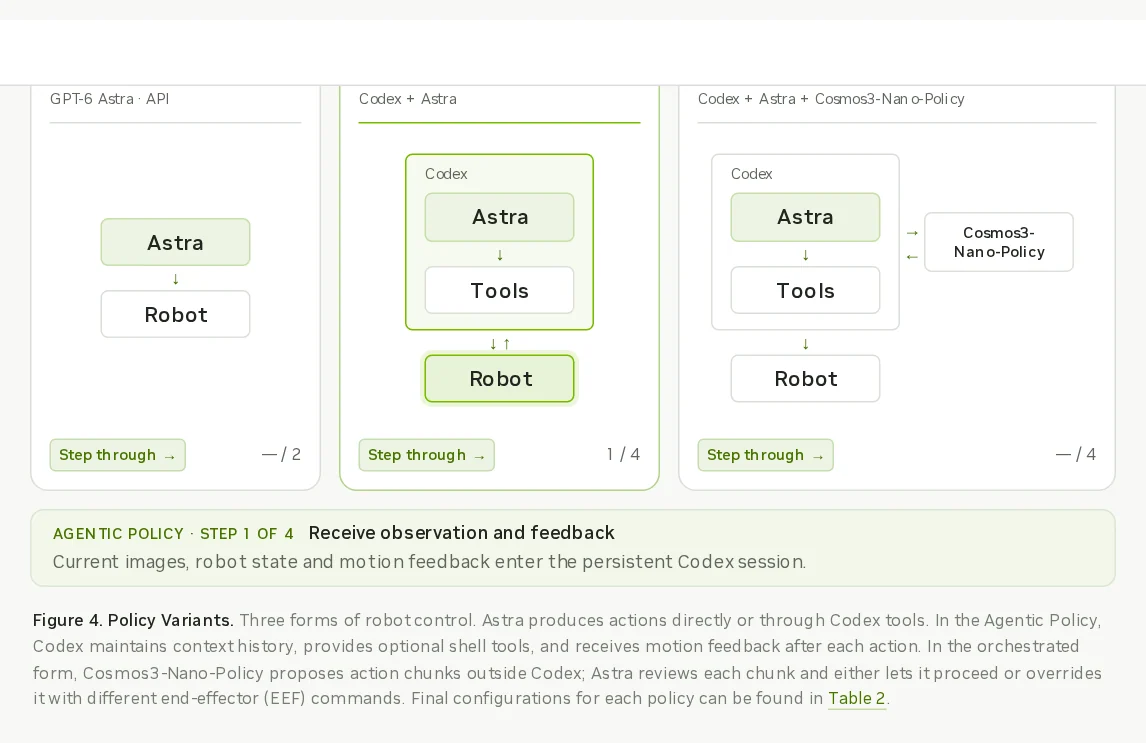
- Direct Policy(API 直连):无状态 API 直接把采样观测映射成动作块,调用间不留对话历史。成功率 66.3%,单次调用耗时 18.56 秒,每个成功回合平均消耗 160k Token(1.96 美元)。
- Agentic Policy(Codex 持久会话):在持久 Codex 会话里保留完整图文历史与运动反馈,每执行 1 到 5 个控制步重看画面。别把可选能力和基准成绩混为一谈:跑出 74.8% 成功率(得分 83.6%)的基准配置禁用了内置 shell、图像查看和代码执行等可选工具,仅保留策略输出工具与
memory_*观测归档工具;单次调用耗时 13.37 秒,成功回合均耗高达 30.9M Token(36.40 美元)。 - Orchestrated Policy(协同监督):由 DROID 数据微调的世界动作模型 Cosmos3-Nano-Policy 每次提议 15 步轨迹,Codex 内的 GPT-6 Astra 在禁用可选原生工具下以有限记忆审查,必要时修改提议或改发末端位姿。成功率 66.5%(得分 79.1%),两侧单次延迟 11.50 秒与 2.74 秒,成功回合均耗 11.0M Token(17.72 美元)。
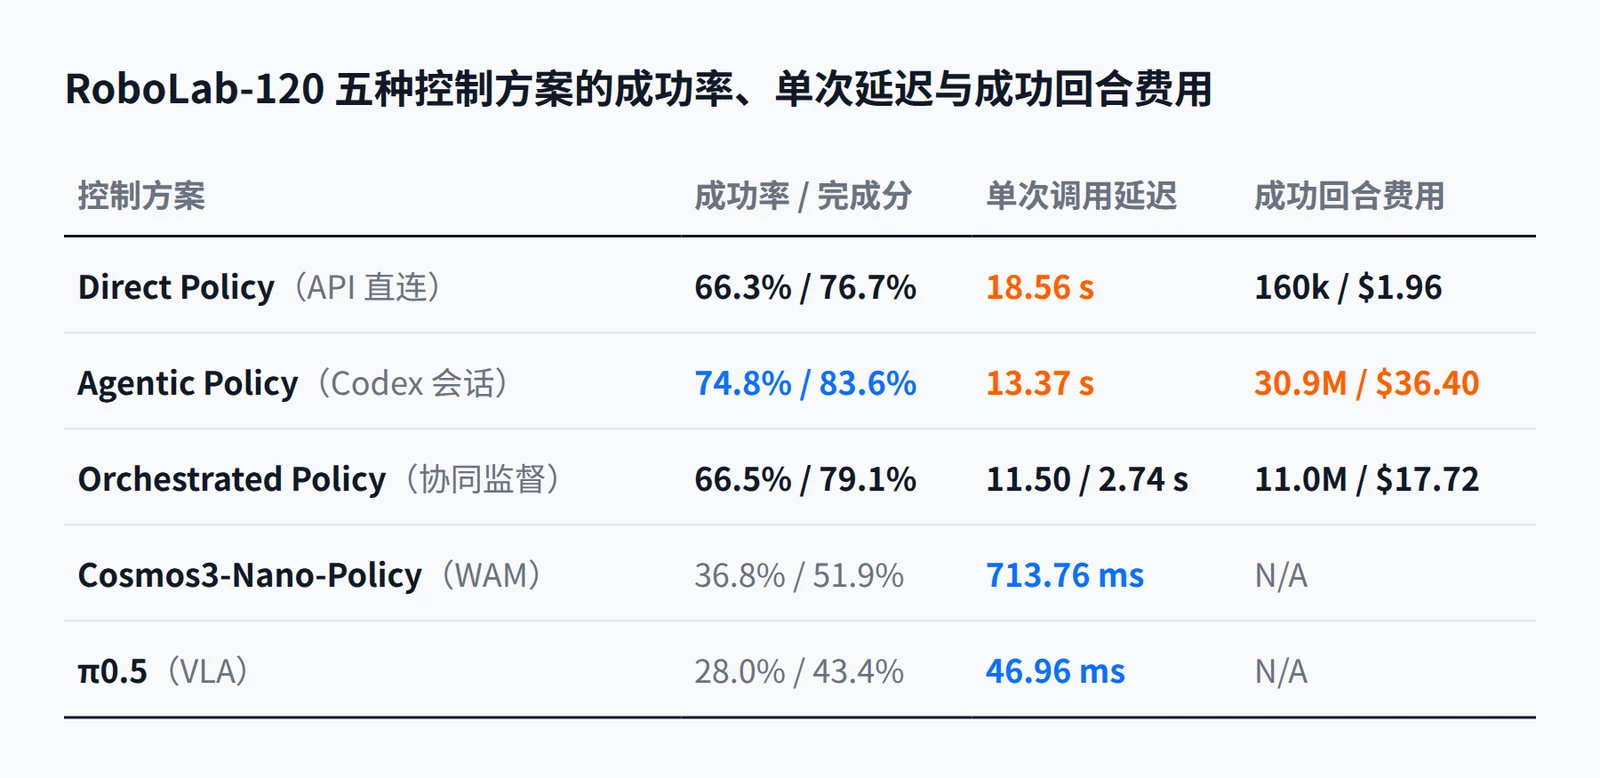
差距不在外部辅助工具。持久会话靠跨步历史、memory_* 观测归档和短步反馈拉高了抓空后的纠错率,可多视角长上下文累加也把开销从 1.96 美元推高到 36.40 美元。算账时还得留意报告内部的一处统计差异:摘要将上述数字简称为每回合开销,但图 2 图注与费用章节明确写明,它们是按2026年10月1日定价估算的“成功回合 API 费用”。耗尽步数仍失败的回合并未计入均值,不能把 1.96 美元当成实际项目的单局调试预算上限。受开销限制,英伟达在 NVIDIA L40s GPU 上跑满 120 项任务时,每项也只测了 5 局固定随机种子。
仿真器能按暂停键等你,今天想复现还得先过两道门槛
实验设计开头写明了一句关键前提:底层控制器虽按 15 Hz 运行,但等待模型推理期间仿真器处于暂停状态。
真机没有暂停键。数字环境里 GPT-6 Astra 花 13.37 秒或 18.56 秒推理时,桌面物体定格不动;同表本地模型 Cosmos3-Nano-Policy 单次调用为 713.76 毫秒,π0.5 为 46.96 毫秒。但这两组毫秒数字同样只是单次策略产出动作块的推理延迟,并非在 15 Hz 控制环里逐步同步计算,报告也未在真实机械臂上验证实时性。卡内基梅隆大学机器人研究所助理教授 Guanya Shi 对《财富》指出,云端大模型慢且依赖持续联网,板载电脑上仍离不开可离线运行的小型专用模型。
附录逐项任务表(表 A1)还暴露了能力偏科,且必须把任务成功率与部分完成得分分开看。按红蓝绿黄顺序叠积木时,两款专用模型成功率均为 0.0%,Astra 的 Direct EEF 达 100.0%,Agentic 与 Orchestrated 均为 80.0%(完成得分 93.2%);但在收小玩具留鸟屋任务上,Direct EEF 与 Agentic 成功率为 80.0%,Orchestrated 却与专用模型同为 0.0%(完成得分 42.2%)。碰到摆贝果或抓电钻这类精细接触动作,Astra 三种模式的任务成功率全部归零——哪怕中途拿到过阶段分(摆贝果上后两者完成得分为 20.0%、30.0%,抓电钻上 Orchestrated 虽有 100.0% 完成得分但最终成功率仍为 0.0%)。
代码虽然开了,门槛还在。英伟达已在 GitHub 公开 NVlabs/RoboLab 仓库下的 ai_native 目录:Direct-API(默认请求 gpt-6-astra)与 Agentic(需安装 @openai/codex@0.149.1)现已开放,Orchestrated 仍标为即将推出。动手前先核对两道硬条件:本地须配齐 Linux GPU 机器及 IsaacSim、IsaacLab 与 RoboLab 资产;且仓库文档明确提醒,运行账号本身必须已开通 GPT-6 Astra 访问权限,自带模型列表并非权限证明。
拿到模型权限后,建议把部署架构当作待实机验证的假设推进。准静态桌面或容许停顿的离线拆解,可先试跑 Direct-API 绝对末端位姿(默认 3 到 15 步分块),避开多轮上下文累加,同时为失败回合预留额外 Token 预算;若面向不能暂停干等 13.37 秒至 18.56 秒的连续物理作业,则需在真机上测试靠动作分块或“46.96 毫秒至 713.76 毫秒本地策略配合 GPT-6 Astra 异步高层监督”来解耦策略更新频率与 15 Hz 控制环,以实测端到端延迟为准。