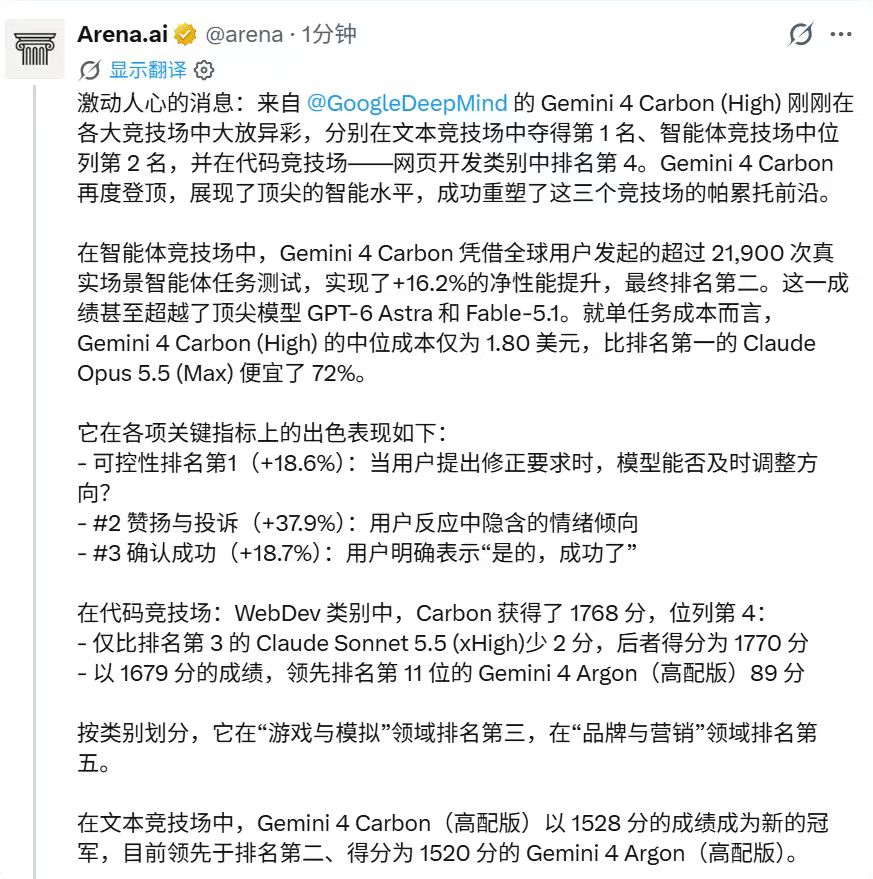
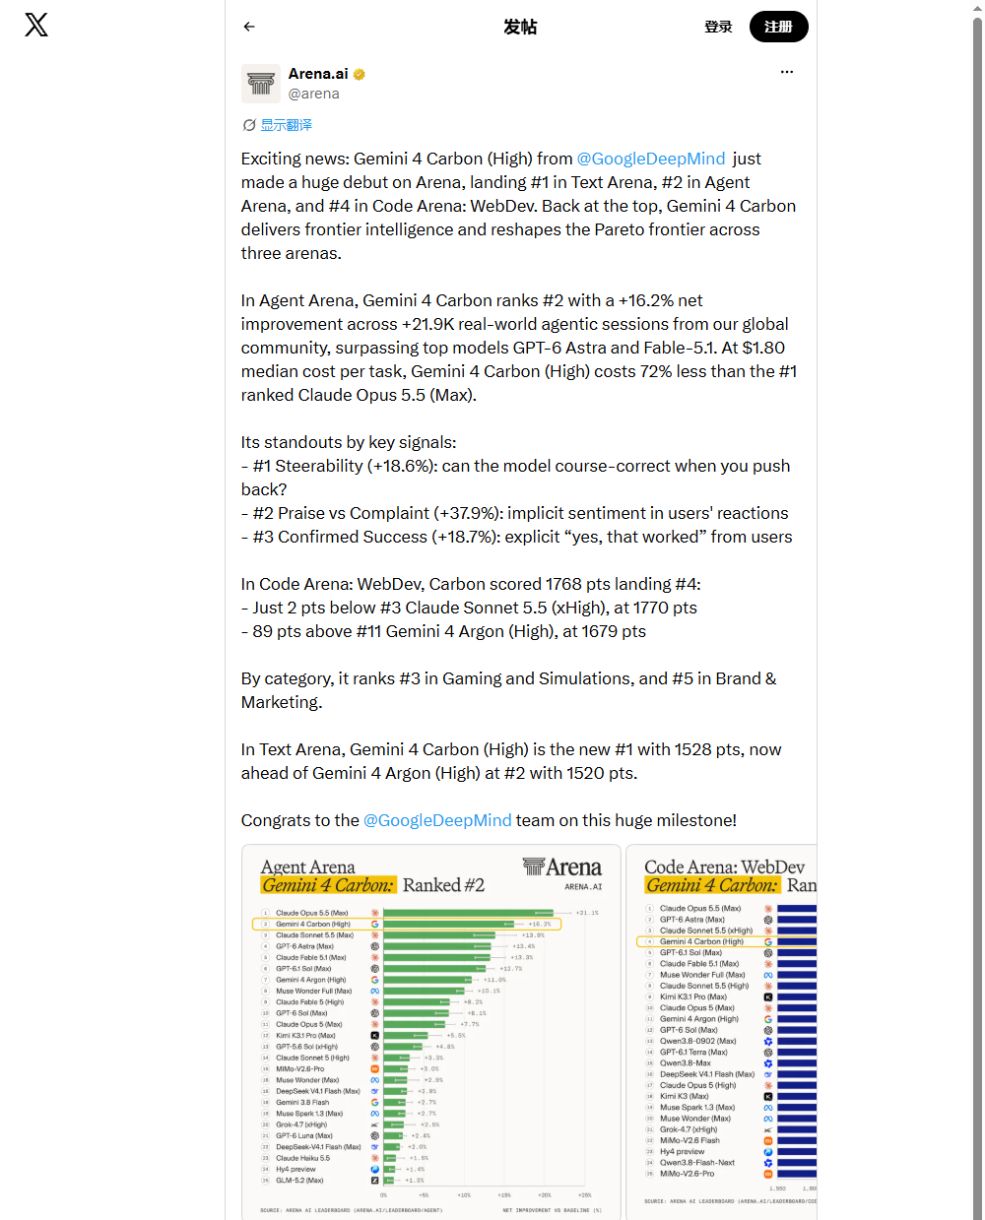
Gemini 4 Carbon(High)在 Arena 首轮公告中取得文本第 1、智能体第 2、网页开发第 4。比冠军标签更值得关注的是,它在多种任务上表现较强,同时进入性能与成本的比较范围。以下数字采用这次公告快照,榜单继续更新会改变分数和顺序。
三个榜单回答三个问题
文本榜的 1528 分,使 Carbon 在公告时领先 1520 分的 Gemini 4 Argon(High)。WebDev 为 1768 分、排名第 4,距离第 3 名 Claude Sonnet 5.5(xHigh)的 1770 分仅差 2 分。智能体榜给出的指标是 +16.2% 净改善、排名第 2,公告称依据超过 21,900 次真实场景会话。
这些数字不在同一刻度上。文本偏好、网页开发评分和智能体净改善衡量不同对象。+16.2% 不是任务成功率只有 16.2%,也不代表相对每个竞争模型都提升了 16.2%。比较时应保留指标名称与任务定义。
每任务 1.80 美元是什么意思
Arena 给出的任务成本中位数为 1.80 美元,称其比排名第一的 Claude Opus 5.5(Max)低 72%。这是评估场景下的任务成本统计,不是每次 API 请求的固定售价,也不是所有业务都能取得相同比例的节省。
对多次调用工具的智能体,完成任务的成本比 token 单价更贴近日常使用。单价更低却反复重试的模型,未必总成本更低。比较时应把成功率、耗时、重试和人工接管一起记录。
反馈信号提供了什么信息
公告中的可控性排第 1(+18.6%),赞扬与投诉信号排第 2(+37.9%),明确成功反馈排第 3(+18.7%)。它们帮助观察模型能否接受纠正、用户反应的情绪倾向,以及用户是否明确确认结果可用。
这些信号提供交互信息,却不能替代业务验收。用户说“可以了”后仍可能有遗漏,没有赞扬也不等于失败。生产环境还要检查保存状态、权限、数据正确性和重复执行行为。
小分差不等于确定胜负
核对文本榜时,Carbon 标记为 Preliminary,分数 1528±9,Argon 为 1520±6。8 分差伴随着重叠的区间,支持公告时排名领先的描述,不支持推导所有文本任务都明显胜出。WebDev 的 2 分差也不宜夸大。
Google 发布文章与 Arena 公告中的 WebDev 分数属于不同快照,本文统一使用 Arena 原帖的 1768,避免把不同时间的数据拼成一张榜。榜单适合发现候选模型,选型还要回到自己的任务集合。
能否马上接入自己的产品
Google 的发布说明将首批访问面向部分网络防御人员,并通过 Fairwind 扩展至可信合作伙伴,更广泛的消费者、开发者和企业开放安排在后续。榜单出现模型,不等于自己的账户已经有可调用接口。
团队可以先准备题集和记录格式,获得访问后再运行。接入、配额和错误处理尚未验证前,不应只因排名替换生产模型。可用性与能力需要分别确认。
一份可重复的小型评估计划
选三类真实任务:长文理解、需要纠正的多轮工具任务、网页实现。固定输入、权限和验收条件,记录输出、调用次数、耗时、成本与返工。网页除了外观,还要验证按钮、表单、窄屏和刷新后的状态。
最终比较的是完成同一件事的代价。Carbon 的首轮成绩足以进入候选名单;在相同工作流中反复观察,才能判断它是否适合替换或补充当前模型。
英文原帖与中文截图