
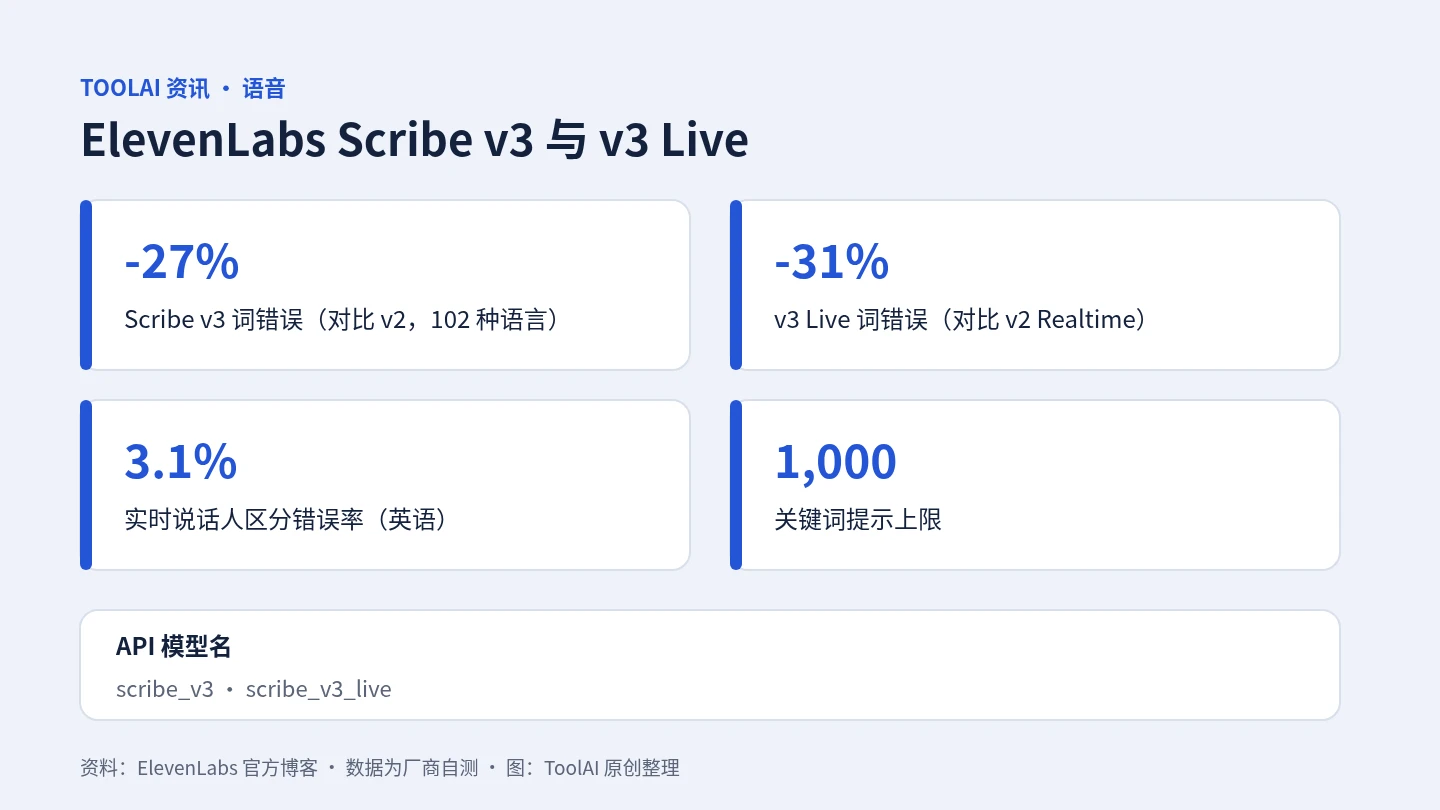
ElevenLabs 11 月 10 日发布两款语音转文字模型:处理录音的 Scribe v3 和处理实时语音的 Scribe v3 Live,两者已成为 ElevenLabs 应用里的默认模型。API 中的模型名分别是 scribe_v3 和 scribe_v3_live,已经接入 Scribe v2 的项目改模型名就能切换。用 ElevenAgents 搭建的语音智能体也可以用 Scribe v3 Live。
关键变化
- 错误更少:ElevenLabs 称在 FLEURS 基准的 102 种语言上,Scribe v3 的词错误比 v2 少 27%;德语降幅最大(42%),西班牙语 35%,英语 23%。
- 实时转写更准:Scribe v3 Live 比 Scribe v2 Realtime 的词错误少 31%,改变原意的错误少 43%。
- 实时区分说话人:Live 现在能边转写边区分说话人。在 ElevenLabs 的英语测试中错误率为 3.1%,其他受测实时模型为 5.9% 到 7.3%。录音转写的说话人区分错误减少 12%,三人以上的录音减少 17%。
- 专有词控制:关键词提示最多 1,000 个;Live 另有可容纳数千个词的词库,只在疑似命中时才查。
- Live 的对话功能:根据对话内容判断谁该接话,不只看停顿;可以提示语言,也支持一句话里中途换语言;数字可以输出为阿拉伯数字或单词。
数据与合规
默认在美国处理,另有欧盟、印度、新加坡的独立环境。零保留模式会在请求结束后删除音频和文字。ElevenLabs 列出的认证有 SOC 2、ISO 27001、PCI DSS 一级;签署业务伙伴协议后可用于 HIPAA 场景。针对医疗对话优化的 Scribe v3 Live 版本将在 ElevenAgents 中推出。
对用户有什么影响
做会议记录、采访整理和字幕的用户,最直接的变化是要改的地方更少,非英语音频尤其明显。对客服中心和语音智能体,更重要的是实时区分说话人,以及对人名、邮编、产品名的识别:ElevenLabs 引用的一家能源公司称,邮编一次识别正确的比例提高了 40%。以上准确率都是 ElevenLabs 自己的数据,发布稿也没有写价格,大量使用前先确认自己套餐的计费。
相关工具
本站的 ElevenLabs 工具页,以及同类的 AssemblyAI、Otter.ai、Fireflies.ai、Descript。