
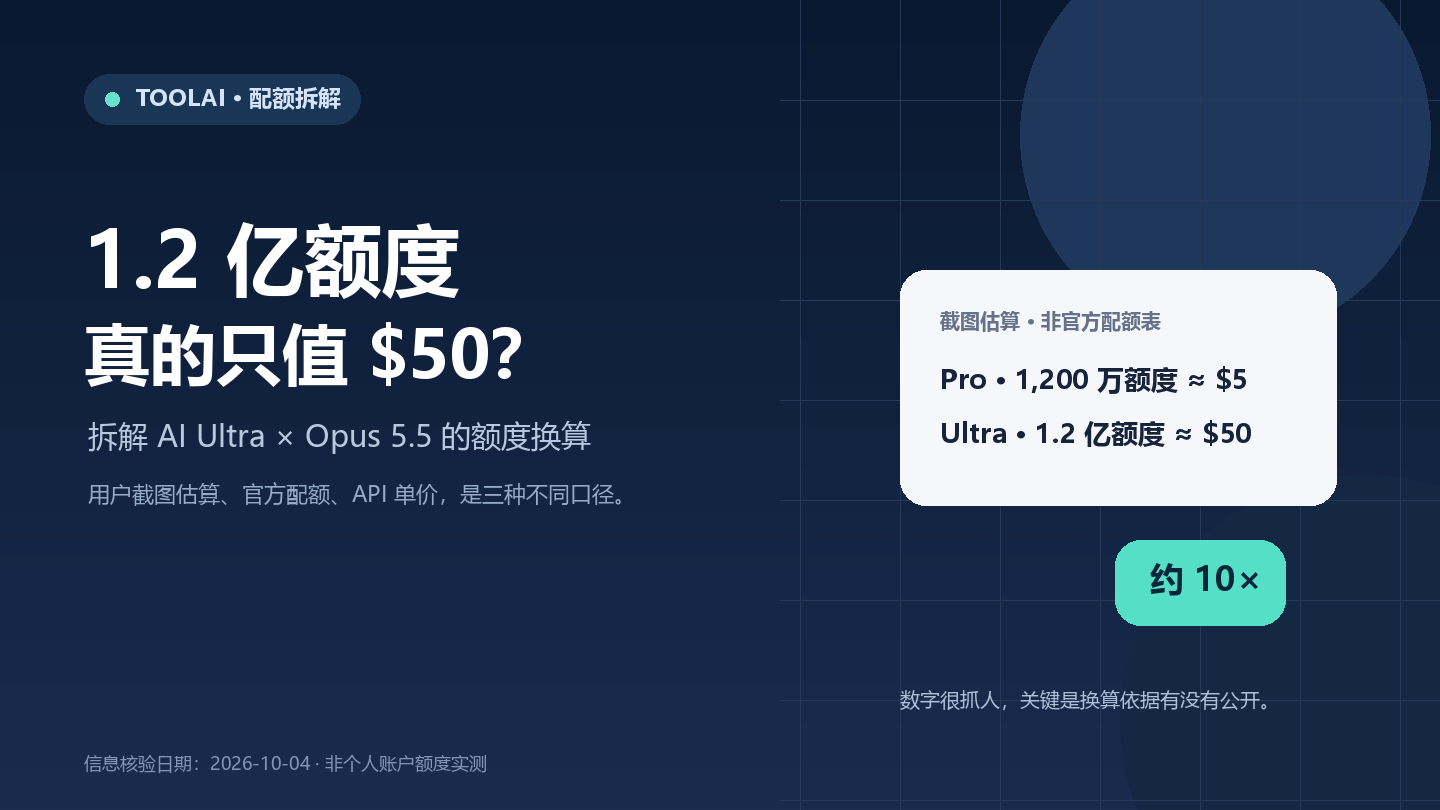
先给判断:这张截图里的 1.2 亿、50 美元和 10 倍,适合当作一位用户对自己账号用量的估算,还不能当作 Google 公布的固定配额。它把 Google 的订阅额度、Antigravity 的模型使用量,以及 Anthropic 的 API 单价放到同一行比较;三者有关联,却不是同一种单位。
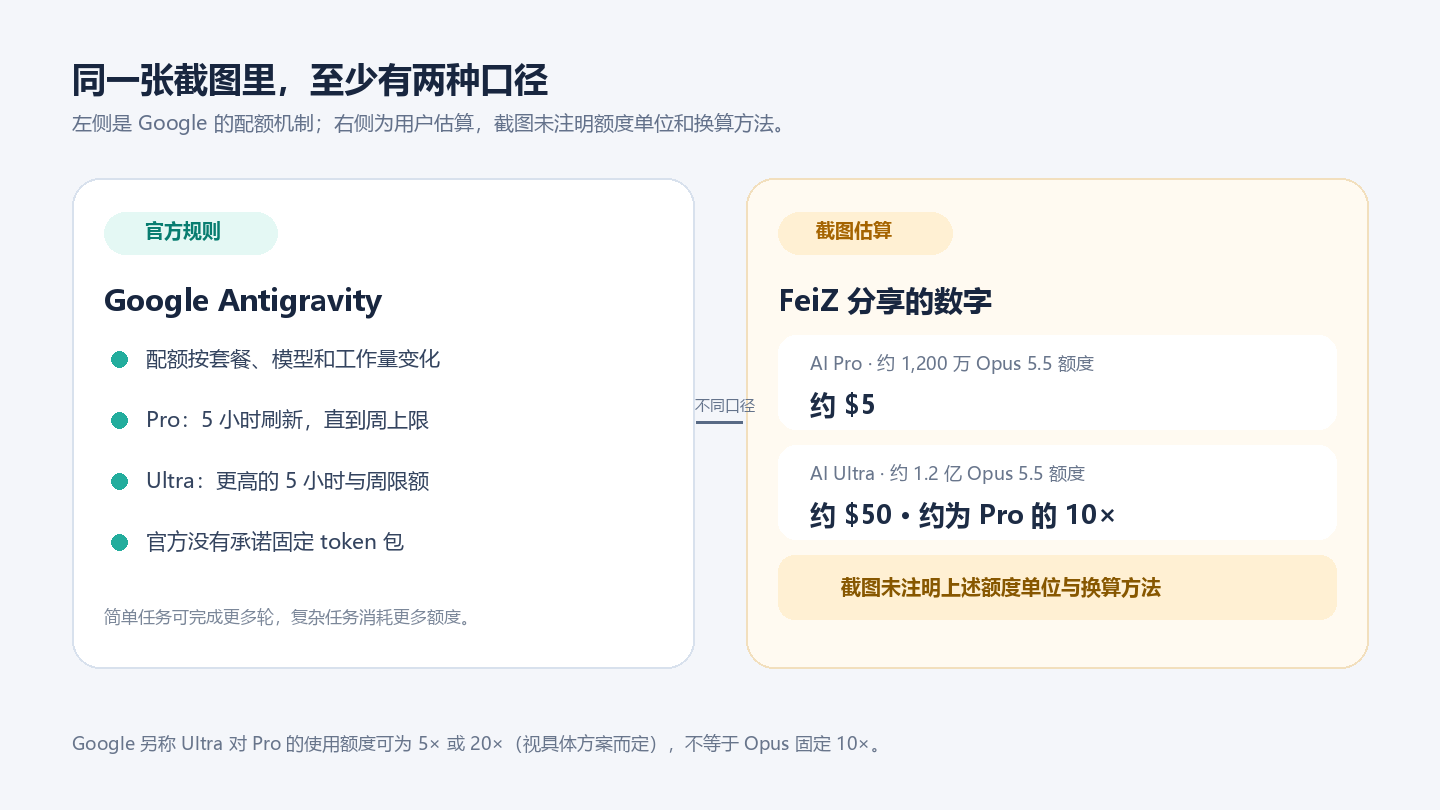
先看清截图口径:原文写的是“1.2 亿 Opus 5.5 额度”,并没有明确标注“额度”单位。下文按 token 展开的 API 价格只是为了说明不同计费类型的差距,属于条件假设,不是对原帖折算方法的确认。
截图署名 FeiZ(@Fei2411)。本文基于用户提供的截图和截至 2026 年 10 月 4 日可查的官方资料核验;我没有登录该用户的 Antigravity 账号复现用量,所以不会把这组数字写成实测结论。
先弄清楚 Google 卖的是什么额度
Google Antigravity 官方计划说明写得很清楚:Pro 用户的额度会每 5 小时刷新,直到碰到周上限;Ultra 获得更高的 5 小时额度和周限额。它还特别说明,底层限额与 Agent 实际完成的工作量相关:任务简单,通常能做更多轮;任务越复杂,消耗越多。官方允许调整限额以适应容量变化。因此,“一个提示词”并不是一个固定大小的计量单位。
Antigravity 的模型列表目前把 Claude Opus 5.5(thinking)列为 AI Pro(非试用订阅)和 AI Ultra 可用;产品界面则为 Claude/GPT 模型显示每周和 5 小时剩余量。Google One 对 Ultra 的总览另称,按具体 Ultra 方案,Gemini 与 Antigravity 的使用额度可为 Pro 的 5 倍或 20 倍。这里没有承诺“Opus 5.5 固定 10 倍”,也没有公布一张可按每周 token 数对照的保证表。
Google Antigravity 计划说明 · 官方模型可用性与额度界面 · Google AI Ultra 权益说明
若把 1.2 亿理解为 token,“等效 50 美元”仍不是自动成立的等式
Anthropic 对 Claude Opus 5.5 公布的 Claude Platform 单价是:每百万新输入 token 4 美元、输出 token 20 美元、缓存读取 token 0.20 美元。如果暂把截图的 1.2 亿额度理解为 1.2 亿 token,并假设全部属于一种计费类型,参考金额会是 480 美元、2,400 美元或 24 美元;按同一假设,1200 万 token 对应 48 美元、240 美元或 2.40 美元。这只是 API 价目表算例,不代表截图用户的真实用量构成。
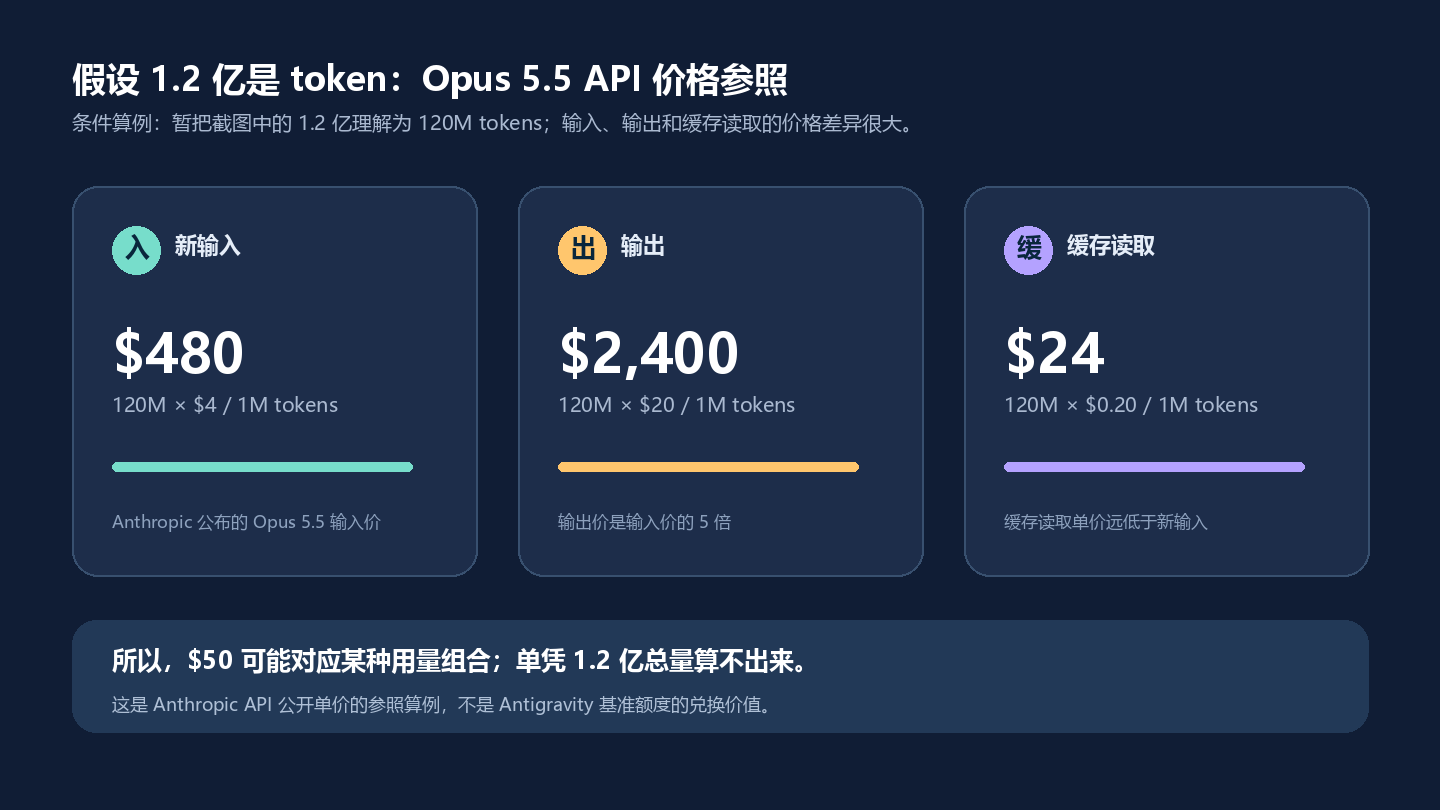
这并不证明截图里的 50 美元一定错。若其“等效额度”来自某种混合用量估算,尤其缓存读取占比很高,50 美元可能是作者采用的一组假设。问题是截图没有同时给出输入、输出、缓存读取的比例,也没有交代折算是按 Anthropic API、Google 的 overage 计价,还是其他方法。少了这些前提,数字精确到“1.2 亿”和“50 美元”反而会制造比证据更强的确定感。
还要注意,Google 对 Antigravity 超出基准额度后的 AI credits,说明按 Google 的标准消费价格扣减;Anthropic 的公开单价适合作为横向参照,不等于 Google 免费基准额度的实际兑换价。Anthropic Opus 5.5 官方定价 · Google 关于 AI credits 的说明
Pro “一个月只能问几句话”也不能从这张图推出
Antigravity 不是简单按月发一袋固定 token。它有 5 小时与每周两类限制;每轮 Agent 任务还可能包括读取上下文、规划、工具调用、检查与重试。一个简短提示词可以启动很长的任务,一个长问题也可能只需要一次短回答。用“问了几句话”衡量额度,既忽略任务大小,也忽略模型的推理强度与 Agent 的工作流。
所以我会把这张截图读成一个有价值的预警,而不是一份完整的套餐评测:它提醒我们第三方模型可能很快消耗基准额度;但它没有证明所有 Pro 用户一个月只能做两三次分析,也没有证明 Ultra 在 Opus 5.5 上一定给 Pro 十倍的同单位额度。要确认这件事,至少要记录套餐和试用状态、模型与 thinking 设置、任务类型、起止时间,以及每次任务前后的 5 小时和周剩余额度。
我的购买判断:看“验收通过的任务”,别只看 token 折算
如果你的主要工作就是长期跑 Claude Opus 5.5 Agent,我不会只因为一张“等效 50 美元”的估算就推荐买 Ultra。更稳妥的做法是用 5 到 10 个可重复任务做一周小样本:固定模型与设置,保留输入材料和验收标准,记下每次任务前后的两种额度、完成时间、返工次数,以及最终通过验收的任务数。最后比较“每个验收通过任务消耗多少额度”,而不是只数提示词或 token。
若你主要用 Gemini,并且确实会用 Antigravity、Flow、存储等其他权益,Ultra 的价值可能来自整套产品组合;若你主要想买 Opus 用量,就该用自己的工作样本和真实限额比较 Claude 官方订阅、Google 基准额度与按量付费,别把计划档位的综合倍率误当成单模型的等比例 token 套餐。
截图里“希望 Gemini 4 支撑起来”是期待,不是当下可购买的功能。核验时 Google Antigravity 官方模型页列出 Gemini 3.8 Flash、3.7 Flash、3.6 Flash、3.1 Pro,以及 Opus 5.5 等模型;截至本文核验日,页面没有列出 Gemini 4。之后是否上线,应等正式模型列表更新再判断。
我的最终评价:这条帖子的方向值得关注,精确换算则需要打折看。对订阅用户最有用的问题不是“Ultra 值不值 50 美元 API token”,而是“在我的工作负载里,它每周能多完成多少个可验收的任务”。这张截图提出了问题,还没有公开足够数据让别人复算答案。
资料来源:Google Antigravity Plans · Google Antigravity Models · Google AI Ultra Benefits · Anthropic Claude Opus 5.5
核验日期:2026-10-04。截图数字按用户自述呈现,未获 Google 或 Anthropic 官方确认;API 金额仅为公开单价的算例,不等同于 Antigravity 基准配额价值。本文是资料评析,不是账号额度实测,也不构成购买建议。