
Gemini 4 Carbon 最值得关注的实际用途,是复杂编程和有人复核的工具任务。现有证据也揭示了取舍:相比 Argon 的进步,不等于在每个工程测试中都领先;知识成绩提高,也可能伴随更少的谨慎作答。对于建设网站、维护软件和发布研究内容的人,应该比较的是成品质量,以及把事情真正完成所需的成本。
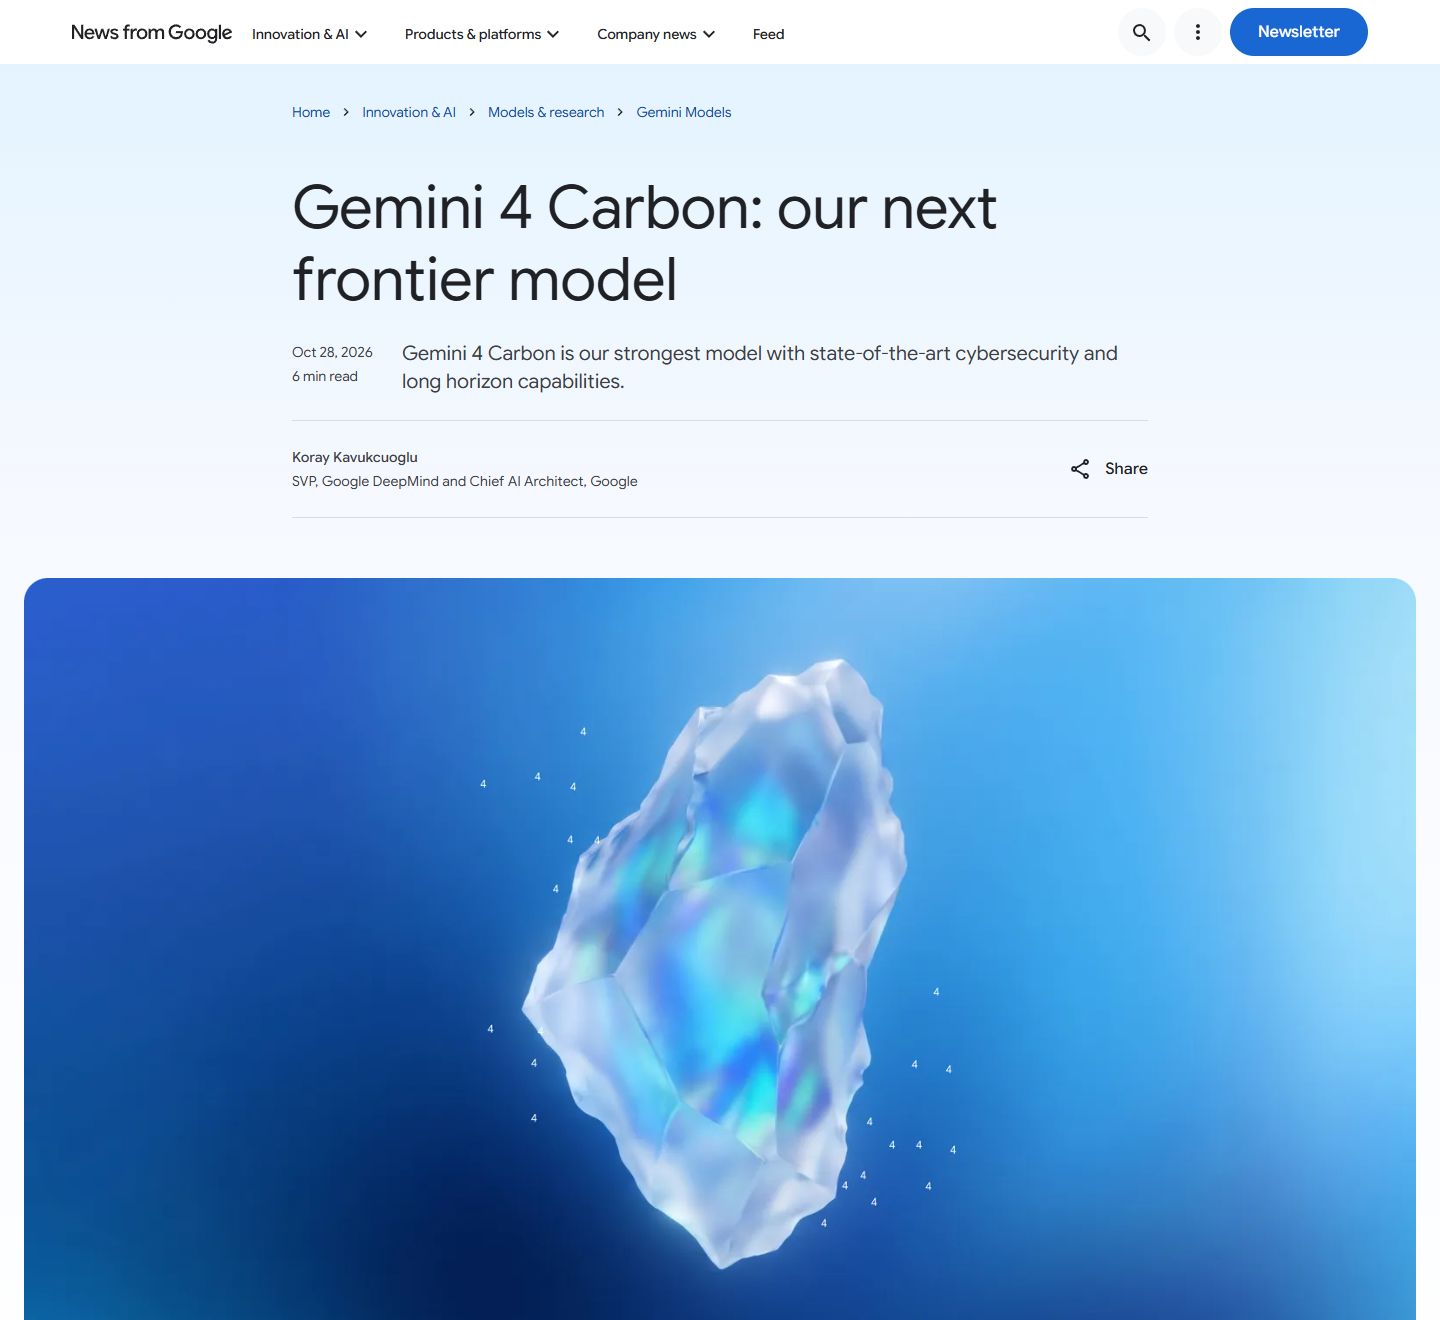
Google 于 2026 年 10 月 28 日发布 Carbon。本文在北京时间 10 月 29 日核对资料,以下判断基于公开评测与方法说明,尚未包含本站上手测试。首批访问面向部分网络防御人员,并通过 Fairwind 逐步扩展至可信合作伙伴,面向更多用户的产品开放仍在后续安排中。模型出现在榜单上,不代表普通开发者账号已经能够调用。Google 发布公告。
四组数据,分别解释实际表现的不同侧面
本文引用的 Arena 与 Artificial Analysis 成绩,对应 Gemini 4 Carbon 的 High 思考配置。
| 测试对象 | 公开结果 | 对实际工作的启示 |
|---|---|---|
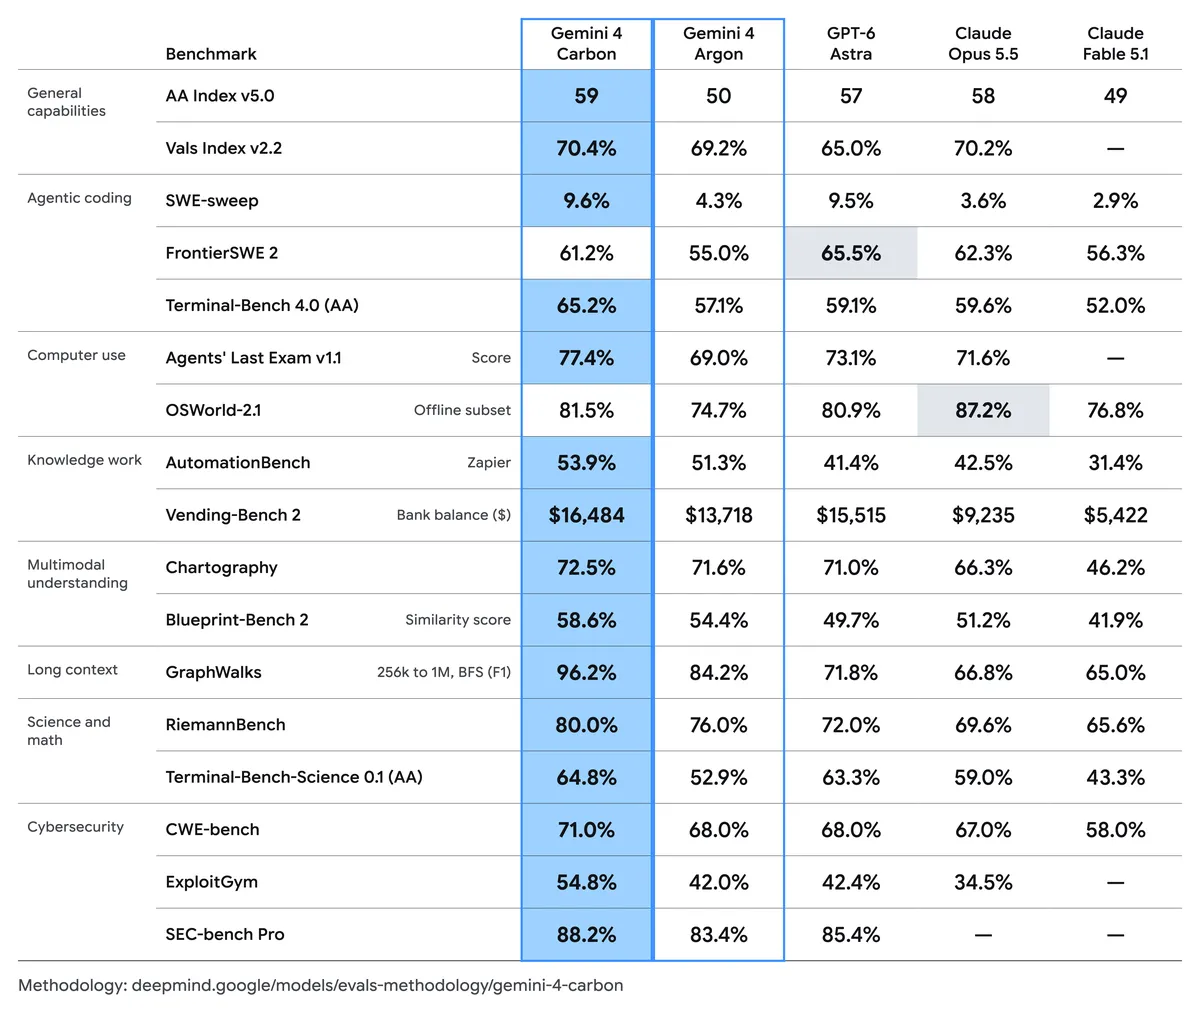
| 软件工程:FrontierSWE 2 | Carbon 61.2%;Argon 55.0%;GPT-6 Astra 65.5%;Opus 5.5 62.3%。 | Gemini 自身有明显进步,这一测试中仍有其他模型领先。 |
| 桌面操作:OSWorld-2.1 离线子集,部分得分 | Carbon 81.5%;Opus 5.5 87.2%。 | 具备较强操作能力,同时存在未完成的情况和成绩更高的选择。 |
| 知识问答:AA-Omniscience v1.1 | Carbon 正确率 58%;幻觉指标 11%,Argon 为 4%。 | 知道多少,以及不知道时是否克制,需要分别判断。 |
| Agent Arena 实际会话 | Carbon 暂列第 2,标记 Preliminary;净改善为 +16.04 ± 1.00 个百分点,任务成本中位数 1.74 美元。 | 这一快照中,较强的实际交互表现伴随着低于榜首的任务成本。 |
来源分别为 Google 基准表、Artificial Analysis 评估及 Agent Arena。智能体榜页面标注日期为 10 月 28 日,本文于 10 月 29 日读取。这些评估有各自的方法,不能合并为一个统一总分。
编程:升级幅度有意义,具体任务仍决定选择
Carbon 的 FrontierSWE 成绩比 Argon 高 6.2 个百分点。对已经使用 Gemini 的团队,代码库维护和复杂排错因此成为值得评估升级的实际用途。不过,这不意味着 Carbon 能修好任何应用中 61.2% 的 bug,也不能据此判断它的所有编程能力都超过 Astra 或 Opus。
Google 的总表汇集了不同评估来源。方法说明写明,FrontierSWE 数据来自 Proximal 的公开榜单;其他项目包括 Google 自测、供应商报告和外部评估。大部分 Gemini 结果采用最高思考设置、单次尝试,并列出了例外。OSWorld 使用的是 82 个任务的离线子集,Gemini 成绩取三次运行中的最高结果。这不是所有模型在完全相同条件下接受的一次独立统测。评估方法说明。
网站团队真正需要的交付物,是保留现有行为、能处理异常路径、重复执行仍然正确的补丁。Carbon 的工程成绩支持把它列入这类任务的候选。一个漂亮的页面预览,却不能说明权限控制、数据保存和回归风险都已处理。检查最终代码差异,比仅凭模型自信地说“完成了”更有判断价值。
研究与内容:知识更强,事实仍要能追溯
Artificial Analysis 给出的 AA-Omniscience v1.1 正确率为 58%,高于 Argon 的 48%。Carbon 的 11% 幻觉指标有特定分母:错误答案数,除以错误、部分正确和未尝试回答的数量之和。它不是全部问题的错误比例,也不能倒推为 89% 正确率。指标定义。
在工具对比文章里,一条编造的计费条件,就可能抵消好几段流畅介绍的价值。Carbon 适合被考虑用于整理已有产品资料、组织比较维度和起草介绍;公开知识评估并不支持取消来源检查。保留原始价格页,区分检索到的事实和编辑判断,缺少信息时允许草稿明确写出未知。真正的收益,是减少研究和编辑工作,同时不增加无依据的内容。
智能体:成本有吸引力,完成质量也存在取舍
本次读取的 Agent Arena 数据包含 26,511 次 Carbon 会话。榜首 Opus 5.5 Max 的净改善为 +20.94 ± 2.15 个百分点,任务成本中位数为 6.66 美元。Carbon 的观测成本较低,综合结果指标也较低。“净改善”是相对随机分配形成的平均模型基线,综合多个行为信号得到的差值,不是任务成功率。实时榜单与排名方法。
Arena 最多统计每个会话的前三个任务,以降低前文累积对成本的影响。这里的中位数既不是一次 API 请求的固定费用,也不是对你实际业务的报价。任务成本方法。
这种组合,对能够复核的研究、文档制作和编程迭代很有吸引力。若要让模型无人值守地操作桌面,OSWorld 的差距则更加相关:一次较便宜的会话,仍可能留下填错的字段、未保存的记录或导出失败。选择模型时,人工复核和恢复操作的时间也应计入成本。
同时计算首发价格和完整工作流的费用
Google 公布的首发价格为每百万输入 token 2 美元、每百万输出 token 10 美元;首发优惠结束后分别为 4 美元和 20 美元,没有列出明确结束日期。定价及脚注。
举一个纯计算示例:10 万个未缓存输入 token,加 2 万个计费输出 token,按首发价格为 0.40 美元,后续价格为 0.80 美元。这不包含额外调用和工具费用。真实智能体可能重新读取文档、重复执行步骤,因此单次输入输出的估价不能直接充当项目预算。Arena 与 Artificial Analysis 的任务定义也不同,不能把两家的美元数字拼成适用于所有业务的节省比例。
哪些工作值得把 Carbon 列入候选
- 代码库维护和有人复核的编程:属于较有说服力的候选用途,尤其适合与现有 Argon 工作流比较。重点看最终被接受的补丁和审查时间。
- 基于资料的研究及多语言草稿:适合承担综合与组织工作,价格、功能和引文仍保留事实核对。
- 包含关键最终操作的桌面任务:发布、发送或修改重要记录之前保留复核。当前离线基准无法证明它在真实业务系统中能够可靠地全程自主操作。
现有证据支持把困难、可复核的工作交给 Carbon 评估。是否切换生产模型,应由同一批重复任务中更少的返工,或更低的总体投入来决定。保留输入、输出与验收条件,才能用实际完成的工作做选择,而不是依赖一次令人印象深刻的演示。