
Intel Arc Pro B70 32GB 正成为本地大模型圈值得关注的一张显卡。围绕 XeStrata 的一组新测试显示,Qwen3.8-Flash-Next 在单张 B70 上已经能够以较流畅的速度完成代码、结构化提取和长文本任务。关键变化,是软件开始更有效地利用这张卡的硬件。
这条消息背后,有两组不同的数据
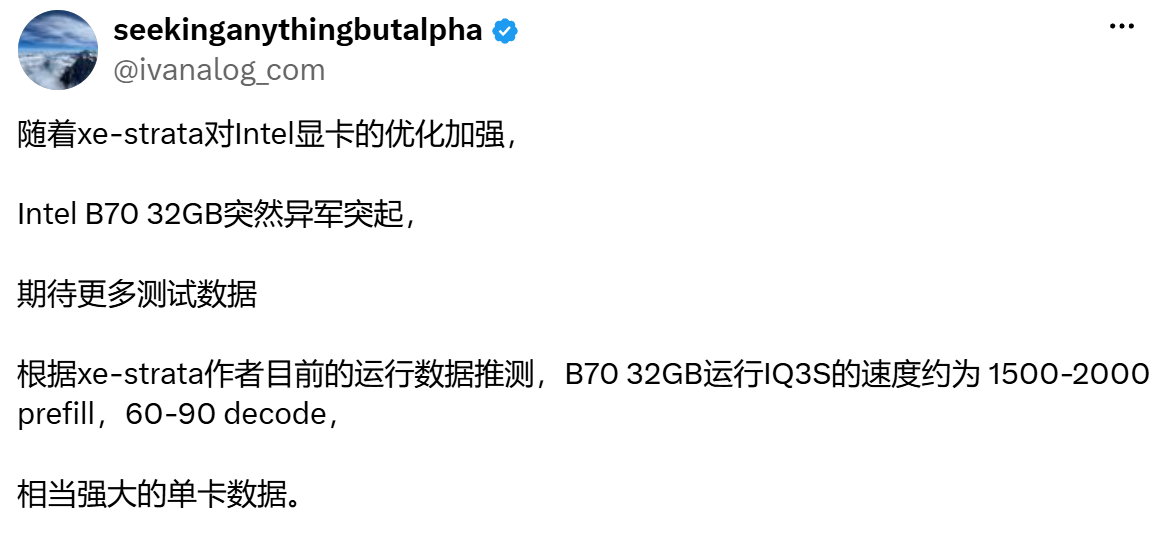
seekinganythingbutalpha 的原帖提到,依据 XeStrata 作者的运行数据推测,B70 32GB 运行 IQ3S 的速度约为 1500–2000 tokens/s prefill、60–90 tokens/s decode。这个范围表达的是预期表现,不能直接当作所有配置都能达到的成绩。
它引用的 Clay Shoaf 实机测试更具体:同一张 B70 上,XeStrata 运行 Qwen3.8-Flash-Next IQ3_S,在四类任务中的生成吞吐量为 64.5–69.8 tokens/s。其测试机器搭配 Core i3-12100、64GB 内存和 PCIe 3.0 ×16,系统为 Xubuntu 26.04。
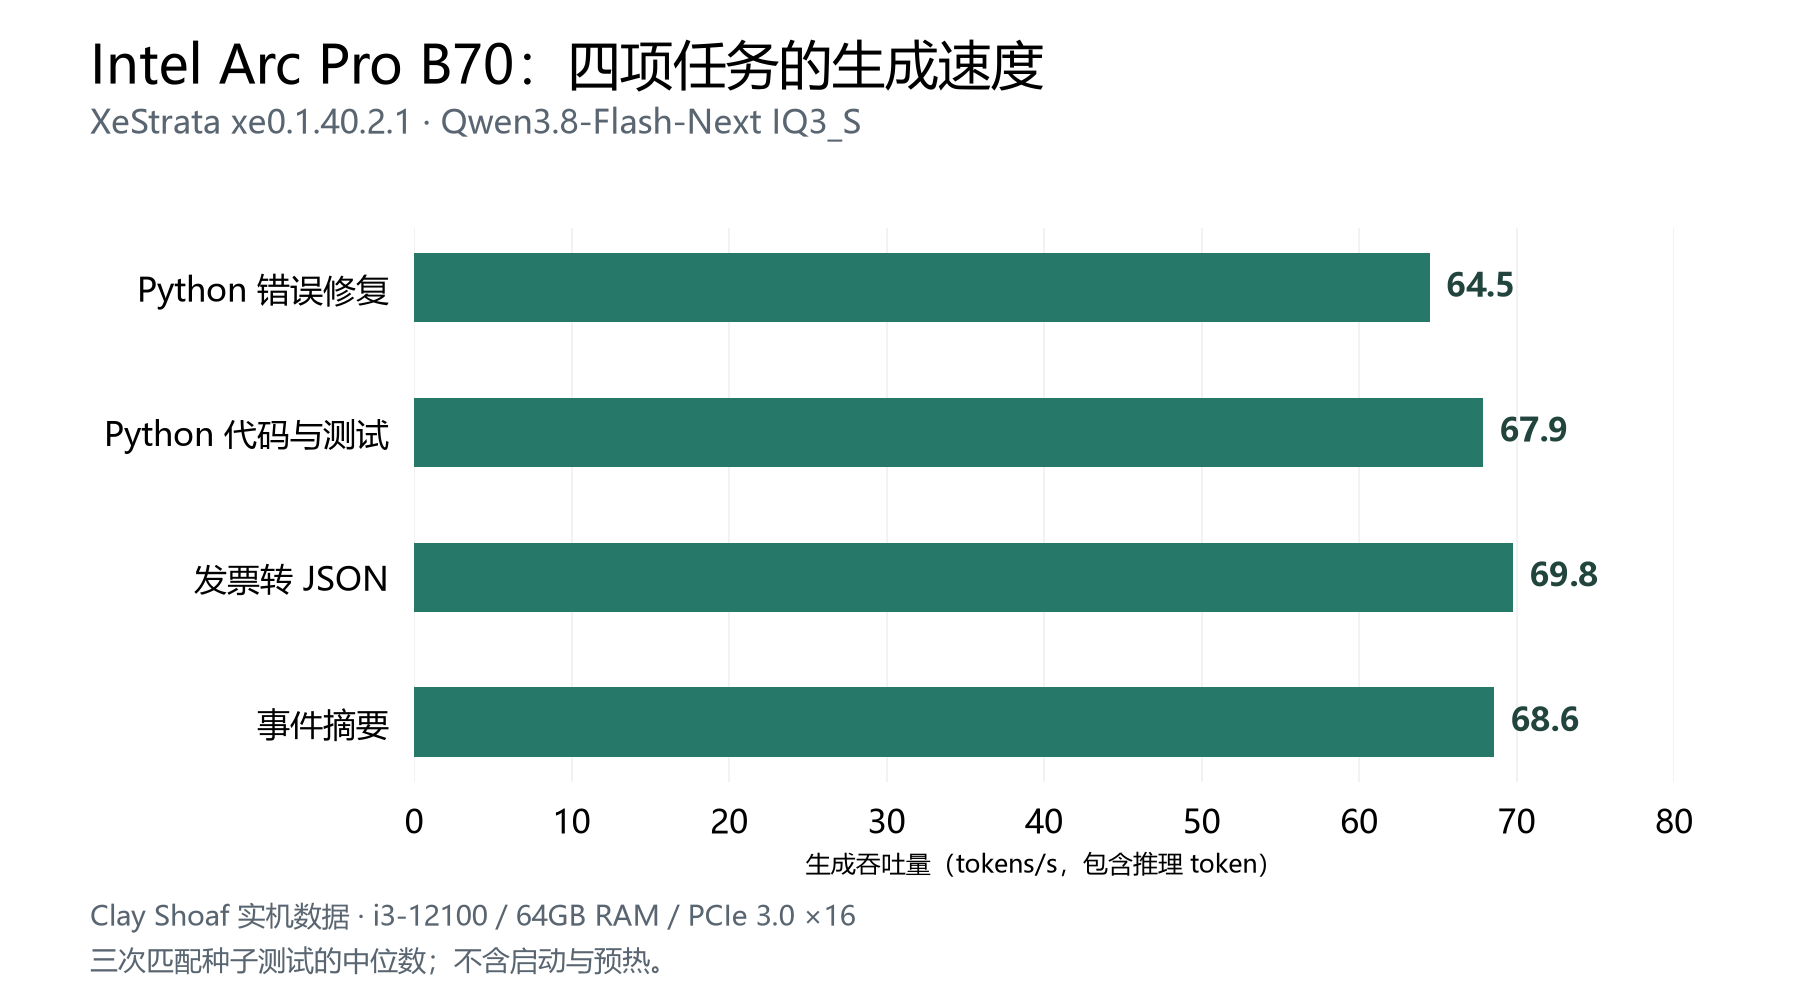
图中 XeStrata 使用 256K 上下文配置、8-bit KV,并开启支持的 MTP。每项任务使用三个匹配的随机种子,取中位数,启动和预热不计入成绩。256K 是配置上限,并不表示每个请求都输入了 256K 文本。
1500–2000 的输入速度,应该怎样理解?
Prefill 是读取输入,decode 是逐步生成回答。一段很长的材料先经过 prefill,之后才进入持续输出。两者都以 tokens/s 表示,却对应不同的等待过程,不能把更大的 prefill 数字理解为每秒输出几千字。
XeStrata xe0.1.40.2.1 发布记录使用 Qwen3.8-Flash-Next IQ3_XXS 测试 B70:4K 输入下为 1501 tokens/s prefill、82.4 tokens/s decode;32K 输入下为 2310 和 79.5;64K 输入下为 1967 和 74.3。这与原帖描述的速度区间有交集,但量化格式及测试方法不同,不能拼成一份 IQ3_S 成绩单。
这组项目测试与同机的 Strata v0.1.41 SYCL 版本比较,采用代码代理输入、256 个输出 token,以及两次交替运行的中位数。它说明软件实现可以显著影响同一张卡的表现。
单卡运行,仍然需要整台电脑配合
XeStrata 将 Strata 的 GPU 计算迁移到 SYCL 和 Level Zero,并利用显存、系统内存与专家调度来运行大模型。单张 32GB 显卡参与推理,不代表整个 125B 模型全部装进 32GB 显存。
对准备搭建本地 AI 的用户,内存容量、PCIe 链路、量化文件和驱动环境都值得与显卡一起考虑。现有 README 以 Linux 为运行平台;选择安装包前,应对照所用发行版和当前版本要求。
接下来值得观察的是日常使用
除了速度,启动可靠性也在影响体验。Clay Shoaf 的后续记录提到两次模型启动故障,随后通过运行选项完成测试和额外启动检查。开发者回应下一版本应包含修复,并请用户以默认配置验证。这说明具体版本与运行参数仍然重要。
B70 的吸引力在于,32GB 显存与持续改进的软件开始形成一套有实际任务数据支撑的本地推理方案。对于代码助手、文档处理和私人知识库,更有价值的下一步,是观察多轮对话、长时间运行、首字延迟和回答质量是否同样稳定。硬件的可用性,最终要体现在这些每天都会发生的操作里。