
观点文章 · ToolAI 编辑部 · 2026 年 10 月 4 日
封面|从答案到成果,中间还有一座桥。ToolAI 使用 AI 生成的原创概念配图,非 Google 官方产品图。
看完 Gemini 4 Argon 的发布资料,我脑子里冒出的第一个问题有点扫兴:它能让我少返几次工?
模型发布会总能给我看一份漂亮答卷。但我更想看另一张纸:哪些要求已经核对,哪些地方仍不确定,改坏了什么,最后谁来验收。如果一个 Agent 忙了四十分钟,交给我的仍是一份需要从头检查的半成品,那四十分钟到底是谁省下来的?
我看好 Argon 所代表的长任务能力,也认为下一轮 AI 产品的竞争,会越来越取决于谁能把验收做好。这两件事必须一起谈。
先把 Argon 放回真实的位置
Google 于 9 月 30 日公布 Gemini 4 Argon,强调复杂长流程任务。当前先向 Fairwind 受信网络防御者等开放,后续计划优先覆盖付费 API 客户与 Google AI Ultra 用户,尚未给出全面开放日期。公告写的是最高 100 万输出 token;引入价为每百万输入 2 美元、输出 10 美元,之后为 4 / 20 美元。来源:Google 发布公告。
这意味着它已经正式公布,但不能因此默认普通开发者今天就能调用。我没有拿到 Argon 的实测权限;本文讨论公开证据与产品判断,不包装成上手评测。尤其是“输出上限”,不能顺手改写成“可输入多少资料”,具体 API 限制仍应看正式文档。
让我停下来的,是 94.04% 和 19.58%
Vals 的 Harvey 法律 Agent 评测给 Argon 列出两项结果:平均检查项达成率 94.04%,完整任务通过率 19.58%(两位模型评审的任务通过率均值)。评测要求一项任务的所有标准通过,才算整项解决。这是两个不同口径,不能通过相除推算通用成功率,也不能代表所有工作的表现。来源:Vals 原始榜单与方法说明(核查于 2026-10-04)。
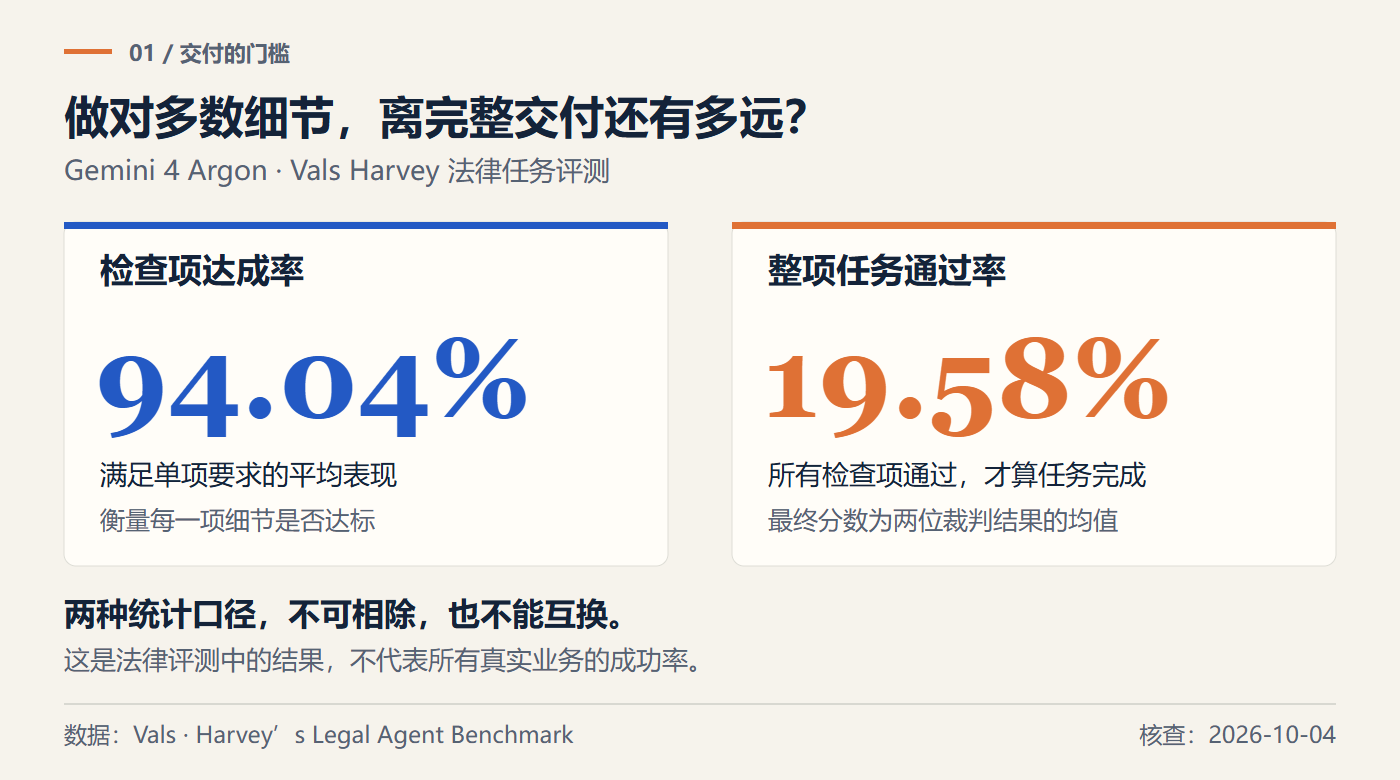
我不把这理解成“Argon 不行”。恰恰相反,这组数字让我觉得,我们终于在讨论一个比聊天更接近工作的难题。
想象一个很普通的交付:更新网站上的模型价格。模型可能找到了官方来源,算对了费用,文案也写得顺。但如果它漏改了缓存里的旧价格,或者把预览版本标成全面可用,读者看到的结果依然可能是错的。这里的难点不在于再多写三段解释,而在于把最后几处遗漏查出来。
这是假设的业务例子,不是我对 Argon 做过的测试。它说明了我的评价标准:完成度要落到交付物上,不能只落在一段自信的总结里。
能想得更久,我欢迎;一直想下去,我不买单
我当然希望模型有耐心。排查一个跨模块故障、梳理几十份互相矛盾的文档,本来就不该只靠几秒钟的回答。持续推理值得投入,前提是每一轮行动都能增加证据、缩小问题,或者产出可以核验的东西。
我担心的是另一种体验:进度条一直走,日志越来越长,用户却不知道它离结束更近了没有。模型的工作时长,最后变成了用户不敢离开的等待时长。
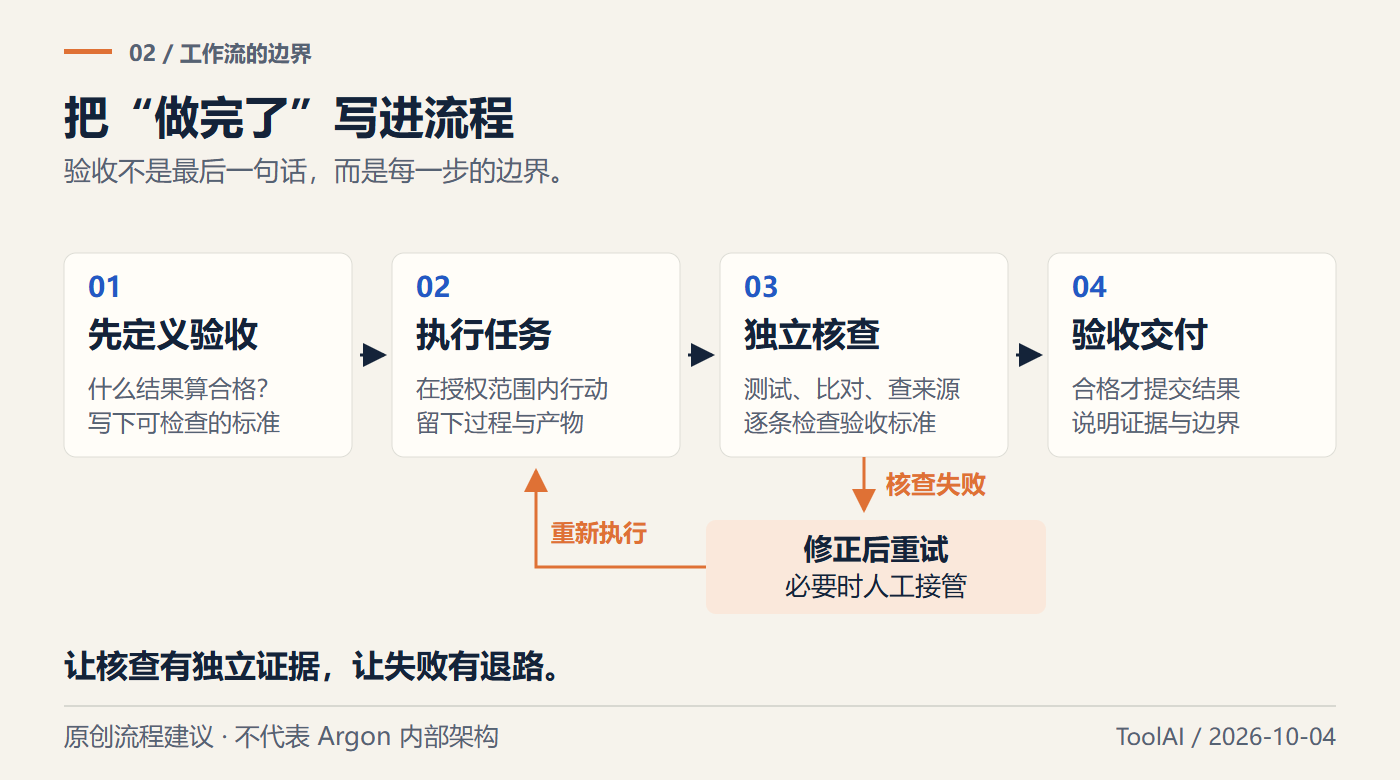
如果让我设计基于 Argon 的产品,我会先做三件很朴素的事:开工前写清验收条件;执行中保留可检查的阶段成果;连续尝试仍无进展时,带着证据请求人工接管。我也会把失败出口做得和成功按钮一样认真。
每百万 token 很便宜,未必代表这件事做得便宜
单价是采购入口,却还不是业务答案。一个任务可能消耗多轮推理、工具调用、重试和人工复核;便宜的一次调用,也可能带来昂贵的一下午。
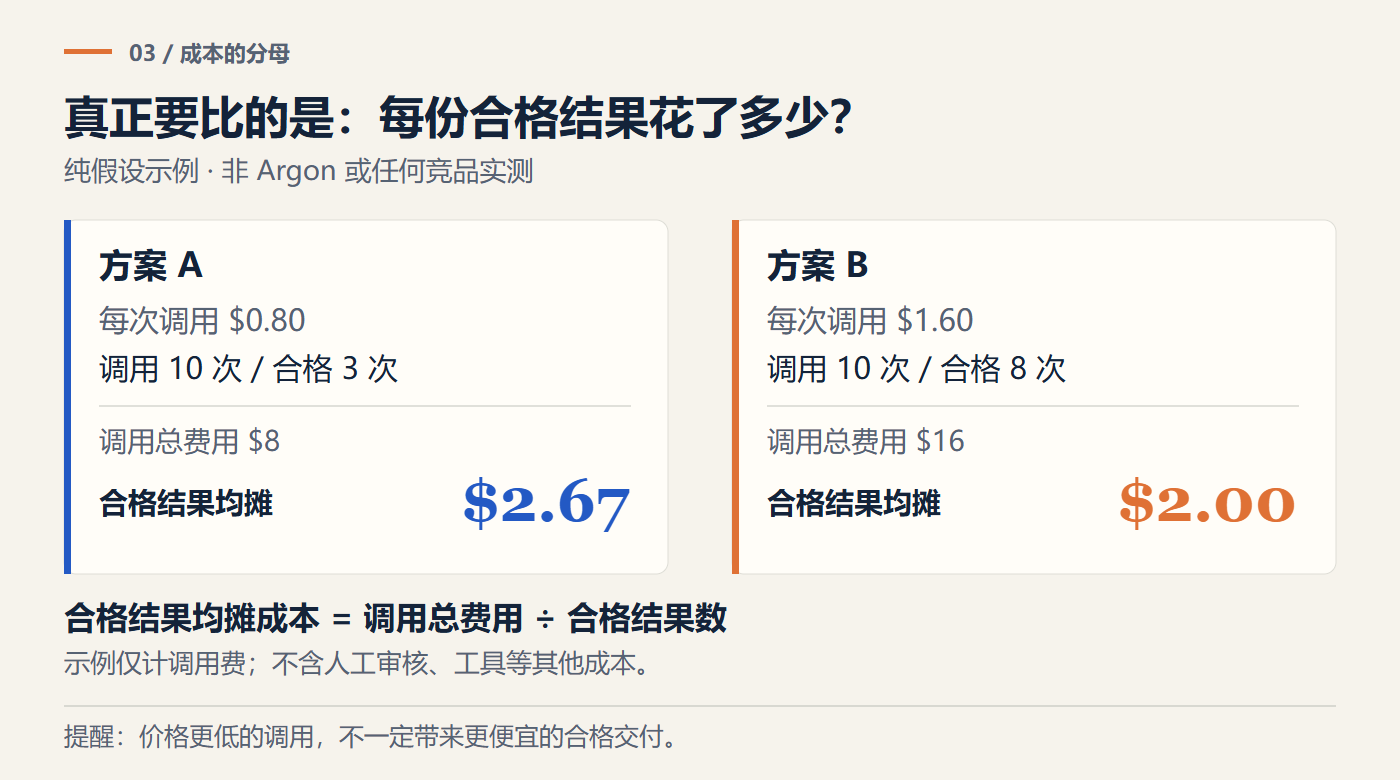
我会把另一项指标放在单价旁边:每个通过验收的任务成本 = 这批任务的总成本 ÷ 合格交付数。总成本应该包含失败尝试;用于真实采购时,还应计入工具费用和人工检查。若没有任何合格交付,就不能算出一个好看的有限单价。
做个纯假设:方案 A 每次 0.80 美元,跑十次,三次合格,调用费用摊到每个合格结果上约为 2.67 美元。方案 B 每次 1.60 美元,十次有八次合格,均摊为 2.00 美元。这个例子没有使用 Argon 或任何竞品的实测数据,只说明为何我愿意为更可靠的完成结果付更高单次费用。
反过来,如果任务很简单、检查很轻松,我也不会为了“最强模型”支付额外成本。模型选型应允许普通任务用普通配置,让复杂任务有理由升级。
真拿到权限后,我会先让它处理一小块旧系统
我最想试的场景,是一段边界清楚、历史包袱真实的代码维护:让它读懂现有实现,修复一个可复现的问题,保留原有行为,并给出回归结果。这比让它从零生成一个漂亮演示更能回答我的问题。
我会先选十个有历史答案的小任务,保留现有方案作对照;开始前固定通过标准,结束后记录合格数、人工介入时间、总费用和耗时。测试材料不变,不能中途把要求放松到“看起来差不多”。
我的采用条件也很具体:它要么提高合格交付比例,要么明显减少人工复核时间,且总成本在我能接受的范围内。如果它只是写得更长,却让我花更多时间找遗漏,我会把它留在辅助位置,继续观察。
我期待的是一份能签收的成果
Argon 让我更期待长流程 Agent,也让我更在意验收这件小事。一个系统越能独立行动,我们越需要知道它做完了什么、依据是什么,以及哪些地方仍需要人来判断。
我愿意为一个读得懂旧代码、遇到问题会停下来核查、最后交出合格改动的模型付钱。至于它过程中用了多少令人惊叹的推理长度,那是技术进步的空间,还不是我收到的价值。
下一次模型说“已完成”,我希望它递过来的,是一份经得起签收的成果。
资料与阅读:Google 发布公告 · Vals Harvey 评测及方法 · Gemini API 模型文档 · ToolAI Gemini 模型资料。
本文基于截至 2026-10-04 的公开资料。官方发布信息、第三方评测结果、编辑观点及假设算例已分别标明。封面为 AI 生成概念图,其余为 ToolAI 原创信息图。